pgvectorとは、PostgreSQLにベクトル型(vector)と近傍検索用のインデックス(HNSW、IVFFlat)を追加する拡張機能です。社内文書のRAGを作るとき、「誰がどの文書を見てよいか」という権限を検索クエリのWHERE句にそのまま書けることが、専用ベクトルDBではなくPostgreSQLを選ぶ最大の理由になります。
ここではPostgreSQL 17 + pgvectorをDocker Composeで立て、Python 3.12とOllamaの埋め込みモデル(bge-m3)で社内文書を取り込み、グループ権限で絞った検索結果をLLMに渡して出典付きで回答させるまでを実装します。権限フィルタが「検索後」ではなく「検索の中」で効かなければならない理由、HNSWインデックスとWHERE句の相性、埋め込みモデルを変えると全部作り直しになる点など、設計判断の根拠を先に示してからコードに入ります。
この記事でわかること
- 取り込み→埋め込み→検索→生成の各段階で、何をどのテーブルに持つか
- ACLをSQLのWHERE句に入れる理由と、後段フィルタで起きる2つの事故(漏えい・件数不足)
<=>演算子とHNSWインデックス、フィルタ併用時にhnsw.iterative_scanが必要になる仕組み- チャンク分割の基準、埋め込み次元の固定、根拠のみで答えさせるプロンプトの書き方
- 30問のテストセットで検索と生成を分けて評価する方法と、実際に出るエラー5種
全体アーキテクチャと「権限は検索の中で」という原則
処理は2系統に分かれます。オフラインの取り込み系は、文書を集める → チャンクに分割する → 埋め込みモデルでベクトルにする → PostgreSQLに保存する、の4段階です。オンラインの応答系は、質問をベクトルにする → 権限で絞りながら近いチャンクを取る → 取れたチャンクを根拠としてプロンプトに入れる → LLMが回答して出典番号を付ける、の4段階です。埋め込みモデルは取り込みと検索で必ず同じものを使います。
[取り込み] 文書 -> チャンク分割 -> /api/embed (bge-m3) -> documents / chunks テーブル
[応答]     質問 -> /api/embed -> SELECT ... WHERE allowed_groups && :groups ORDER BY embedding <=> :q LIMIT 8
                -> プロンプト組み立て -> /api/chat (gemma4:12b) -> 回答 + 出典 [1][2]
権限フィルタを検索SQLのWHERE句に入れる理由は2つあります。1つ目は漏えいの経路を断つためです。「まず近い順に取ってから、アプリ側で権限のないものを捨てる」方式では、捨てる前のチャンク本文がアプリのメモリやログに載り、実装ミスひとつでLLMに渡ります。2つ目は件数の保証です。上位8件を取ってから捨てると、ユーザーに権限のある文書が9位以下に沈んでいた場合、回答に使える根拠がゼロになります。WHERE句で絞れば、データベースが「権限のある中での上位8件」を返します。
権限の主体はユーザー個人ではなくグループにします。検索時にIdP(Entra IDなど)から取得したユーザーの所属グループを配列で渡す設計にすると、人事異動でテーブルを触る必要がなく、文書側は「閲覧を許すグループ」だけを持てば済みます。専用のベクトルDBを選ぶべきかは、次の軸で判断します。
| 観点 | pgvector(PostgreSQL) | 専用ベクトルDB(Qdrant、Milvus、Weaviateなど) |
|---|---|---|
| 権限フィルタ | WHERE句、JOIN、行レベルセキュリティがそのまま使える | 製品ごとのフィルタ構文。JOINは不可でメタデータを非正規化する |
| 運用 | 既存のバックアップ・監視・権限管理に相乗りできる | もう1系統の運用対象が増える |
| 規模の目安 | 数百万チャンクまでは単一ノードで十分 | 数千万〜億、複数ノードでの水平分割が前提 |
| 向く判断 | 社内文書、既にPostgreSQLを運用している | 全文検索基盤や大規模レコメンド、超低遅延が要件 |
環境構築:PostgreSQL 17 + pgvector と Python
services:
  db:
    image: pgvector/pgvector:pg17        # PostgreSQL 17 に pgvector を同梱した公式イメージ
    environment:
      POSTGRES_DB: rag
      POSTGRES_USER: rag
      POSTGRES_PASSWORD: rag-password    # 本番では .env と secrets に分離する
    ports:
      - "127.0.0.1:5432:5432"
    volumes:
      - pgdata:/var/lib/postgresql/data
volumes:
pgdata:docker compose up -d
docker compose exec db psql -U rag -d rag -c "CREATE EXTENSION IF NOT EXISTS vector;"
docker compose exec db psql -U rag -d rag -c "SELECT extversion FROM pg_extension WHERE extname = 'vector';"
# 期待: 0.8.0 以上(iterative_scan はこの版で追加。執筆時点の最新はさらに上)
python3 -m venv .venv && source .venv/bin/activate
pip install "psycopg[binary]" ollama
ollama pull bge-m3
ollama show bge-m3 | grep -i "embedding length" # 期待: embedding length 1024埋め込みの次元数は列定義に固定されるので、ここで確認した1024をスキーマに書きます。bge-m3は多言語対応で入力8192トークンまで扱え、執筆時点でOllamaライブラリから取得できる中では日本語の社内文書に使いやすい選択です。同じ1024次元の qwen3-embedding:0.6b も代替候補になります。日本語特化の埋め込みモデル(名古屋大学のRuriなど)はGGUFを自分で取り込む形になります。
テーブル設計:ACLをメタデータとして持つ
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE documents (
    id             bigserial   PRIMARY KEY,
    title          text        NOT NULL,
    source_uri     text        NOT NULL UNIQUE,     -- 再取り込みの突き合わせキー
    owner          text        NOT NULL,
    allowed_groups text[]      NOT NULL DEFAULT '{}',  -- 閲覧を許すグループ(IdP のグループ名)
    content_hash   text        NOT NULL,            -- 変更検知用 SHA-256
    updated_at     timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE chunks (
    id          bigserial PRIMARY KEY,
    document_id bigint    NOT NULL REFERENCES documents(id) ON DELETE CASCADE,
    chunk_index int       NOT NULL,
    content     text      NOT NULL,
    embedding   vector(1024) NOT NULL,              -- bge-m3 の次元。モデルを変えたら列ごと作り直す
    UNIQUE (document_id, chunk_index)
);

CREATE INDEX chunks_embedding_hnsw      ON chunks    USING hnsw (embedding vector_cosine_ops);
CREATE INDEX documents_groups_gin       ON documents USING gin  (allowed_groups);
CREATE INDEX chunks_document_id_idx     ON chunks    (document_id);
documents.allowed_groups は text[] で、&&(配列の重なり)演算子で「ユーザーの所属グループのどれかが含まれる」を判定します。この演算子はGINインデックスで高速化できます。ACLは文書単位に置き、チャンクには持たせません。権限が変わっても埋め込みを作り直す必要がなく、UPDATE一発で済むからです。
文書が数万件を超えて権限の組み合わせが複雑になる場合は、document_acl(document_id, principal) の中間テーブルに正規化する設計もあります。ただしJOINが1つ増えて検索SQLも複雑になるので、まず配列で始めて、困ってから変える順で問題ありません。source_uri を一意にして content_hash を持たせておくと、再取り込み時に「変わっていない文書はスキップ」ができ、夜間同期のコストが下がります。
チャンク分割の考え方
チャンクは「検索の単位」であり「LLMに渡す根拠の単位」でもあります。小さすぎると「前条の規定にかかわらず……」のように主語を失った断片になり、大きすぎると1チャンクに複数の話題が混ざって検索精度が落ちます。日本語の規程やマニュアルなら400〜800文字、オーバーラップ80〜150文字が出発点です。
文字数で機械的に切る前に、段落や見出しの境界を優先します。さらに各チャンクの先頭に「文書名 > 章 > 節」のようなパンくずを付けておくと、「申請手順」だけのチャンクが「何の申請か」を持てるようになり、検索と生成の両方が安定します。表は1行ずつテキスト化し、見出し行を各行に付けるのが扱いやすい形です。下のコードは段落優先の最小実装で、パンくずとして文書名だけを付けています。
埋め込みの生成と取り込み(Python)
import hashlib
import sys
from pathlib import Path

import ollama
import psycopg

DSN = "postgresql://rag:[email protected]:5432/rag"
EMBED_MODEL = "bge-m3"        # 1024 次元。変えたら全チャンクの再生成が必要
CHUNK_SIZE = 600
CHUNK_OVERLAP = 100


def split_text(text: str) -> list[str]:
    """段落境界を優先し、上限を超える段落だけ固定長で刻む。"""
    chunks: list[str] = []
    buf = ""
    for para in (p.strip() for p in text.split("\n\n") if p.strip()):
        if len(buf) + len(para) <= CHUNK_SIZE:
            buf = f"{buf}\n{para}" if buf else para
            continue
        if buf:
            chunks.append(buf)
        while len(para) > CHUNK_SIZE:
            chunks.append(para[:CHUNK_SIZE])
            para = para[CHUNK_SIZE - CHUNK_OVERLAP:]
        buf = para
    if buf:
        chunks.append(buf)
    return chunks


def to_vector_literal(vec: list[float]) -> str:
    """pgvector のテキスト表現。ドライバ側のアダプタ登録なしで渡せる。"""
    return "[" + ",".join(f"{x:.7f}" for x in vec) + "]"


def ingest(path: Path, title: str, owner: str, groups: list[str]) -> None:
    text = path.read_text(encoding="utf-8")
    chunks = [f"{title}\n{c}" for c in split_text(text)]   # 文書名をパンくずとして先頭に付ける
    vectors = ollama.embed(model=EMBED_MODEL, input=chunks)["embeddings"]

    with psycopg.connect(DSN) as conn, conn.cursor() as cur:
        cur.execute(
            """
            INSERT INTO documents (title, source_uri, owner, allowed_groups, content_hash)
            VALUES (%s, %s, %s, %s, %s)
            ON CONFLICT (source_uri) DO UPDATE
               SET title = EXCLUDED.title, allowed_groups = EXCLUDED.allowed_groups,
                   content_hash = EXCLUDED.content_hash, updated_at = now()
            RETURNING id
            """,
            (title, str(path), owner, groups, hashlib.sha256(text.encode()).hexdigest()),
        )
        doc_id = cur.fetchone()[0]
        cur.execute("DELETE FROM chunks WHERE document_id = %s", (doc_id,))
        for i, (chunk, vec) in enumerate(zip(chunks, vectors)):
            cur.execute(
                "INSERT INTO chunks (document_id, chunk_index, content, embedding) "
                "VALUES (%s, %s, %s, %s::vector)",
                (doc_id, i, chunk, to_vector_literal(vec)),
            )
    print(f"{path.name}: {len(chunks)} chunks")


if __name__ == "__main__":
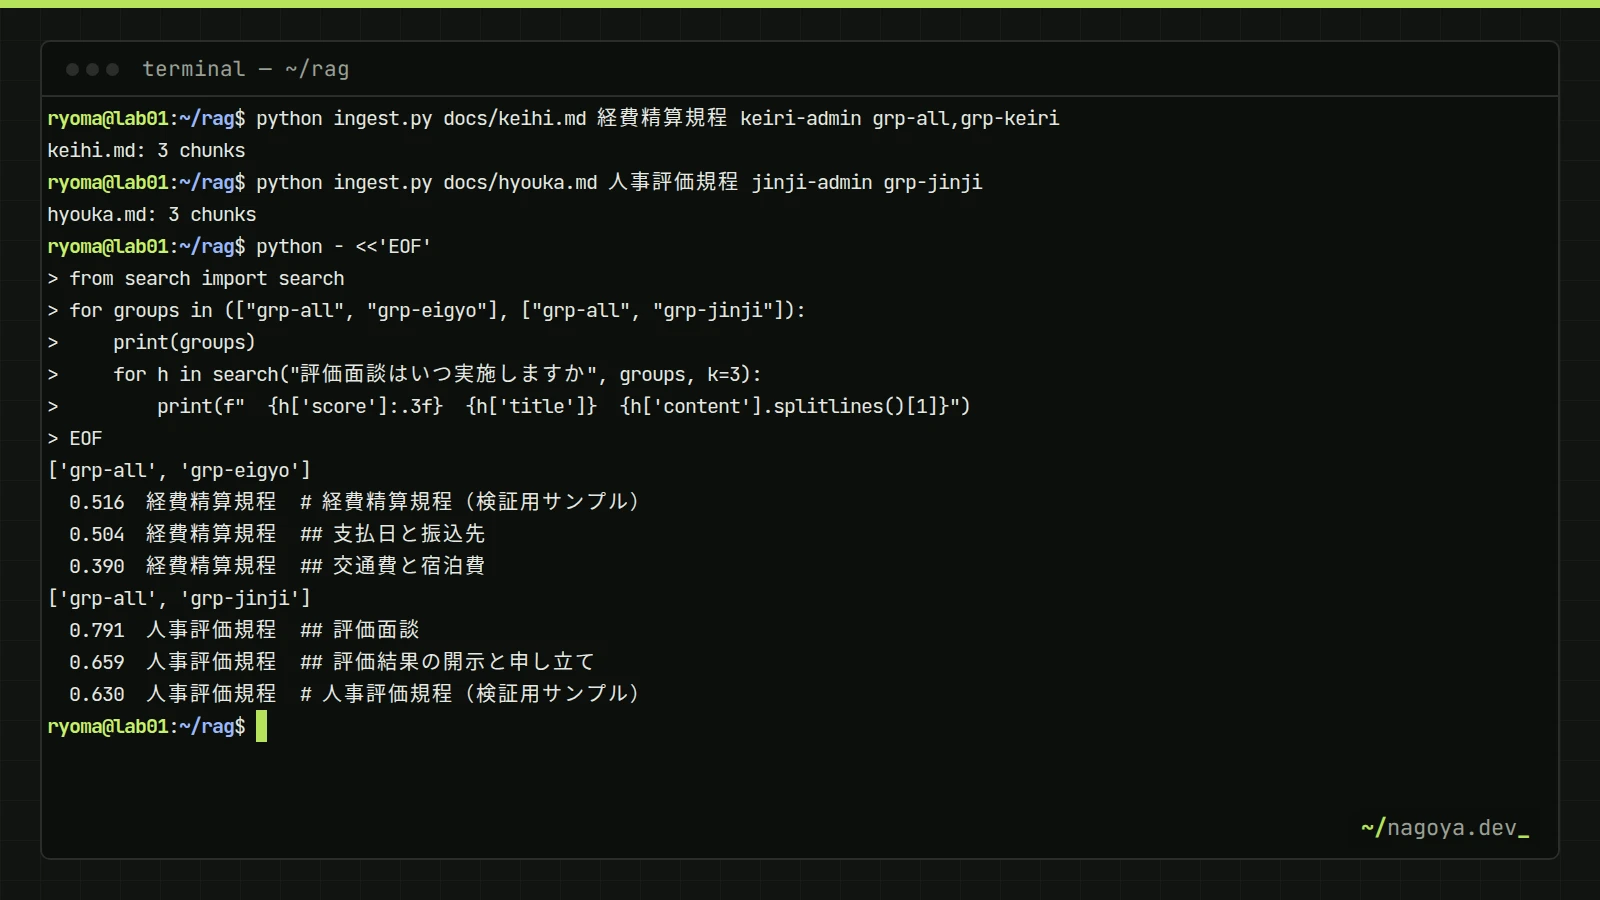
    # 例: python ingest.py docs/keihi.md 経費精算規程 keiri-admin grp-all,grp-keiri
    file, title, owner, groups = sys.argv[1:5]
    ingest(Path(file), title, owner, groups.split(","))
ollama.embed は input に配列を渡すと一括でベクトルを返します。1件ずつ呼ぶより数倍速く、100チャンク程度なら1リクエストで済みます。ベクトルは [0.01,0.02,...] というpgvectorのテキスト表現に変換して %s::vector で渡しています。pgvector-pythonの register_vector() を使う方法もありますが、文字列で渡せばドライバの追加設定なしで動き、他言語に移植するときも同じ形で書けます。取り込みは文書単位のトランザクションで、既存チャンクを消してから入れ直すので、途中で落ちてもロールバックされて半端な状態は残りません。
権限フィルタ付きの検索SQLとインデックス
SET hnsw.iterative_scan = relaxed_order;   -- pgvector 0.8.0 以降。フィルタで足りない分を索引から読み足す

SELECT c.id, d.title, d.source_uri, c.content,
       1 - (c.embedding <=> $1::vector) AS score      -- コサイン類似度(1 が同一)
FROM chunks c
JOIN documents d ON d.id = c.document_id
WHERE d.allowed_groups && $2::text[]                 -- 利用者の所属グループのどれかを含む文書だけ
ORDER BY c.embedding <=> $1::vector                  -- 索引と同じ演算子でないと索引が使われない
LIMIT 8;
<=> はコサイン距離(0が同一、2が正反対)で、1 - 距離 をコサイン類似度として返しています。ほかに <->(L2距離)と <#>(負の内積)がありますが、埋め込みモデルの多くはコサインで比較する前提で学習されているので、迷ったら <=> です。インデックスの演算子クラス(vector_cosine_ops)と検索で使う演算子は一致させます。
HNSWは近似索引で、既定では候補を40件(hnsw.ef_search)だけ集めてからWHERE句で絞ります。権限のある文書が全体の1割なら、40件中4件しか残らず、LIMIT 8に届きません。pgvector 0.8.0で追加された hnsw.iterative_scan を relaxed_order にすると、件数が足りない間は索引を読み進めて補い、hnsw.max_scan_tuples(既定20,000)が走査の上限になります。WHERE句フィルタを実用にする鍵はこの設定で、後述のPythonコードでも検索前に SET しています。
vector 型にHNSWインデックスを張れるのは2,000次元までです(halfvec なら4,000次元)。qwen3-embedding:8b のような4,096次元のモデルはどちらにも収まらないので、モデル選定の段階で次元数を確認してください。また、埋め込みモデルを変えることは列の作り直しと全文書の再埋め込みを意味します。モデル名を設定テーブルか環境変数で1か所に固定し、変えるときは移行作業として扱います。
部署単位で完全に分離してよいなら、allowed_groups の代わりにテナント列を持ってテーブルをパーティション分割する手もあります。フィルタ後の件数不足が起きず索引も小さくなりますが、「全社共通 + 部署固有」のような重なりが表現できません。社内文書ではほぼ必ず重なりがあるので、配列方式のほうが合います。
検索結果をLLMに渡すプロンプト設計
import ollama
import psycopg

DSN = "postgresql://rag:[email protected]:5432/rag"
EMBED_MODEL = "bge-m3"
CHAT_MODEL = "gemma4:12b"

SEARCH_SQL = """
SELECT c.id, d.title, d.source_uri, c.content,
       1 - (c.embedding <=> %(q)s::vector) AS score
FROM chunks c
JOIN documents d ON d.id = c.document_id
WHERE d.allowed_groups && %(groups)s::text[]
ORDER BY c.embedding <=> %(q)s::vector
LIMIT %(k)s
"""

SYSTEM_PROMPT = """あなたは社内文書に基づいて回答するアシスタントです。
- 回答は「参考資料」に書かれている内容だけを根拠にしてください。
- 参考資料に根拠がない場合は「該当する記載が見つかりませんでした」とだけ答えてください。
- 根拠にした資料の番号を文末に [1] の形式で示してください。"""


def search(question: str, groups: list[str], k: int = 8) -> list[dict]:
    qvec = ollama.embed(model=EMBED_MODEL, input=question)["embeddings"][0]
    q = "[" + ",".join(f"{x:.7f}" for x in qvec) + "]"
    with psycopg.connect(DSN) as conn, conn.cursor() as cur:
        cur.execute("SET hnsw.iterative_scan = relaxed_order")
        cur.execute(SEARCH_SQL, {"q": q, "groups": groups, "k": k})
        rows = cur.fetchall()
    return [dict(id=r[0], title=r[1], uri=r[2], content=r[3], score=r[4]) for r in rows]


def answer(question: str, groups: list[str]) -> str:
    hits = search(question, groups)
    if not hits:   # 権限内に根拠がなければ LLM を呼ばない
        return "閲覧権限のある文書の中に、該当する記載が見つかりませんでした。"
    context = "\n\n".join(
        f"[{i}] {h['title']}({h['uri']})\n{h['content']}" for i, h in enumerate(hits, 1)
    )
    res = ollama.chat(
        model=CHAT_MODEL,
        options={"num_ctx": 8192},   # 8 チャンク分の文脈が既定の 4096 に収まらない
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"参考資料:\n{context}\n\n質問: {question}"},
        ],
    )
    return res["message"]["content"]


if __name__ == "__main__":
    print(answer("経費精算の締め日はいつですか", groups=["grp-all", "grp-keiri"]))
システムプロンプトの3つのルール(根拠のみ、見つからなければそう言う、番号で出典)が肝です。とくに「見つからない」の答え方を先に定義しておかないと、LLMは一般知識で埋めた回答を平然と返します。検索結果がゼロのときはLLMを呼ばずに固定文を返すのが最も確実で、コードもそうしています。
num_ctx は8192にしています。8チャンク × 600文字 ≈ 5,000文字は日本語で概ね5,000〜7,000トークンになり、Ollama既定の4096では途中で切れます。出典番号はUI側で元文書へのリンクに変換します。監査ログには質問文・所属グループ・ヒットしたチャンクIDを残し、チャンク本文は残さないのが、権限設計と矛盾しない記録の取り方です。
評価と改善
「精度が悪い」を検索の問題と生成の問題に切り分けるために、30〜50問のテストセットを作ります。1問につき、質問文、期待する根拠文書のID、模範回答、質問者のグループを持たせ、変更のたびに同じセットを流します。
| 指標 | 測り方 | 出発点の合格ライン | 下回ったときに直す場所 |
|---|---|---|---|
| Recall@8(検索) | 期待文書のチャンクが上位8件に入った割合 | 0.8 | チャンクサイズ、パンくず、埋め込みモデル、ハイブリッド化 |
| 根拠性(生成) | 回答の各文が渡したチャンクで裏付けられるかを人手で0/1/2評価 | 平均1.6 | プロンプト、チャット用モデル、渡すチャンク数 |
| 権限テスト | 権限のないグループで同じ質問を投げ、ヒット0件かつ固定文が返る | 100% | WHERE句、グループ名の表記揺れ |
| 応答時間 | 検索 + 生成のp95 | 社内チャットなら15秒 | ef_search、モデルサイズ、GPU |
Recallが低ければ検索側、Recallが高いのに根拠性が低ければ生成側を直します。型番や固有名詞の取りこぼしはベクトル検索の構造的な弱点なので、pg_trgm やPGroongaによる全文検索を併用して結果を統合するハイブリッド検索が定番の次の一手です。日本語は標準の tsvector では分かち書きできないため、拡張が要る点に注意してください。評価の考え方の全体像はRAGの仕組みと設計原則で整理しています。
動作確認
$ python ingest.py docs/keihi.md 経費精算規程 keiri-admin grp-all,grp-keiri
keihi.md: 23 chunks

$ docker compose exec db psql -U rag -d rag -c "SELECT count(*) FROM chunks;"
 count
-------
    23

$ docker compose exec db psql -U rag -d rag -c "EXPLAIN SELECT c.id FROM chunks c JOIN documents d ON d.id = c.document_id WHERE d.allowed_groups && ARRAY['grp-keiri'] ORDER BY c.embedding <=> (SELECT embedding FROM chunks LIMIT 1) LIMIT 8;"
 ...
   ->  Index Scan using chunks_embedding_hnsw on chunks c     ← HNSW 索引が使われている
 ...

$ python search.py
経費精算の締め日は毎月5日です。前月分はワークフローで締め日までに申請してください [1]。

$ python -c "from search import search; print(len(search('経費精算の締め日', groups=['grp-soumu'])))"
0 ← 権限のないグループでは 1 件も返らない最後の権限テストは、機能テストではなくセキュリティテストとしてCIに入れてください。グループ名の表記揺れ(grp-keiri と GRP-Keiri)は最も起きやすい抜け穴で、IdPからの取得時に正規化する処理を1か所に置きます。
つまずきポイント
ERROR: type "vector" does not exist
拡張はデータベース単位で有効化されます。CREATE EXTENSION vector を別のデータベース(postgres など)で実行していないか確認し、対象DBで実行し直します。
ERROR: expected 1024 dimensions, not 768
取り込みか検索で、列定義と違う次元のモデル(768次元の embeddinggemma など)を使っています。EMBED_MODEL を1か所に固定し、変えるなら列を作り直して全文書を再埋め込みします。
ERROR: column cannot have more than 2000 dimensions for hnsw index
モデルの次元数が索引の上限を超えています。2,000次元以下のモデルに変えるか、4,000次元までなら halfvec(次元数) 型と halfvec_cosine_ops で索引を張ります。
権限のある文書があるのに検索結果がLIMITより少ない
HNSWの候補40件がWHERE句でほぼ落ちています。SHOW hnsw.iterative_scan; が off なら relaxed_order に設定し、pgvectorが0.8.0未満ならイメージを更新します。応急処置としては SET hnsw.ef_search = 200; でも件数は増えます。
ollama.ResponseError: model "bge-m3" not found(status_code 404)
Pythonが接続しているOllamaにモデルがありません。ollama pull bge-m3 を、Pythonから見えるホスト側で実行します。Ollamaが別ホストなら ollama.Client(host="http://192.168.1.20:11434") のようにクライアントを明示するか、環境変数 OLLAMA_HOST を設定します。
よくある質問
ベクトルデータベース専用製品とpgvectorの違いは?
専用製品は億単位のベクトルを複数ノードで分散する前提で作られ、pgvectorは既存のPostgreSQLに相乗りします。社内文書の規模(数百万チャンクまで)なら性能差は問題にならず、権限のJOIN、バックアップ、監視をそのまま使えるpgvectorのほうが運用対象が増えません。
埋め込みモデルは何を選べばよいですか?
日本語を含む多言語対応で、次元数が2,000以下のものです。執筆時点ではbge-m3(1024次元、8192トークン入力)が無難で、qwen3-embedding:0.6bも同じ次元で使えます。英語中心のnomic-embed-textやall-MiniLMは日本語の検索精度が落ちます。自社の30問テストでRecall@8を比べて決めてください。
権限フィルタはなぜ検索時に必要なのですか?
検索後に捨てる方式では、権限のないチャンク本文が一度アプリに渡るため実装ミスで漏れ、さらに上位k件がすべて権限外なら根拠がゼロになります。WHERE句で絞れば、データベースが権限内の上位k件を返し、アプリは権限外の本文に触れません。
まとめ
社内文書RAGの設計で外せないのは、ACLを文書テーブルに持ち、検索SQLのWHERE句で絞ることです。HNSWの後段フィルタで件数が足りなくなる問題は hnsw.iterative_scan = relaxed_order で解決し、埋め込みモデルと次元数は1か所に固定して移行作業として扱います。プロンプトは「根拠のみ・見つからなければそう言う・番号で出典」の3ルールで固め、30問のテストセットでRecallと根拠性を分けて測れば、改善すべき場所が検索側か生成側かは迷いません。
次に読む
- RAGとは?仕組みと社内導入で失敗しない設計原則:PoCから本番までの進め方と評価指標
- Ollamaで始めるローカルLLM入門:
/api/embedと/api/chatの使い方、コンテキスト長の設定 - Difyをセルフホストする:自作せずにGUIでナレッジ検索を試したい場合の選択肢
- Open WebUIで社内ChatGPT環境を作る:内蔵RAG機能で足りるかどうかの見極め