PaddleOCRとは、PaddlePaddle上で動く、文字の位置を探す検出モデルと行を文字列にする認識モデルを組み合わせたオープンソースのOCRツールキットです(Apache License 2.0)。執筆時点の最新版3.7.0では、lang="japan"を指定しても日本語専用のモデルは使われず、日本語・中国語・英語などをまとめて扱うPP-OCRv6のmediumモデルが読み込まれました。ここではPython 3.12のコンテナにCPU版のPaddlePaddleと一緒に入れ、自作した日本語の文書画像4枚を読ませて、同じ画像と同じ採点スクリプトでTesseractと比べています。
対象は、紙の申請書やスキャンした文書をテキストにして検索や転記に使いたい情シス・社内SEの方です。読み終えると、slimイメージで足りない共有ライブラリの探し方、文字・信頼度・座標をJSONに書き出すPythonスクリプト、文字誤り率(CER)の測り方、CPUだけで動かしたときの処理時間とメモリ、そして「画像が外部に送られないか」をネットワークを切ったコンテナで確かめる手順まで、手元で再現できます。数字はどれも今回の4枚と今回のサーバーでの結果で、PaddleOCR一般の精度や速度を示すものではありません。
この記事でわかること
- python:3.12-slimにPaddleOCR 3.7.0とPaddlePaddle 3.2.2を入れる手順と、足りない共有ライブラリを
lddでまとめて見つける方法 - CLIとPython APIで、行ごとの文字・信頼度・座標をJSONに書き出すスクリプト
- 申請書・お知らせ・英数字混じり・劣化スキャンの4枚で測った文字誤り率、処理時間、最大メモリと、Tesseract(jpn)との比較
- モデルの取得先と保存場所、ネットワークを切ったコンテナでの動作、CLIが結果画像用のフォントを取りに行く挙動
- paddlepaddle 3.3.1で出たoneDNNのエラーと、メモリ上限で強制終了したときの対処
PaddleOCRの処理の流れと、この記事で扱う範囲
PaddleOCRに画像を1枚渡すと、内部では次の5つの段階が順に動きます。必須なのは「文字の検出」と「文字の認識」の2つで、残りの3つは前処理です。モデル名は、今回の実行ログに出たものです。
| 段階 | 役割 | 読み込まれたモデル | この記事での扱い |
|---|---|---|---|
| 文書の向き判定 | ページ全体が0・90・180・270度のどれだけ回っているかを判定し、正しい向きに戻す | PP-LCNet_x1_0_doc_ori | 比較の節だけ有効 |
| 歪み補正 | 撮影で曲がった紙の画像をまっすぐに補正する | UVDoc | 比較の節だけ有効 |
| 文字の検出 | 文字列がある範囲を四角形で囲む | PP-OCRv6_medium_det | 常に有効 |
| 行の向き判定 | 切り出した行が上下逆さかどうかを判定する | PP-LCNet_x1_0_textline_ori | 比較の節だけ有効 |
| 文字の認識 | 切り出した行の画像を文字列にし、信頼度を付ける | PP-OCRv6_medium_rec | 常に有効 |
推論の土台はPaddleXという別のライブラリで、paddleocrを入れると依存として入ります。一方、計算を受け持つPaddlePaddle本体はpaddleocrの依存に含まれていません(このあとpip showで確かめます)。公式ドキュメントの対応表では、PaddleOCR 3.7.xにはPaddleX 3.7.0以上3.8.0未満と、PaddlePaddle 3.0.0以上を組み合わせます(執筆時点)。
PP-OCRv6はPaddleOCR 3.7.0(2026年6月11日リリース)で加わったモデル群で、READMEによると1つのモデルで中国語・英語・日本語と46のラテン文字の言語を扱い、大きさはtiny・small・mediumの3段階です。この記事ではmediumとsmallを比べます。
扱わないものも先に挙げておきます。文書をMarkdownやJSONに構造化するPaddleOCR-VL(0.9Bパラメータのビジョン言語モデル。READMEに載っている最新はPaddleOCR-VL-1.6)とPP-StructureV3、GPU、Windowsは、この記事では実行していません。公式ドキュメントでは、PaddleOCR-VLもx64 CPUでのローカル推論を手順に含めていますが、本番運用には専用のVLM推論サービスを勧めています。メモリ4GiB・2コアに絞った今回の環境では試していません。
検証環境を用意する
検証はDockerのコンテナ1つで行います。コンテナ名paddleocr-japanese-ocr-python-lab、ホスト名 nagoyadevlab01、作業ユーザー ryoma、作業ディレクトリ~/paddle-labは、どれも検証用に付けた例の名前です。コマンドや出力に出てくるこれらの名前と/home/ryomaは、自分の環境のものに読み替えてください。Dockerホストで次のコマンドを実行します(docker runが表示するコンテナIDは省いています)。
docker run -d --name paddleocr-japanese-ocr-python-lab --hostname nagoyadevlab01 --memory 4g --memory-swap 4g --cpus 2 python:3.12.15-slim-trixie sleep infinity
docker image inspect python:3.12.15-slim-trixie --format '{{index .RepoDigests 0}}'
python@sha256:a0f57064cbdcd6285fa45f51237ab0b35ea8ebaed06a1f5973e89e19dfb86704
--memory 4gと--memory-swap 4gを同じ値にすると、スワップを使わずにメモリ4GiBで頭打ちになります。--cpus 2はCPU時間を2コア分に制限する指定です。どちらも共用サーバーで動かすための上限ですが、後半の処理時間とメモリの数字はこの条件で測っています。ポートの公開も--privilegedも使いません。イメージのタグはPythonのパッチ版とDebianのコード名(trixie)まで固定し、取得したイメージのダイジェストも記録しました。
続いてdocker exec -it paddleocr-japanese-ocr-python-lab bashでrootとして入り、テスト画像に使う日本語フォントと、時間計測用のtimeを入れて、作業ユーザーを作ります。
apt-get update -qq && DEBIAN_FRONTEND=noninteractive apt-get install -y -qq --no-install-recommends fonts-ipaexfont-gothic fonts-ipaexfont-mincho time >/dev/null 2>&1; echo "exit=$?"
exit=0
useradd -m -s /bin/bash ryoma && id ryoma
uid=1000(ryoma) gid=1000(ryoma) groups=1000(ryoma)
cat /etc/debian_version; python3 --version; nproc; cat /sys/fs/cgroup/cpu.max; grep -m1 'model name' /proc/cpuinfo
13.7
Python 3.12.15
4
200000 100000
model name	: AMD EPYC 7713 64-Core Processor
Debian 13.7とPython 3.12.15の上で動かしています。nprocはホストの論理CPU数の4を返しますが、cgroupのcpu.maxは「100000マイクロ秒ごとに200000マイクロ秒まで」、つまり2コア分です。スレッド数をnprocの値やライブラリの既定値のままにすると、実際の割り当てより多いスレッドで動くことになり、これが速度の節で効いてきます。CPUはAMD EPYC 7713です。
pipでPaddleOCRとPaddlePaddleを入れる
作業ユーザーで入り直し(docker exec -it -u ryoma -w /home/ryoma paddleocr-japanese-ocr-python-lab bash)、仮想環境を作って版を固定して入れます。以降、作業ユーザーのシェルはこの仮想環境を有効にした状態(. ~/venv/bin/activateを実行済み)で進めます。
python3 -m venv ~/venv
. ~/venv/bin/activate
pip install -q paddlepaddle==3.2.2 paddleocr==3.7.0 paddlex==3.7.2 pillow==13.0.0; echo "exit=$?"

[notice] A new release of pip is available: 25.0.1 -> 26.2.2
[notice] To update, run: pip install --upgrade pip
exit=0
pip list 2>/dev/null | grep -iE '^(paddle|opencv|numpy|pillow|huggingface)'
huggingface_hub       2.4.0
numpy                 2.3.5
opencv-contrib-python 4.10.0.84
paddleocr             3.7.0
paddlepaddle          3.2.2
paddlex               3.7.2
pillow                13.0.0
pip show paddleocr | grep -E "^(Version|Requires):"
Version: 3.7.0
Requires: aiohttp, paddlex, PyYAML, requests, typing-extensions
du -sh ~/venv
1.3G	/home/ryoma/venv
pip showのRequiresを見ると、paddleocrの依存にpaddlepaddleは含まれず、PaddlePaddleは自分で選んで入れる形です。版を固定した理由は次のとおりです。執筆時点で最新のpaddlepaddle 3.3.1では、この環境で認識が始まった直後にエラーで止まりました(つまずきポイントで再現します)。公式のインストール手順がCPU版の例に挙げているのは3.2.0をPaddlePaddleのパッケージインデックスから入れる形で、今回はPyPIにある同じ3.2系の3.2.2を使いました。依存のpaddlexは、paddleocr 3.7.0が認める範囲(3.7.0以上3.8.0未満)の中で版がずれないように、pillowは次の節で作るテスト画像を同じ画素で作り直せるように、それぞれ固定しています。仮想環境の大きさは1.3Gで、OpenCV(opencv-contrib-python)とHugging Faceのクライアント(huggingface_hub)も一緒に入りました。
版を指定せずにpip install paddlepaddleとすると、執筆時点では3.3.1が入ります。3.7.xの版の対応表は「PaddlePaddle 3.0.0以上」としか書いていないので、pipは止めてくれません。この環境では3.3.1でCPU推論がNotImplementedError: (Unimplemented) ConvertPirAttribute2RuntimeAttribute not supportで止まりました。動作を確かめた版をrequirementsファイルに書いて、paddlepaddleとpaddlexまで固定してください。
この状態でimportすると失敗します。
python -c "import paddleocr"
Traceback (most recent call last):
  File "<string>", line 1, in <module>
…(中略)…
ImportError: libGL.so.1: cannot open shared object file: No such file or directory原因は、paddleocrが読み込むOpenCV(cv2)がOpenGLのライブラリlibGL.so.1を必要としていることです。python:3.12-slimのような最小構成のイメージには、X11やOpenGLの共有ライブラリが入っていません。1つ入れて再実行すると次はlibgthread-2.0.so.0が見つからない、と1つずつしか分からないので、OpenCVとPaddlePaddleの本体が必要とするライブラリをlddでまとめて調べます。
ldd ~/venv/lib/python3.12/site-packages/cv2/cv2.abi3.so ~/venv/lib/python3.12/site-packages/paddle/base/libpaddle.so | grep "not found" | sort -u
	libGL.so.1 => not found
	libglib-2.0.so.0 => not found
	libgomp.so.1 => not found
libgthread-2.0.so.0 => not foundlibgomp.so.1はGCCのOpenMPランタイムで、PaddlePaddleのlibpaddle.soが使います。これが無いとimport paddleの段階で止まります。rootのシェルに戻って3つのパッケージを入れます。Debian 13では、GLibのパッケージ名の末尾にt64が付いています。
DEBIAN_FRONTEND=noninteractive apt-get install -y -qq --no-install-recommends libgl1 libglib2.0-0t64 libgomp1 >/dev/null 2>&1; echo "exit=$?"
exit=0python -c "import paddle, paddleocr, paddlex; print(paddle.__version__, paddleocr.__version__, paddlex.__version__)"
3.2.2 3.7.0 3.7.23つの版が表示されれば準備は終わりです。importのたびにUserWarning: No ccache found.で始まる警告が2行出ますが、C++の拡張を作り直すときのビルドキャッシュ(ccache)が無いという通知で、今回の手順ではこの警告が出たまま、すべての処理が最後まで動きました。以降の出力からは省きます。
テスト用の日本語文書と正解テキストを作る
精度を数字で比べるには、正解のテキストが分かっている画像が要ります。文面を自分たちで書き、DebianのパッケージのIPAexゴシックとIPAex明朝で描くスクリプトを用意しました。文面、人名、メールアドレスのドメイン(example.co.jp)は、すべて架空の例です。このコンテナにはエディタが無いので、ファイルはヒアドキュメントで書き込みます。
mkdir -p ~/paddle-lab && cd ~/paddle-lab
cat > make_docs.py <<'EOF'
"""PaddleOCRとTesseractの比較用に、正解テキストつきの日本語文書画像を作る(文面はすべて架空の例)"""
import random

from PIL import Image, ImageDraw, ImageFilter, ImageFont

GOTHIC = "/usr/share/fonts/opentype/ipaexfont-gothic/ipaexg.ttf"
MINCHO = "/usr/share/fonts/opentype/ipaexfont-mincho/ipaexm.ttf"
W, H = 2480, 3508  # A4を300dpiで取り込んだときの画素数


# レイアウトエンジンをBASICに固定する。既定(Pillowの自動選択)だと、libfribidiが入っているかどうかで
# 文字の並べ方が変わり、同じスクリプトでも画像のハッシュ値が変わる
def font(path, size):
    return ImageFont.truetype(path, size, layout_engine=ImageFont.Layout.BASIC)


g40, g64 = font(GOTHIC, 40), font(GOTHIC, 64)
m42, m60 = font(MINCHO, 42), font(MINCHO, 60)


def save(img, name, lines):
    img.save(f"{name}.png", dpi=(300, 300))
    with open(f"{name}.txt", "w", encoding="utf-8") as fh:
        fh.write("\n".join(lines) + "\n")


def wrap(text, font, width):
    """幅widthを超える手前で折り返す。句読点と閉じ括弧は行頭に置かない。"""
    out, cur = [], ""
    for ch in text:
        if cur and font.getlength(cur + ch) > width and ch not in "、。」)":
            out.append(cur)
            cur = ""
        cur += ch
    return out + [cur]


# form: 罫線つきの申請書(ラベル欄は薄い灰色)
FORM = [("申請日", "2026年11月5日"), ("申請者", "経理課 高橋 美咲"), ("内線番号", "3125"),
        ("貸出機器", "ノートPC(ThinkPad X13 Gen 4)"), ("資産番号", "IT-2024-0387"),
        ("貸出期間", "2026年11月10日〜2026年11月21日"), ("利用目的", "出張先での経費精算と会議資料の作成"),
        ("付属品", "ACアダプター、USB-C変換アダプター"), ("承認者", "情報システム課長")]
img = Image.new("L", (W, H), 255)
d = ImageDraw.Draw(img)
d.text((240, 220), "機器貸出申請書", font=g64, fill=0)
y = 420
for label, value in FORM:
    d.rectangle([240, y, 760, y + 120], fill=230, outline=0, width=3)
    d.rectangle([760, y, 2240, y + 120], outline=0, width=3)
    d.text((280, y + 38), label, font=g40, fill=0)
    d.text((800, y + 38), value, font=g40, fill=0)
    y += 120
save(img, "form", ["機器貸出申請書"] + [f"{a} {b}" for a, b in FORM])

# notice: 明朝体の文章(お知らせ)
TITLE = "複合機の入れ替えと印刷設定の変更について"
PARAS = [
    "12月1日(月)から、本社2階と4階の複合機を新しい機種に入れ替えます。入れ替えの後は、印刷のたびに社員証を"
    "カードリーダーにかざす「認証印刷」が必須になり、かざさなかった印刷データは24時間で自動的に削除されます。",
    "新しいプリンタードライバーは、11月25日までに資産管理ツールから各PCへ配布します。配布が終わったPCでは、"
    "プリンターの一覧に「HQ-2F-Color」と「HQ-4F-Mono」が表示されます。古いプリンターの登録は入れ替えの当日に削除します。",
    "カラー印刷は部署ごとに月500枚までを目安とし、超えた分は翌月の部門費に計上します。スキャンした文書はこれまでどおり"
    "共有フォルダの「scan」に保存されますが、ファイル名の形式が「日付_時刻_番号.pdf」に変わります。"
    "不明な点は情報システム課(内線2210)までお問い合わせください。",
]
img = Image.new("L", (W, H), 255)
d = ImageDraw.Draw(img)
d.text((240, 260), TITLE, font=m60, fill=0)
y, lines = 440, [TITLE]
for para in PARAS:
    for line in wrap(para, m42, 2000):
        d.text((240, y), line, font=m42, fill=0)
        lines.append(line)
        y += 70
    y += 35
save(img, "notice", lines)
notice = img

# mixed: 数字・記号・半角カナ・全角英数が混ざった行
MIXED = ["型番:FX-3200B/シリアル:SN7Q4K-0921", "IPアドレス:192.168.20.15 ゲートウェイ:192.168.20.1",
         "MACアドレス:3C:52:82:A1:7F:0E", "問い合わせ:[email protected] 内線2210",
         "発注日:2026/11/05 納期:2026/12/01", "単価:¥48,600(税込)×3台=¥145,800",
         "パスワードリセット手順(半角カナ)", "全角英数:ABC123 半角英数:ABC123",
         "ライセンスキー:K7Q2-L0O1-I9XZ"]
img = Image.new("L", (W, 1400), 255)
d = ImageDraw.Draw(img)
for i, line in enumerate(MIXED):
    d.text((240, 160 + i * 120), line, font=g40, fill=0)
save(img, "mixed", MIXED)

# scan: noticeを2度傾け、150dpi相当に縮小し、ノイズとぼかしを加えた「質の悪いスキャン」
rnd = random.Random(20261030)
img = notice.rotate(2, resample=Image.BICUBIC, fillcolor=255).resize((W // 2, H // 2), Image.LANCZOS)
px = img.load()
for _ in range(img.width * img.height // 50):  # 全画素の2%を灰色の点に置き換える
    px[rnd.randrange(img.width), rnd.randrange(img.height)] = rnd.choice((90, 170))
img = img.filter(ImageFilter.GaussianBlur(0.8))
img.save("scan.png", dpi=(150, 150))
with open("scan.txt", "w", encoding="utf-8") as fh:
    fh.write("\n".join(lines) + "\n")
EOFpython make_docs.py && sha256sum *.png
667f6ee656e2ec730b6d032f39ea2306d0be724debd0634b8dc794b5a666d11b form.png
cb05856028ee218164e9ecb694d28e79f6612dd0adf893e76377a86b53a639f5 mixed.png
32d3dbdc1141b37aec01b81d5c0429a93a5f109dfcc8eba86713271a338152aa notice.png
bb4eb232bd11e09df3eac4e1a490266cc7a87200033fd73e07162b8ba2e78baf scan.png
cat mixed.txt
型番:FX-3200B/シリアル:SN7Q4K-0921
IPアドレス:192.168.20.15 ゲートウェイ:192.168.20.1
MACアドレス:3C:52:82:A1:7F:0E
問い合わせ:[email protected] 内線2210
発注日:2026/11/05 納期:2026/12/01
単価:¥48,600(税込)×3台=¥145,800
パスワードリセット手順(半角カナ)
全角英数:ABC123 半角英数:ABC123
ライセンスキー:K7Q2-L0O1-I9XZできる画像と、ねらいは次のとおりです。各画像の正解テキストは、同じ名前の.txtに書き出されます。
form.png:罫線つきの「機器貸出申請書」。ラベル欄は薄い灰色で、資産番号(IT-2024-0387)、波ダッシュ(〜)を使った期間、全角の括弧を含みます(IPAexゴシック、A4を300dpiで取り込んだ大きさの2480×3508画素)notice.png:明朝体のお知らせ文。「HQ-2F-Color」や内線番号などの英数字を含む3段落(A4・300dpi相当)mixed.png:型番、IPアドレス、MACアドレス、メールアドレス、金額、半角カナ、全角英数、0とO・1とIが紛らわしいライセンスキーの9行scan.png:notice.pngを2度傾けて半分の大きさ(150dpi相当)に縮め、全画素の2%を灰色の点に置き換えてぼかした「質の悪いスキャン」の代役。乱数の種は固定
ハッシュ値は、同じ版のPillowとフォントで作り直したときに同じ画像になったかを確かめるためのものです。フォントの読み込みでlayout_engine=ImageFont.Layout.BASICを指定している理由は、Tesseractを入れたあとの節で確かめます。
CLIで1枚読む:初回のモデル取得と出力ファイル
まずはコマンドラインでmixed.pngを読ませます。3つの前処理はFalseにして、検出と認識だけを動かします。スレッド数は割り当てた2コアに合わせて--cpu_threads 2にしました。
paddleocr ocr -i mixed.png --lang japan --use_doc_orientation_classify False --use_doc_unwarping False --use_textline_orientation False --cpu_threads 2 --save_path out
Creating model: ('PP-OCRv6_medium_det', None, None)
Checking connectivity to the model hosters, this may take a while. To bypass this check, set `PADDLE_PDX_DISABLE_MODEL_SOURCE_CHECK` to `True`.
Using official model (PP-OCRv6_medium_det), the model files will be automatically downloaded and saved in `/home/ryoma/.paddlex/official_models/PP-OCRv6_medium_det`.
Creating model: ('PP-OCRv6_medium_rec', None, None)
Using official model (PP-OCRv6_medium_rec), the model files will be automatically downloaded and saved in `/home/ryoma/.paddlex/official_models/PP-OCRv6_medium_rec`.
ReduceMeanCheckIfOneDNNSupport
[2026/10/30 22:50:28] paddleocr INFO: Processed item 0 in 11172.138214111328 ms
…(認識結果の辞書の表示は省略)…
Connecting to https://paddle-model-ecology.bj.bcebos.com/paddlex/PaddleX3.0/fonts/simfang.ttf ...
Downloading simfang.ttf ...
--lang japanで選ばれたのはPP-OCRv6_medium_detとPP-OCRv6_medium_recで、名前に言語の付いていない共通のモデルでした。初回は手元にモデルが無いので「Checking connectivity to the model hosters」と表示してから取得し、~/.paddlex/official_models/の下に保存します。1枚の処理は約11秒(11172ミリ秒)でした。ReduceMeanCheckIfOneDNNSupportという行はPaddlePaddleの内部が出す通知で、このCLIの実行では11行出ました。エラーではないので、抜粋では1行だけ残しています。
最後の2行は、--save_pathで結果の画像を描くためのフォント(simfang.ttf)を、モデルとは別のpaddle-model-ecology.bj.bcebos.comから取得している表示です。結果の画像を作らないPython APIの使い方では、この取得は起きませんでした(通信の節で記録を見ます)。
ls out; du -sh ~/.paddlex/official_models/* ~/.paddlex/fonts
mixed_ocr_res_img.png
mixed_res.json
60M	/home/ryoma/.paddlex/official_models/PP-OCRv6_medium_det
74M	/home/ryoma/.paddlex/official_models/PP-OCRv6_medium_rec
11M	/home/ryoma/.paddlex/fonts
ls ~/.paddlex/official_models/PP-OCRv6_medium_rec
README.md
inference.json
inference.pdiparams
inference.yml
python -c 'import json; d = json.load(open("out/mixed_res.json")); print(sorted(d)); print(d["rec_texts"][0], round(d["rec_scores"][0], 3), d["rec_boxes"][0])'
['dt_polys', 'input_path', 'model_settings', 'page_index', 'rec_boxes', 'rec_polys', 'rec_scores', 'rec_texts', 'return_word_box', 'text_det_params', 'text_rec_score_thresh', 'text_type', 'textline_orientation_angles']
型番:FX-3200B/シリアル:SN7Q4K-0921 0.981 [239, 160, 1061, 200]検出モデルが60M、認識モデルが74M、フォントが11Mでした。モデルのディレクトリには、推論に使うinference.json・inference.pdiparams・inference.ymlと、モデルカードのREADME.mdが入っています。インターネットに出られない社内のサーバーでは、このディレクトリを持ち込めば取得をしなくて済みます。通信の節では、このディレクトリを含むイメージをネットワークなしで動かして確かめます。
結果のJSONで使うのは、rec_texts(行ごとの文字列)、rec_scores(認識の信頼度。0〜1)、rec_boxes(行を囲む四角形の左上と右下の座標[x1, y1, x2, y2])の3つです。1行目の型番の行は[239, 160, 1061, 200]で、make_docs.pyがこの行を描いた位置(x=240、y=160)とほぼ一致しました。rec_polysは四隅の座標で、傾いた行を囲むときに使います。
Python APIで文字・信頼度・座標をJSONに書き出す
CLIの表示を整形するより、Python APIで必要な項目だけを取り出すほうが後工程に渡しやすくなります。次のocr_paddle.pyは、画像ごとに「1行に1要素」のJSONとテキストを書き出し、処理時間と最大メモリも表示します。
cat > ocr_paddle.py <<'EOF'
"""PaddleOCRで画像を読み、行ごとの文字・信頼度・座標を <名前>.<tag>.json に、文字だけを <名前>.<tag>.txt に書く。
使い方: python ocr_paddle.py [--threads N] [--tier medium|small] [--preprocess] [--tag 印] 画像..."""
import argparse
import json
import resource
import time

from paddleocr import PaddleOCR

ap = argparse.ArgumentParser()
ap.add_argument("images", nargs="+")
ap.add_argument("--threads", type=int, help="CPUの推論スレッド数(省略時はPaddleOCRの既定値)")
ap.add_argument("--tier", choices=["medium", "small"], default="medium", help="PP-OCRv6のモデルの大きさ")
ap.add_argument("--preprocess", action="store_true", help="向き判定・歪み補正・行の向き判定を有効にする")
ap.add_argument("--tag", default="paddle", help="出力ファイル名に付ける印")
a = ap.parse_args()

opts = {
    "lang": "japan",
    "use_doc_orientation_classify": a.preprocess,  # ページ全体の向き(0/90/180/270度)を判定して回す
    "use_doc_unwarping": a.preprocess,             # 撮影で曲がった紙をまっすぐに補正する(UVDoc)
    "use_textline_orientation": a.preprocess,      # 行ごとに上下逆さかを判定する
}
if a.tier == "small":
    opts["text_detection_model_name"] = "PP-OCRv6_small_det"
    opts["text_recognition_model_name"] = "PP-OCRv6_small_rec"
if a.threads:
    opts["cpu_threads"] = a.threads

t0 = time.perf_counter()
ocr = PaddleOCR(**opts)
print(f"モデル読み込み {time.perf_counter() - t0:.1f}秒", flush=True)

for path in a.images:
    t = time.perf_counter()
    res = ocr.predict(path)[0]
    sec = time.perf_counter() - t
    rows = [{"text": s, "score": round(float(c), 3), "box": [int(v) for v in b]}
            for s, c, b in zip(res["rec_texts"], res["rec_scores"], res["rec_boxes"])]
    stem = path.rsplit(".", 1)[0]
    with open(f"{stem}.{a.tag}.json", "w", encoding="utf-8") as fh:   # 1行に1要素のJSON配列
        fh.write("[\n" + ",\n".join(json.dumps(r, ensure_ascii=False) for r in rows) + "\n]\n")
    with open(f"{stem}.{a.tag}.txt", "w", encoding="utf-8") as fh:
        fh.write("\n".join(r["text"] for r in rows) + "\n")
    print(f"{path}: {len(rows)}行 {sec:.1f}秒", flush=True)

peak = resource.getrusage(resource.RUSAGE_SELF).ru_maxrss // 1024
print(f"最大メモリ(RSS) {peak} MiB", flush=True)
EOFPaddleOCR(...)を作った時点でモデルを読み込み、predict()は1ページにつき1つの結果を返します。3つの前処理は--preprocessを付けたときだけ有効にし、--tier smallではモデル名を直接指定します(このときlangは無視される、という警告が出ます)。--threadsはCPU推論のスレッド数cpu_threadsに渡します。最大メモリはresource.getrusageのru_maxrss(Linuxではキロバイト単位)をMiBに直した値です。
python ocr_paddle.py --threads 2 form.png notice.png mixed.png scan.png | grep -v ReduceMean
Creating model: ('PP-OCRv6_medium_det', None, None)
Model files already exist. Using cached files. To redownload, please delete the directory manually: `/home/ryoma/.paddlex/official_models/PP-OCRv6_medium_det`.
Creating model: ('PP-OCRv6_medium_rec', None, None)
Model files already exist. Using cached files. To redownload, please delete the directory manually: `/home/ryoma/.paddlex/official_models/PP-OCRv6_medium_rec`.
モデル読み込み 2.4秒
form.png: 19行 24.1秒
notice.png: 10行 26.9秒
mixed.png: 9行 11.9秒
scan.png: 10行 12.2秒
最大メモリ(RSS) 3724 MiBhead -n 4 form.paddle.json
[
{"text": "機器貸出申請書", "score": 1.0, "box": [236, 217, 689, 286]},
{"text": "申請日", "score": 0.999, "box": [276, 450, 401, 505]},
{"text": "2026年11月5日", "score": 1.0, "box": [798, 455, 1093, 499]},
python -c 'import json, sys; [print(r["score"], r["text"]) for f in sys.argv[1:] for r in json.load(open(f)) if r["score"] < 0.95]' form.paddle.json notice.paddle.json mixed.paddle.json scan.paddle.json
0.922 経理課 高橋 美咲
0.876 資産番号
0.942 単価:¥48,600(税込)×3台=¥145,800
0.924 ハ°スワードリセット手順(半角カナ)
grep -E "PC|〜|~" form.paddle.json
{"text": "ノ—卜PC (ThinkPad X13 Gen 4)", "score": 0.968, "box": [804, 814, 1419, 861]},
{"text": "2026年11月10日~2026年11月21日", "score": 0.995, "box": [798, 1056, 1476, 1100]},2回目以降はキャッシュ済みのモデルを使うので、読み込みは2.4秒で終わりました。信頼度が0.95を下回った4行のうち、「経理課 高橋 美咲」と「資産番号」は正しく読めています。一方、実際に誤りを含んでいた「ノ—卜PC (ThinkPad X13 Gen 4)」は0.968、期間の行は0.995でした。信頼度のしきい値だけでは誤りを拾いきれません。資産番号ならIT-\d{4}-\d{4}のような形式チェック、日付なら日付として解釈できるかの検査を組み合わせ、どちらかで引っかかった行を人の確認に回す作りを勧めます。
文字誤り率(CER)で採点する
文字誤り率(CER:Character Error Rate)は、OCRの結果を正解に直すのに必要な挿入・削除・置換の回数を、正解の文字数で割った値です。次のcer.pyは空白と改行を除いてから数えるので、行の区切り方や語の間の空白は誤りに入りません。全角と半角の違い(「(」と「(」など)は誤りに数え、別にUnicodeのNFKC正規化で全角英数・半角カナ・全角記号をそろえてから数えた値もNFKC=として出します。第2引数に-を渡すと標準入力を読み、-vで食い違った箇所を表示します。
cat > cer.py <<'EOF'
"""文字誤り率(CER)= 正解に直すのに要る挿入・削除・置換の回数 ÷ 正解の文字数。
空白と改行は比べる前に取り除く。NFKC= は全角・半角の違いをUnicodeのNFKC正規化でそろえてから数えた値。
使い方: python cer.py 正解.txt 結果.txt(- なら標準入力) [ラベル] [-v]"""
import sys
import unicodedata
from difflib import SequenceMatcher


def squash(text, nfkc=False):
    if nfkc:
        text = unicodedata.normalize("NFKC", text)
    return "".join(text.split())


def edit_distance(a, b):
    row = list(range(len(b) + 1))
    for i, ca in enumerate(a, 1):
        diag, row[0] = row[0], i
        for j, cb in enumerate(b, 1):
            diag, row[j] = row[j], min(row[j] + 1, row[j - 1] + 1, diag + (ca != cb))
    return row[-1]


args = [x for x in sys.argv[1:] if x != "-v"]
ref_text = open(args[0], encoding="utf-8").read()
hyp_text = sys.stdin.read() if args[1] == "-" else open(args[1], encoding="utf-8").read()
label = args[2] if len(args) > 2 else args[1]

ref, hyp = squash(ref_text), squash(hyp_text)
d = edit_distance(ref, hyp)
dn = edit_distance(squash(ref_text, True), squash(hyp_text, True))
print(f"{label:<8} CER={100 * d / len(ref):6.2f}%  NFKC={100 * dn / len(squash(ref_text, True)):6.2f}%  誤り {d}/{len(ref)}字")
if "-v" in sys.argv:
    for op, i1, i2, j1, j2 in SequenceMatcher(None, ref, hyp, autojunk=False).get_opcodes():
        if op != "equal":
            print(f"   正解「{ref[i1:i2]}」→ 結果「{hyp[j1:j2]}」")
EOFfor f in form notice mixed scan; do python cer.py $f.txt $f.paddle.txt $f; done
form CER= 3.09% NFKC= 1.85% 誤り 5/162字
notice CER= 0.00% NFKC= 0.00% 誤り 0/393字
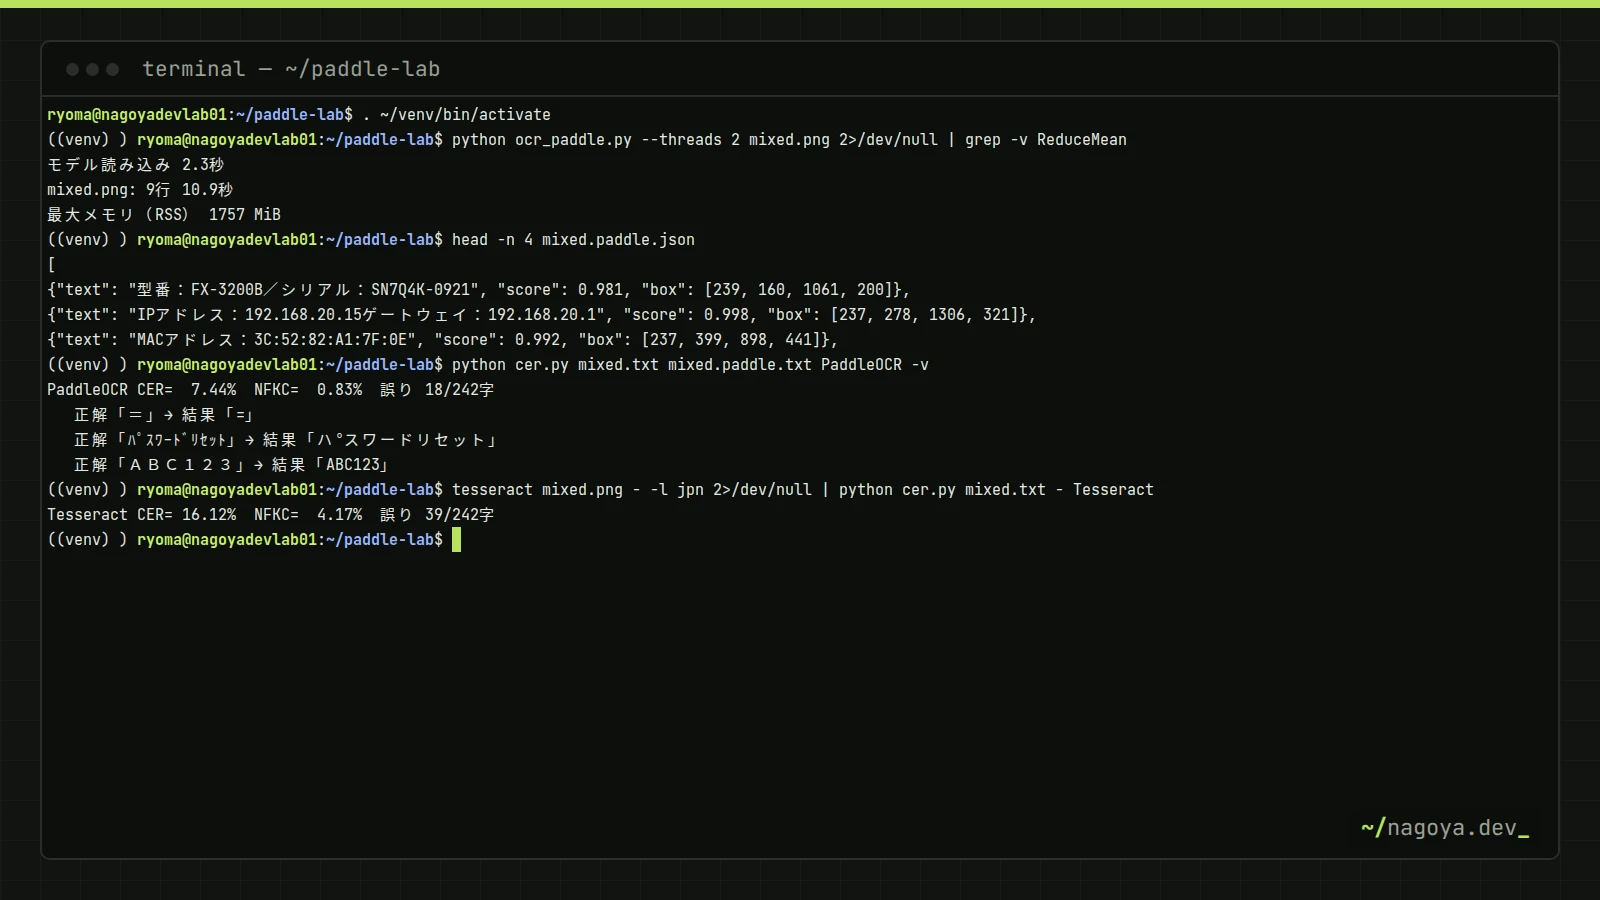
mixed CER= 7.44% NFKC= 0.83% 誤り 18/242字
scan CER= 0.25% NFKC= 0.25% 誤り 1/393字
python cer.py form.txt form.paddle.txt form -v; python cer.py mixed.txt mixed.paddle.txt mixed -v
form CER= 3.09% NFKC= 1.85% 誤り 5/162字
正解「ート」→ 結果「—卜」
正解「(」→ 結果「(」
正解「)」→ 結果「)」
正解「〜」→ 結果「~」
mixed CER= 7.44% NFKC= 0.83% 誤り 18/242字
正解「=」→ 結果「=」
正解「パスワードリセット」→ 結果「ハ°スワードリセット」
正解「ABC123」→ 結果「ABC123」お知らせ文は393字すべて正解、2度傾けて解像度を落としたスキャンも誤りは1字でした。申請書では「ノート」の長音記号「ー」が全角ダッシュ「—」(U+2014)に、カタカナの「ト」が形の似た漢字の「卜」(U+535C)になっています。括弧が半角に、波ダッシュ「〜」(U+301C)が全角チルダ「~」(U+FF5E)になったのは、見た目がほぼ同じでも文字コードが違う誤りです。
英数字混じりのmixed.pngでは、型番、IPアドレス、MACアドレス、メールアドレス、0とO・1とIが混ざったライセンスキーはすべて正解どおりでした。18字の誤りのほとんどは幅の違いで、全角の「=」と「ABC123」が半角に、半角カナの「パスワードリセット」が全角になり、半濁点だけが度の記号「°」に置き換わっています。NFKCでそろえると誤り率は0.83%まで下がります。全角・半角の違いを後処理でそろえる運用ならNFKCの列を、原文どおりの文字を残したい転記ならCERの列を見て判断してください。
Tesseract(jpn)と同じ画像・同じ採点で比べる
rootのシェルでTesseractと日本語の学習データを入れ、ここまでに入れたパッケージの版をまとめて記録します。
DEBIAN_FRONTEND=noninteractive apt-get install -y -qq --no-install-recommends tesseract-ocr tesseract-ocr-jpn >/dev/null 2>&1; echo "exit=$?"
exit=0
dpkg-query -W fonts-ipaexfont-gothic fonts-ipaexfont-mincho libgl1 libglib2.0-0t64 libgomp1 tesseract-ocr tesseract-ocr-jpn time
fonts-ipaexfont-gothic	00401-5
fonts-ipaexfont-mincho	00401-5
libgl1:amd64	1.7.0-1+b2
libglib2.0-0t64:amd64	2.84.4-3~deb13u5
libgomp1:amd64	14.2.0-19
tesseract-ocr	5.5.0-1+b1
tesseract-ocr-jpn	1:4.1.0-2
time 1.9-0.2作業ユーザーのシェルで、同じ4枚を-l jpnだけを指定して読み、同じcer.pyで採点します。
tesseract --version | head -n 1
tesseract 5.5.0
for f in form notice mixed scan; do tesseract $f.png $f.tess -l jpn 2>/dev/null; python cer.py $f.txt $f.tess.txt $f; done
form     CER=  3.09%  NFKC=  1.85%  誤り 5/162字
notice   CER=  2.29%  NFKC=  1.27%  誤り 9/393字
mixed    CER= 16.12%  NFKC=  4.17%  誤り 39/242字
scan     CER= 15.27%  NFKC= 14.25%  誤り 60/393字
python cer.py mixed.txt mixed.tess.txt mixed -v; python cer.py scan.txt scan.tess.txt scan -v | head -n 8
mixed    CER= 16.12%  NFKC=  4.17%  誤り 39/242字
   正解「:」→ 結果「:」
   正解「/」→ 結果「8プ」
   正解「:¥」→ 結果「:\」
   正解「)×」→ 結果「)x」
   正解「パスワードリセット」→ 結果「パ29-ドリセ」
   正解「:ABC123」→ 結果「:ABC123」
scan     CER= 15.27%  NFKC= 14.25%  誤り 60/393字
   正解「複合」→ 結果「司」
   正解「替」→ 結果「千」
   正解「設」→ 結果「」
正解「」→ 結果「ー」cat mixed.tess.txt
型番 : FX-3200B8プシリアル : SN7Q4K-0921
単価 : \48,600 (税込) x3台=\145,800
パ 29-ド リセ手順 (半角カナ)
全角英数 : ABC 1 23 半角英数 : ABC123| 画像 | PaddleOCR medium | PaddleOCR small | Tesseract 5.5.0(jpn) |
|---|---|---|---|
| form.png(申請書・162字) | 3.09%(NFKC 1.85%) | 2.47%(NFKC 1.23%) | 3.09%(NFKC 1.85%) |
| notice.png(お知らせ・393字) | 0.00% | 0.00% | 2.29%(NFKC 1.27%) |
| mixed.png(英数字混じり・242字) | 7.44%(NFKC 0.83%) | 8.26%(NFKC 0.83%) | 16.12%(NFKC 4.17%) |
| scan.png(劣化スキャン・393字) | 0.25% | 1.27% | 15.27%(NFKC 14.25%) |
申請書は同じ5字の誤りで並びましたが、ほかの3枚ではPaddleOCRの誤りがはっきり少なくなりました。差がいちばん大きかったのは劣化スキャンで、Tesseractは393字中60字を誤り、「複合」を「司」と読むように漢字そのものを取り違えています。英数字混じりの行でも、Tesseractは「3200B/」の「/」を「8プ」に、円記号を「\」に、半角カナを「パ 29-ド リセ」に変えました。smallの列は次の節で測ったものを先に載せています。
この比較はどちらも前処理なしの同じ条件です。Tesseractは傾き補正や拡大で誤りが大きく減ることをTesseract OCRで日本語を読み取るガイドで測っていて、スキャンPDFに検索用の文字を重ねるOCRmyPDFの手順もそちらにあります。前処理を足したTesseractとPaddleOCRの比較は、この記事ではしていません。
ここで、テスト画像の節でレイアウトエンジンをBASICに固定した理由を確かめておきます。Pillowのドキュメントによると、PyPIで配布されているPillowは、libfribidiが入っていればそれを実行時に読み込んで、複雑な文字の並べ方に対応するRAQMを使えるようになります。ベースイメージにはlibfribidi0がありませんが、tesseract-ocrの依存のlibpango-1.0-0経由で入りました。
docker run --rm python:3.12.15-slim-trixie dpkg-query -W libfribidi0
dpkg-query: no packages found matching libfribidi0apt-cache depends tesseract-ocr | grep -i pango
Depends: libpango-1.0-0
Depends: libpangocairo-1.0-0
dpkg-query -W libfribidi0; apt-cache rdepends --installed libfribidi0
libfribidi0:amd64 1.0.16-1
libfribidi0
Reverse Depends:
libpango-1.0-0python -c 'import hashlib; from PIL import Image, ImageDraw, ImageFont, features; p = "/usr/share/fonts/opentype/ipaexfont-gothic/ipaexg.ttf"; print("raqm", features.check("raqm"))
for e in (ImageFont.Layout.BASIC, ImageFont.Layout.RAQM):
im = Image.new("L", (1200, 80), 255); ImageDraw.Draw(im).text((10, 10), "型番:FX-3200B/シリアル:SN7Q4K-0921", font=ImageFont.truetype(p, 40, layout_engine=e), fill=0); print(e.name, hashlib.sha256(im.tobytes()).hexdigest()[:16])'
raqm True
BASIC 4352b55e8b61df3b
RAQM c4aca8e3a6ee8dd7同じ1行でも、BASICとRAQMでは描かれた画素のハッシュ値が違いました。make_docs.pyで指定を外すと、Tesseractを入れる前と後で別の画像ができ、ハッシュ値で再現を確かめられなくなります。
CPUでの処理時間と最大メモリ
処理時間は、モデルを読み込んだあとのpredict()1回分で、AMD EPYC 7713を2コア分に制限したコンテナで測りました。form.pngとnotice.pngはA4・300dpi相当(2480×3508画素)、mixed.pngは2480×1400画素、scan.pngは1240×1754画素です。前の節の--threads 2の結果に加えて、スレッド数を指定しない場合とsmallモデルを測ります。メモリの上限をいくつにすればよいかは、後半の節で確かめます。
grep -n "DEFAULT_CPU_THREADS =" ~/venv/lib/python3.12/site-packages/paddleocr/_constants.py
20:DEFAULT_CPU_THREADS = 10
python ocr_paddle.py form.png notice.png mixed.png scan.png | grep -v ReduceMean
モデル読み込み 3.0秒
form.png: 19行 32.0秒
notice.png: 10行 36.5秒
mixed.png: 9行 16.5秒
scan.png: 10行 13.6秒
最大メモリ(RSS) 3702 MiB
python ocr_paddle.py --threads 2 --tier small --tag small form.png notice.png mixed.png scan.png | grep -v ReduceMean
/home/ryoma/paddle-lab/ocr_paddle.py:31: UserWarning: `lang` and `ocr_version` will be ignored when model names or model directories are not `None`.
Using official model (PP-OCRv6_small_det), the model files will be automatically downloaded and saved in `/home/ryoma/.paddlex/official_models/PP-OCRv6_small_det`.
Using official model (PP-OCRv6_small_rec), the model files will be automatically downloaded and saved in `/home/ryoma/.paddlex/official_models/PP-OCRv6_small_rec`.
モデル読み込み 9.7秒
form.png: 19行 6.7秒
notice.png: 10行 7.4秒
mixed.png: 9行 2.8秒
scan.png: 10行 2.5秒
最大メモリ(RSS) 2157 MiB
for f in form notice mixed scan; do python cer.py $f.txt $f.small.txt $f; done
form     CER=  2.47%  NFKC=  1.23%  誤り 4/162字
notice   CER=  0.00%  NFKC=  0.00%  誤り 0/393字
mixed    CER=  8.26%  NFKC=  0.83%  誤り 20/242字
scan     CER=  1.27%  NFKC=  1.27%  誤り 5/393字
for f in form notice mixed scan; do /usr/bin/time -f "$f %e秒 %MKB" tesseract $f.png $f.tess -l jpn 2>&1 | grep 秒; done
form 0.92秒 87348KB
notice 1.50秒 90948KB
mixed 0.70秒 67968KB
scan 0.97秒 66304KB| 設定 | form.png | notice.png | mixed.png | scan.png | 最大メモリ |
|---|---|---|---|---|---|
| PaddleOCR medium・スレッド数は既定(10) | 32.0秒 | 36.5秒 | 16.5秒 | 13.6秒 | 3702 MiB |
PaddleOCR medium・--threads 2 | 24.1秒 | 26.9秒 | 11.9秒 | 12.2秒 | 3724 MiB |
PaddleOCR small・--threads 2 | 6.7秒 | 7.4秒 | 2.8秒 | 2.5秒 | 2157 MiB |
| Tesseract 5.5.0(jpn) | 0.92秒 | 1.50秒 | 0.70秒 | 0.97秒 | 90948KB(notice.png) |
PaddleOCRのcpu_threadsの既定値は10で、2コア分しか割り当てのないコンテナでは、スレッド数を2にしたほうがどの画像でも速くなりました(form.pngで32.0秒から24.1秒)。コンテナやVMで動かすときは、nprocではなく実際の割り当て(cpu.maxやVMのvCPU数)に合わせて指定してください。smallはmediumより速く、誤りは申請書で1字減り、英数字混じりで2字、劣化スキャンで4字増えました。Tesseractは1枚1.50秒以内、最大メモリは90948KBで、速さと軽さでは比べものになりません。
秒数は共用サーバーで測ったもので、実行のたびに揺れます。別の新しいコンテナで先に通した1回目(make_docs.pyはBASICの指定を書き足す前の版でしたが、画像のハッシュ値は同じ)では、スレッド数を指定しないmediumがform.png 32.9秒・notice.png 37.2秒・mixed.png 16.8秒・scan.png 15.3秒、Tesseractは0.69〜1.47秒でした。一方、4枚の認識結果のテキストは2回でハッシュ値まで一致し、誤り率は変わりませんでした。
前処理モジュールを有効にすると座標がずれる
CLIとAPIで前処理の指定を省くと、PaddleXの設定ファイルの値が使われます。この版では3つともTrueでした。
grep -n "use_doc_orientation_classify\|use_doc_unwarping\|use_textline_orientation" ~/venv/lib/python3.12/site-packages/paddlex/configs/pipelines/OCR.yaml
7:use_textline_orientation: True
12:    use_doc_orientation_classify: True
13: use_doc_unwarping: True作業ユーザーのシェルで、--preprocessで3つを有効にして、申請書と英数字混じりの2枚を読み直します。結果は.pre.jsonに分けて保存します。
python ocr_paddle.py --threads 2 --preprocess --tag pre form.png mixed.png | grep -v ReduceMean
Creating model: ('PP-LCNet_x1_0_doc_ori', None, None)
Creating model: ('UVDoc', None, None)
Creating model: ('PP-LCNet_x1_0_textline_ori', None, None)
モデル読み込み 12.2秒
form.png: 19行 27.6秒
mixed.png: 9行 13.0秒
最大メモリ(RSS) 3687 MiB
head -n 2 mixed.paddle.json mixed.pre.json
==> mixed.paddle.json <==
[
{"text": "型番:FX-3200B/シリアル:SN7Q4K-0921", "score": 0.981, "box": [239, 160, 1061, 200]},
==> mixed.pre.json <==
[
{"text": "型番:FX-3200B/シリアル:SN7Q4K-0921", "score": 1.0, "box": [139, 137, 1028, 192]},
python cer.py form.txt form.pre.txt form -v; python cer.py mixed.txt mixed.pre.txt mixed
form     CER=  3.70%  NFKC=  2.47%  誤り 6/162字
   正解「ート」→ 結果「—卜」
   正解「(」→ 結果「(」
   正解「)」→ 結果「)」
   正解「産」→ 結果「產」
   正解「〜」→ 結果「~」
mixed CER= 7.85% NFKC= 0.83% 誤り 19/242字同じ1行目の座標が[239, 160, 1061, 200]から[139, 137, 1028, 192]に動きました。歪み補正(UVDoc)が補正したあとの画像で座標を返すためです。誤りは申請書で1字増え(「資産番号」の「産」が字形の違う「產」に)、英数字混じりで1字増え、処理時間は前の節の--threads 2の結果(24.1秒・11.9秒)より長くなりました。
スキャナーで取り込んだ平らな書類では、3つの前処理をFalseにしてください。特に、結果の座標を元の画像に重ねて表示したり、帳票の決まった位置から値を切り出したりする用途でuse_doc_unwarpingを有効にすると、座標がずれて別の欄を拾います。スマートフォンで撮った紙や、90度・180度回ったページが混ざる束を扱うときに限って、効果を自分の画像で測ってから有効にします。
画像は外部に送られるか:通信先の記録とネットワーク遮断での確認
情シスとして確かめたいのは、社外秘の書類を読ませたときに画像やテキストがどこかへ送られないかです。2つの方法で確かめます。1つは、Pythonの監査フック(sys.addaudithook)で、名前解決(socket.getaddrinfo)と接続(socket.connect)を記録する方法です。もう1つは、ネットワークの無いコンテナで認識が最後まで動くかを見る方法です。
cat > netlog.py <<'EOF'
"""Pythonのsocketが名前解決したホストと接続の回数を記録しながら、スクリプトかモジュールを実行する。
使い方: python netlog.py スクリプト.py 引数... / python netlog.py -m モジュール 引数..."""
import atexit
import runpy
import sys

hosts, connects = [], []


def hook(event, args):
    if event == "socket.getaddrinfo" and args[0] not in hosts:
        hosts.append(args[0])
        print(f"[netlog] 名前解決: {args[0]}", file=sys.stderr, flush=True)
    elif event == "socket.connect":
        connects.append(args[1])


@atexit.register
def report():
    print(f"[netlog] 名前解決したホスト {len(hosts)}件、接続 {len(connects)}回", file=sys.stderr, flush=True)


sys.addaudithook(hook)
if sys.argv[1] == "-m":
    sys.argv = sys.argv[2:]
    runpy.run_module(sys.argv[0], run_name="__main__", alter_sys=True)
else:
    sys.argv = sys.argv[1:]
    runpy.run_path(sys.argv[0], run_name="__main__")
EOFあとでCLIの結果画像を調べるときに使うcount_ink.pyも、ここで作っておきます。結果画像の右半分(認識した文字を描き込む側)にある暗い画素を数えるだけのスクリプトです。
cat > count_ink.py <<'EOF'
"""結果画像の右半分(認識した文字を描き込む側)にある暗い画素を数える。0なら文字が描かれていない。"""
import sys

from PIL import Image

for path in sys.argv[1:]:
    im = Image.open(path).convert("L")
    right = im.crop((im.width // 2, 0, im.width, im.height))
    print(path, sum(right.histogram()[:128]))
EOF
監査フックが記録できるのは、Pythonのsocketモジュールを通る通信だけです。C++やRustで書かれた拡張が直接開く通信は記録されないので、この記録だけで「通信していない」とは言えません。そこを補うのが、あとで行うネットワーク遮断の確認です。まず、モデルのキャッシュを空のディレクトリに向けた初回の状態、疎通確認を止めた状態、キャッシュ済みの通常の状態の3つを、作業ユーザーのシェルで比べます。
PADDLE_PDX_CACHE_HOME=/tmp/fresh python netlog.py ocr_paddle.py --threads 2 mixed.png 2>&1 | grep -E "netlog|Checking|Using official|モデル|行"
Checking connectivity to the model hosters, this may take a while. To bypass this check, set `PADDLE_PDX_DISABLE_MODEL_SOURCE_CHECK` to `True`.
[netlog] 名前解決: huggingface.co
[netlog] 名前解決: aistudio.baidu.com
[netlog] 名前解決: modelscope.cn
[netlog] 名前解決: paddle-model-ecology.bj.bcebos.com
Using official model (PP-OCRv6_medium_det), the model files will be automatically downloaded and saved in `/tmp/fresh/official_models/PP-OCRv6_medium_det`.
Using official model (PP-OCRv6_medium_rec), the model files will be automatically downloaded and saved in `/tmp/fresh/official_models/PP-OCRv6_medium_rec`.
モデル読み込み 12.1秒
mixed.png: 9行 11.5秒
[netlog] 名前解決したホスト 4件、接続 9回
PADDLE_PDX_CACHE_HOME=/tmp/fresh2 PADDLE_PDX_DISABLE_MODEL_SOURCE_CHECK=True python netlog.py ocr_paddle.py --threads 2 mixed.png 2>&1 | grep -E "netlog|skipped|Using official|モデル|行"
Connectivity check to the model hoster has been skipped because `PADDLE_PDX_DISABLE_MODEL_SOURCE_CHECK` is enabled.
Using official model (PP-OCRv6_medium_det), the model files will be automatically downloaded and saved in `/tmp/fresh2/official_models/PP-OCRv6_medium_det`.
[netlog] 名前解決: huggingface.co
Using official model (PP-OCRv6_medium_rec), the model files will be automatically downloaded and saved in `/tmp/fresh2/official_models/PP-OCRv6_medium_rec`.
モデル読み込み 8.1秒
mixed.png: 9行 10.8秒
[netlog] 名前解決したホスト 1件、接続 5回
python netlog.py ocr_paddle.py --threads 2 mixed.png 2>&1 | grep -E "netlog|モデル|行"
モデル読み込み 2.4秒
mixed.png: 9行 10.8秒
[netlog] 名前解決したホスト 0件、接続 0回
rm -rf /tmp/fresh /tmp/fresh2
grep -n 'PADDLE_PDX_MODEL_SOURCE"\|PADDLE_PDX_HUGGING_FACE_ENDPOINT"\|PADDLE_PDX_LOCAL_FONT_FILE_PATH"' ~/venv/lib/python3.12/site-packages/paddlex/utils/flags.py
64:LOCAL_FONT_FILE_PATH = get_flag_from_env_var("PADDLE_PDX_LOCAL_FONT_FILE_PATH", None)
72:MODEL_SOURCE = os.environ.get("PADDLE_PDX_MODEL_SOURCE", "huggingface").lower()
78:    "PADDLE_PDX_HUGGING_FACE_ENDPOINT", "https://huggingface.co"
初回は、モデルの取得元の候補4か所(huggingface.co、aistudio.baidu.com、modelscope.cn、paddle-model-ecology.bj.bcebos.com)に疎通を確かめてから、既定の取得元であるHugging Faceからモデルを落としていました。PADDLE_PDX_DISABLE_MODEL_SOURCE_CHECK=Trueにすると疎通確認が省かれ、監査フックの記録では名前解決はhuggingface.coだけになります。名前解決の記録はどれも「モデル読み込み」の表示より前に出ていて、キャッシュ済みの通常の実行では0件・0回でした。取得元はPADDLE_PDX_MODEL_SOURCE(既定はhuggingface)、Hugging Faceの接続先はPADDLE_PDX_HUGGING_FACE_ENDPOINTで変えられます。ファイル本体の転送で別のホストを使っているかどうかは、この記録からは分かりません。
次に、ネットワークの無いコンテナで動かします。Dockerホストで、ここまでのコンテナ(モデル、仮想環境、スクリプト、テスト画像を含む)をイメージに保存し、そのイメージを--network noneで起動します。docker commitが表示するイメージIDは省いています。このイメージは次のメモリの節でも使います。
docker commit paddleocr-japanese-ocr-python-lab paddleocr-japanese-ocr-python:offline
docker run --rm --network none --memory 4g --memory-swap 4g --cpus 2 --hostname nagoyadevlab01 -u ryoma -w /home/ryoma/paddle-lab paddleocr-japanese-ocr-python:offline sh -c 'ls /sys/class/net; getent hosts huggingface.co; echo "exit=$?"'
lo
exit=2
docker run --rm --network none --memory 4g --memory-swap 4g --cpus 2 --hostname nagoyadevlab01 -u ryoma -w /home/ryoma/paddle-lab paddleocr-japanese-ocr-python:offline sh -c '. ~/venv/bin/activate && python netlog.py ocr_paddle.py --threads 2 form.png notice.png mixed.png scan.png 2>&1 | grep -E "netlog|モデル|行|メモリ"; for f in form notice mixed scan; do python cer.py $f.txt $f.paddle.txt $f; done'
モデル読み込み 2.6秒
form.png: 19行 24.2秒
notice.png: 10行 27.0秒
mixed.png: 9行 10.3秒
scan.png: 10行 9.7秒
最大メモリ(RSS) 3660 MiB
[netlog] 名前解決したホスト 0件、接続 0回
form     CER=  3.09%  NFKC=  1.85%  誤り 5/162字
notice   CER=  0.00%  NFKC=  0.00%  誤り 0/393字
mixed    CER=  7.44%  NFKC=  0.83%  誤り 18/242字
scan CER= 0.25% NFKC= 0.25% 誤り 1/393字コンテナにはループバック(lo)しか無く、名前解決も失敗します(getentの終了コード2)。その状態で4枚とも最後まで読め、誤り率はネットワークがあるときと同じでした。認識に通信が必要な処理があれば、ここで失敗するはずです。ただし、ネイティブのコードが通信を試みて失敗し、そのまま処理を続けた可能性までは、この確認では否定できません。確かめたのは、PaddleOCR 3.7.0・PaddleX 3.7.2・PaddlePaddle 3.2.2と、この記事のocr_paddle.pyの組み合わせです。ほかの版や、PaddleOCR-VLなどほかの機能については何も言えません。
CLIで--save_pathを付けたときのフォントの取得も、ネットワークなしで試します。同じイメージから起動し、保存済みのsimfang.ttfを消してから実行しました。暗い画素は先に作ったcount_ink.pyで数えます。
docker run --rm --network none --memory 4g --memory-swap 4g --cpus 2 --hostname nagoyadevlab01 -u ryoma -w /home/ryoma/paddle-lab paddleocr-japanese-ocr-python:offline sh -c '. ~/venv/bin/activate && rm ~/.paddlex/fonts/simfang.ttf && paddleocr ocr -i mixed.png --lang japan --use_doc_orientation_classify False --use_doc_unwarping False --use_textline_orientation False --cpu_threads 2 --save_path out-offline 2>&1 | grep -c Connecting; python count_ink.py out/mixed_ocr_res_img.png out-offline/mixed_ocr_res_img.png'
9
out/mixed_ocr_res_img.png 25220
out-offline/mixed_ocr_res_img.png 0
docker run --rm --network none --memory 4g --memory-swap 4g --cpus 2 --hostname nagoyadevlab01 -u ryoma -w /home/ryoma/paddle-lab -e PADDLE_PDX_LOCAL_FONT_FILE_PATH=/usr/share/fonts/opentype/ipaexfont-gothic/ipaexg.ttf paddleocr-japanese-ocr-python:offline sh -c '. ~/venv/bin/activate && rm ~/.paddlex/fonts/simfang.ttf && paddleocr ocr -i mixed.png --lang japan --use_doc_orientation_classify False --use_doc_unwarping False --use_textline_orientation False --cpu_threads 2 --save_path out-offline 2>&1 | grep -c Connecting; python count_ink.py out-offline/mixed_ocr_res_img.png'
0
out-offline/mixed_ocr_res_img.png 40040フォントが無いと、CLIはフォントの取得を9回試みてから処理を続け、結果画像は作られるものの、右半分に文字が1つも描かれていませんでした(暗い画素0。ネットワークがあるときに作った画像は25220)。PADDLE_PDX_LOCAL_FONT_FILE_PATHに手元のIPAexゴシックを指定すると、取得を試みずに日本語が描かれます(40040)。結果画像を作る使い方では、この環境変数を最初から設定しておくことを勧めます。
公式サイトには、PaddleOCRをインストールなしで試せるExperience CenterとAPIがあります。こちらは画像を事業者のサービスに送る仕組みで、ここでの確認はライブラリを手元で動かした場合の話です。社外秘の書類を公式サイトのデモに貼り付けて精度を試すのは避けてください。
メモリの上限をいくつにするか
処理時間の節で見たとおり、上限4GiBのコンテナでmediumは3702〜3724 MiBまで使っていました。上限を下げても動くのかを、前の節で保存したイメージを使って確かめます(Dockerホストで実行。ネットワークも切っていますが、ここで見るのはメモリだけです)。
docker run --rm --network none --memory 3g --memory-swap 3g --cpus 2 --hostname nagoyadevlab01 -u ryoma -w /home/ryoma/paddle-lab paddleocr-japanese-ocr-python:offline sh -c '. ~/venv/bin/activate && python ocr_paddle.py --threads 2 --tier medium form.png notice.png mixed.png scan.png 2>/dev/null > run.log; echo "exit=$?"; grep -v ReduceMean run.log'
exit=137
モデル読み込み 3.4秒
form.png: 19行 23.5秒
docker run --rm --network none --memory 2g --memory-swap 2g --cpus 2 --hostname nagoyadevlab01 -u ryoma -w /home/ryoma/paddle-lab paddleocr-japanese-ocr-python:offline sh -c '. ~/venv/bin/activate && python ocr_paddle.py --threads 2 --tier medium form.png notice.png mixed.png scan.png 2>/dev/null > run.log; echo "exit=$?"; grep -v ReduceMean run.log'
exit=137
モデル読み込み 3.5秒
docker run --rm --network none --memory 2g --memory-swap 2g --cpus 2 --hostname nagoyadevlab01 -u ryoma -w /home/ryoma/paddle-lab paddleocr-japanese-ocr-python:offline sh -c '. ~/venv/bin/activate && python ocr_paddle.py --threads 2 --tier small form.png notice.png mixed.png scan.png 2>/dev/null > run.log; echo "exit=$?"; grep -v ReduceMean run.log'
exit=0
モデル読み込み 3.5秒
form.png: 19行 7.4秒
notice.png: 10行 8.1秒
mixed.png: 9行 2.8秒
scan.png: 10行 2.5秒
最大メモリ(RSS) 2077 MiB
docker run --rm --network none --memory 3g --memory-swap 3g --cpus 2 --hostname nagoyadevlab01 -u ryoma -w /home/ryoma/paddle-lab paddleocr-japanese-ocr-python:offline sh -c '. ~/venv/bin/activate && for f in form notice mixed scan; do python ocr_paddle.py --threads 2 $f.png 2>/dev/null | grep -v ReduceMean | grep -v モデル; done'
form.png: 19行 22.1秒
最大メモリ(RSS) 3237 MiB
notice.png: 10行 27.3秒
最大メモリ(RSS) 3237 MiB
mixed.png: 9行 10.8秒
最大メモリ(RSS) 1653 MiB
scan.png: 10行 10.9秒
最大メモリ(RSS) 1249 MiBexit=137は、プロセスがシグナル9(SIGKILL)で終了したことを示します(128+9)。mediumで4枚を1つのプロセスで続けて読むと、上限3GiBでは1枚目を終えたあと2枚目の途中で強制終了しました(同じコマンドを2回実行して、2回ともform.pngのあとで止まりました)。上限2GiBでは1枚目も終わりません。1枚ずつ別のプロセスで読むと3GiBでも4枚とも通り、A4の2枚は最大3237 MiBでした。smallは2GiBの上限で4枚とも通っています。
ここから決めたワーカー1つあたりの目安は、A4・300dpi相当の画像を続けて処理するならmediumに4GiB、3GiBしか取れないなら1ページずつプロセスを分ける、2GiBならsmall、です。1枚ずつなら通り、続けて読むと通らなかったので、大量処理のワーカーは一定のページ数ごとにプロセスを作り直す設計にしておくと安全です。
つまずきポイント
NotImplementedError: ConvertPirAttribute2RuntimeAttribute not support(paddlepaddle 3.3.1)
paddlepaddleを執筆時点の最新3.3.1にすると、どうなるかを再現します。コンテナの作業ユーザーのシェル(~/paddle-lab)に戻り、PyPIの最新版を確かめてから、別の仮想環境に3.3.1を入れて有効にし、同じスクリプトを実行しました(執筆時点)。
pip index versions paddlepaddle 2>/dev/null | head -n 1
paddlepaddle (3.3.1)
python3 -m venv ~/venv-331 && . ~/venv-331/bin/activate && pip install -q paddlepaddle==3.3.1 paddleocr==3.7.0 paddlex==3.7.2 pillow==13.0.0; echo "exit=$?"

[notice] A new release of pip is available: 25.0.1 -> 26.2.2
[notice] To update, run: pip install --upgrade pip
exit=0
python ocr_paddle.py --threads 2 mixed.png 2>&1 | tail -n 3
    self.predictor.run()
NotImplementedError: (Unimplemented) ConvertPirAttribute2RuntimeAttribute not support [pir::ArrayAttribute<pir::DoubleAttribute>] (at /paddle/paddle/fluid/framework/new_executor/instruction/onednn/onednn_instruction.cc:116)エラーの位置はonednn_instruction.ccで、CPU推論を速くするoneDNN(旧称MKL-DNN)の経路で止まっています。インストールは成功しているので、最初の画像を読むまで問題に気づけません。対処は、paddlepaddleを3.2.2に固定することです。
enable_mkldnn を False にすると、遅くなりA4では強制終了した
oneDNNを使わない設定(--enable_mkldnn False)にすればエラーは避けられます。同じ3.3.1の仮想環境のまま、時間と最大メモリを測りました。
/usr/bin/time -f "%e秒 %MKB" paddleocr ocr -i mixed.png --lang japan --use_doc_orientation_classify False --use_doc_unwarping False --use_textline_orientation False --cpu_threads 2 --enable_mkldnn False > /tmp/nomkl-mixed.log 2>&1; echo "exit=$?"; tail -n 2 /tmp/nomkl-mixed.log | cut -c 1-120
exit=0
52.72秒 3139120KB
/usr/bin/time -f "%e秒 %MKB" paddleocr ocr -i notice.png --lang japan --use_doc_orientation_classify False --use_doc_unwarping False --use_textline_orientation False --cpu_threads 2 --enable_mkldnn False > /tmp/nomkl-notice.log 2>&1; echo "exit=$?"; tail -n 2 /tmp/nomkl-notice.log | cut -c 1-120
exit=137
Command terminated by signal 9
18.08秒 4152192KB
rm -rf ~/venv-331mixed.pngは読めましたが52.72秒かかり(3.2.2でoneDNNを使った場合はCLIで約11秒)、最大メモリは3139120KBでした。A4のnotice.pngは4GiBの上限に達してシグナル9で終了しています。回避策としては使えないので、確認が終わったらrm -rf ~/venv-331で消し、. ~/venv/bin/activateで元の環境に戻ります。
Exception: No available model hosting platforms detected
モデルのキャッシュが無い状態でネットワークも無いと、モデルを作る段階で止まります。保存したイメージで、キャッシュの場所を空のディレクトリに向けて再現しました(Dockerホストで実行)。
docker run --rm --network none --memory 4g --memory-swap 4g --cpus 2 --hostname nagoyadevlab01 -u ryoma -w /home/ryoma/paddle-lab -e PADDLE_PDX_CACHE_HOME=/tmp/empty paddleocr-japanese-ocr-python:offline sh -c '. ~/venv/bin/activate && python ocr_paddle.py mixed.png 2>&1 | tail -n 2'
    raise Exception(msg)
Exception: No available model hosting platforms detected. Please check your network connection.キャッシュの場所は、既定では実行ユーザーのホームの~/.paddlexです。サービスとして別のユーザーで動かしたり、コンテナのHOMEが変わったりすると、取得済みのモデルが見つからずにこのエラーになります。PADDLE_PDX_CACHE_HOMEでモデルを置いた場所を指定するか、official_modelsディレクトリごとコピーしてください。
動作確認
最後に、作業ユーザーのシェル(~/paddle-lab)で次を実行し、記事と同じ状態になっているかを確かめます。
python -c "import paddle, paddleocr; print(paddle.__version__, paddleocr.__version__)"; ls ~/.paddlex/official_models
3.2.2 3.7.0
PP-LCNet_x1_0_doc_ori
PP-LCNet_x1_0_textline_ori
PP-OCRv6_medium_det
PP-OCRv6_medium_rec
PP-OCRv6_small_det
PP-OCRv6_small_rec
UVDoc
grep -m1 '^license:' ~/.paddlex/official_models/*/README.md
/home/ryoma/.paddlex/official_models/PP-LCNet_x1_0_doc_ori/README.md:license: apache-2.0
/home/ryoma/.paddlex/official_models/PP-LCNet_x1_0_textline_ori/README.md:license: apache-2.0
/home/ryoma/.paddlex/official_models/PP-OCRv6_medium_det/README.md:license: apache-2.0
/home/ryoma/.paddlex/official_models/PP-OCRv6_medium_rec/README.md:license: apache-2.0
/home/ryoma/.paddlex/official_models/PP-OCRv6_small_det/README.md:license: apache-2.0
/home/ryoma/.paddlex/official_models/PP-OCRv6_small_rec/README.md:license: apache-2.0
/home/ryoma/.paddlex/official_models/UVDoc/README.md:license: apache-2.0. ~/venv/bin/activate
python ocr_paddle.py --threads 2 mixed.png 2>/dev/null | grep -v ReduceMean
モデル読み込み 2.7秒
mixed.png: 9行 11.4秒
最大メモリ(RSS) 1652 MiB
head -n 4 mixed.paddle.json
[
{"text": "型番:FX-3200B/シリアル:SN7Q4K-0921", "score": 0.981, "box": [239, 160, 1061, 200]},
{"text": "IPアドレス:192.168.20.15ゲートウェイ:192.168.20.1", "score": 0.998, "box": [237, 278, 1306, 321]},
{"text": "MACアドレス:3C:52:82:A1:7F:0E", "score": 0.992, "box": [237, 399, 898, 441]},
python cer.py mixed.txt mixed.paddle.txt PaddleOCR -v
PaddleOCR CER= 7.44% NFKC= 0.83% 誤り 18/242字
正解「=」→ 結果「=」
正解「パスワードリセット」→ 結果「ハ°スワードリセット」
正解「ABC123」→ 結果「ABC123」
tesseract mixed.png - -l jpn 2>/dev/null | python cer.py mixed.txt - Tesseract
Tesseract CER= 16.12% NFKC= 4.17% 誤り 39/242字版が3.2.2と3.7.0で、自動取得された7つのモデルのモデルカードがどれもlicense: apache-2.0、JSONの文字と座標、PaddleOCRとTesseractの誤り率が上と同じなら、再現できています。秒数と最大メモリはCPUと負荷で変わるので、一致しなくても問題ありません。誤り率が違うときは、sha256sum *.pngでテスト画像のハッシュ値を、pip listで版を、この記事の値と比べてください。
OCRエンジンの選び方:PaddleOCR・Tesseract・クラウドのOCR API
今回の実測と公式の記載(執筆時点)を並べます。クラウドのOCR APIは、この記事では試していません。
| 観点 | PaddleOCR 3.7.0(CPU) | Tesseract 5.5.0(jpn) | クラウドのOCR API |
|---|---|---|---|
| 英数字混じり・劣化スキャンの誤り(今回の2枚) | mediumで18字・1字、smallで20字・5字 | 39字・60字 | 測っていない |
| A4・300dpi相当1枚の時間(2コア) | スレッド数2でmediumは約22〜27秒、smallは7秒前後 | 1.50秒以内 | 測っていない |
| メモリの目安(今回の上限での結果) | mediumは4GiBで完走、3GiBは1ページずつなら完走。smallは2GiBで完走 | 最大90948KB | 手元では不要 |
| 書類の置き場所 | 手元。モデル取得後はネットワークなしで同じ結果 | 手元 | 事業者のサービスに送る |
| 外への通信 | 初回のモデル取得(huggingface.coなど、既定では4ホストへの疎通確認)と、CLIの結果画像用フォント | パッケージの取得時(遮断しての確認はTesseractのガイドで実施) | 処理のたびに発生 |
| ライセンス(執筆時点) | Apache License 2.0(コード、今回のモデルのモデルカード) | Apache License 2.0 | 各社の利用規約と契約 |
判断の順番はこう考えています。社外に出せない書類で、型番・資産番号・金額のような英数字が多いもの、スキャンの質が揃わないものは、PaddleOCRを選びます。CPUだけならsmallから始め、自分の書類でcer.pyの結果が許容範囲を超えるものだけmediumに切り替えます。ワーカー1つにsmallで2GiB、mediumで4GiBを見込み、cpu_threadsは割り当てたコア数に合わせます。
きれいな活字の書類を軽いマシンで大量にさばく場合や、スキャンPDFに検索用の文字を重ねたい場合は、TesseractとOCRmyPDFが向いています。今回は1枚1.50秒以内・最大メモリ90948KBで動き、前処理で誤りを減らせることはTesseractのガイドで測っています。PDFに文字の層を重ねる役割はOCRmyPDFに任せ、PaddleOCRとは分けて考えるのが現実的です。
手書き、罫線の多い帳票の構造化、大量の処理を短時間で終える必要がある場合は、PaddleOCR-VLやクラウドのOCR APIが候補になりますが、どちらもこの記事では実行していません。同じcer.pyで自分の書類を測ってから決めてください。クラウドに送る場合は、保存期間や学習への利用の有無を契約で確かめる必要があり、その考え方は生成AIの社内利用ガイドラインの作り方で整理しています。どれを選んでも、金額や型番を転記する用途では、形式チェックと人の確認を残してください。
よくある質問
PaddleOCRは商用利用できますか?
リポジトリはApache License 2.0で公開されていて、今回自動で取得された7つのモデルも、同梱のモデルカードのlicense欄はすべてapache-2.0でした(執筆時点)。Apache 2.0は商用利用を認めていますが、再配布するときはライセンス文と著作権表示を含めるなどの条件があります。OpenCVなど依存パッケージのライセンスも、配布の形に合わせて確認してください。
PaddleOCRは安全ですか?画像が外部に送られますか?
今回の版とスクリプトでは、モデルの取得後はネットワークの無いコンテナでも同じ結果が出て、Pythonからの接続は0回でした。通信が起きたのは、モデルの初回取得(huggingface.coほか3ホストへの疎通確認を含む)と、CLIで結果画像を描くためのフォント取得です。公式サイトのデモやAPIは画像を事業者に送る別の仕組みです。
PaddleOCRはGPUなしで動きますか?
動きます。数字はすべてCPU(2コア分)で測ったもので、A4・300dpi相当の1枚はスレッド数2でmediumが約22〜27秒、smallが7秒前後でした。メモリ上限はmediumに4GiB、smallに2GiBで足りました。GPU版のPaddlePaddleはNVIDIAドライバーの版に条件があり(公式手順ではCUDA 12.6版で550.54.14以上)、GPUでの動作はこの記事では実行していません。
日本語にはPaddleOCRとTesseractのどちらが強いですか?
今回の4枚では、きれいな申請書は同じ誤り率(3.09%)で、英数字混じりの行(7.44%対16.12%)と傾き・ノイズのあるスキャン(0.25%対15.27%)でPaddleOCRの誤りがはっきり少なくなりました。一方、時間はTesseractが1枚1.50秒以内、PaddleOCR mediumはA4・300dpi相当の2枚で22秒以上でした。自分の書類を数枚選び、同じcer.pyで測ってから決めてください。
まとめ
PaddleOCR 3.7.0はpaddlepaddle 3.2.2と組み合わせ、python:3.12-slimではlibgl1・libglib2.0-0t64・libgomp1を足すと動きました。lang="japan"で使われるのは、50言語を1つで扱うPP-OCRv6のモデルです。
自作の4枚では、英数字混じりと劣化スキャンでTesseractより誤りがはっきり少なく、その代わりA4・300dpi相当の1枚に7〜27秒(スレッド数2)かかり、ワーカーにはメモリ2〜4GiBの上限が必要でした。cpu_threadsは割り当てたコア数に合わせ、平らなスキャンでは3つの前処理を切ります。モデルを一度取得すれば、ネットワークの無いコンテナでも同じ結果が出ました。
次の一歩として、自分の書類を3枚スキャンし、正解テキストを手で打ってmake_docs.pyの画像の代わりに置き、ocr_paddle.py --tier smallと--tier medium、tesseractの結果をcer.pyで比べてください。