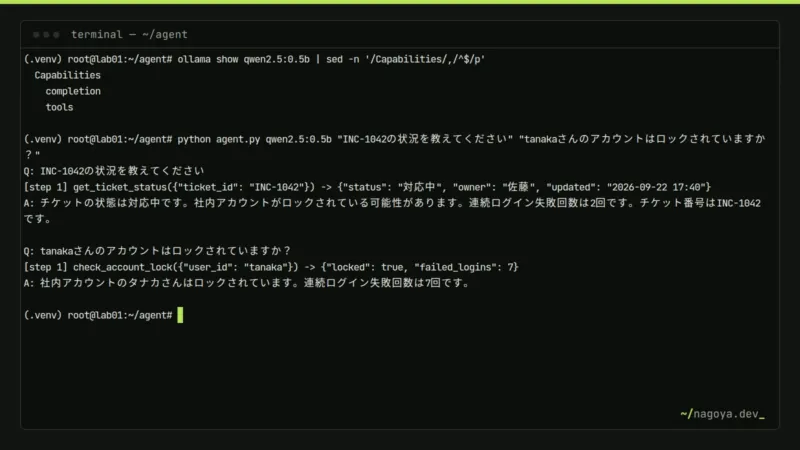
Tesseract OCRで日本語を読み取る:精度を左右する設定とPDFの検索可能化
Tesseract 5.5.0で自作の日本語画像を読み、傾き・解像度・影・--psm・言語データを1つずつ変えて文字誤り率を実測。OCRmyPDFでスキャンPDFを検索可能にする…
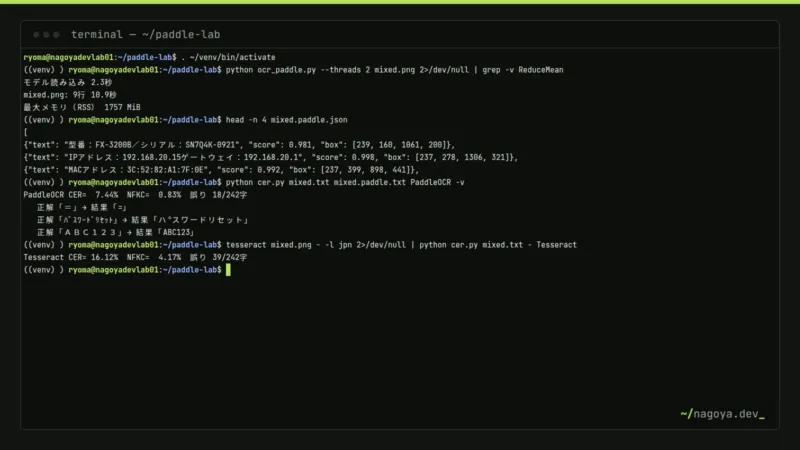
生成AI、ローカルLLM、RAG、MLOps、AIガバナンス。企業でAIを安全に本番運用するための実践ガイドと解説。
Tesseract 5.5.0で自作の日本語画像を読み、傾き・解像度・影・--psm・言語データを1つずつ変えて文字誤り率を実測。OCRmyPDFでスキャンPDFを検索可能にする…
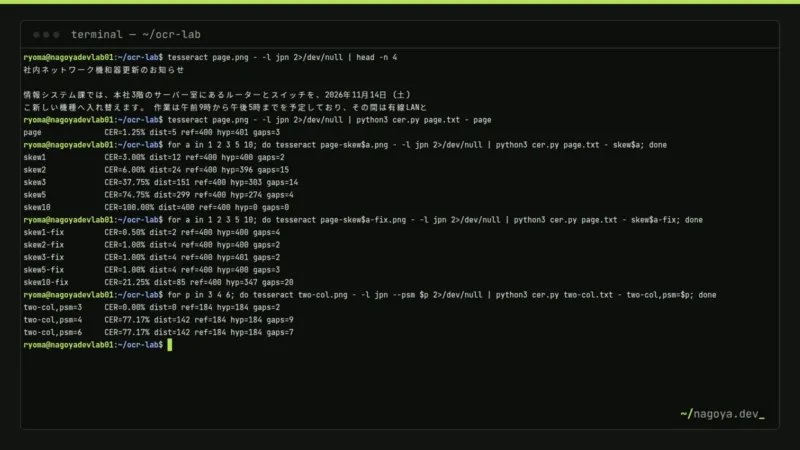
自作の日本語PDF・Word・ExcelをMarkItDown 0.1.8とDocling 2.130で変換し、速度・メモリ・表と見出しの再現・OCRを実測。RAG取り込みの判断…
生成AIのリスクを入力・参照データ・ツール・出力・基盤・費用の通り道で整理。間接インジェクションの手口、画像URL経由の漏えい、公開ポートの確認、着手の順番まで具体的にまとめまし…
LoRA(低ランク適応)の仕組みを実際のモデルのパラメータ数で確認し、プロンプト改善・RAG・追加学習のどれで何が直るかを判断表と手順で整理。画像生成のLoRAや通信のLoRaと…
業務用プロンプトを5つの部品で組み立てる方法と、正解付きの評価セットで版を比べる検証手順を実例で解説。丁寧に書いた版が小型モデルでは負けた実測結果と、その読み解き方も載せています。
LLM(大規模言語モデル)の仕組みを、実際のトークン分割と次トークンの確率の値で説明。作られ方、コンテキストウィンドウ、ハルシネーションの原因、業務に使えるかの判断基準をまとめま…
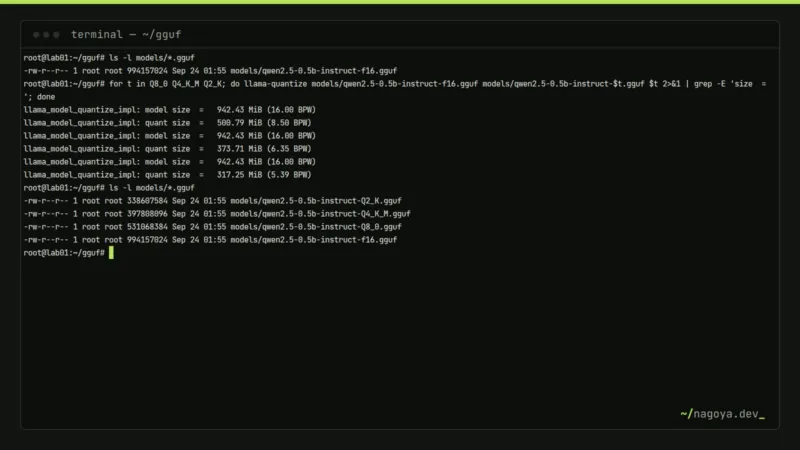
GGUFの中身と量子化の仕組みを、llama.cppでQwen2.5-0.5Bを変換・量子化して確認。型名どおりにならないテンソル、perplexityの変化、埋め込まれた生成設…
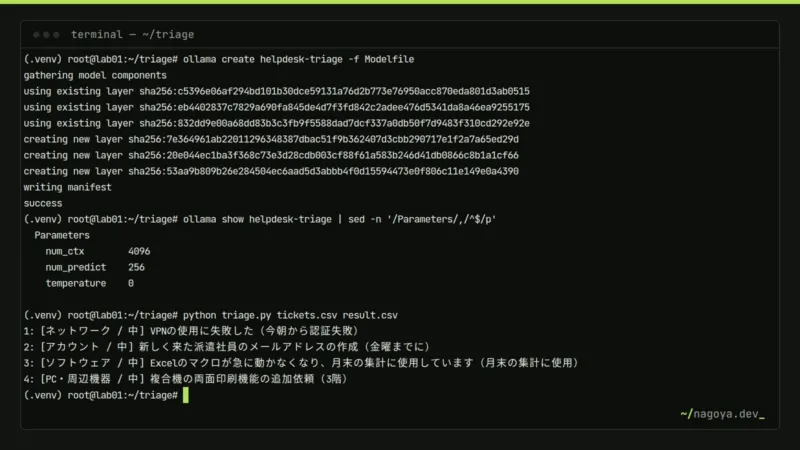
Modelfileで役割・判断基準・会話例を固定し、OllamaのPythonライブラリで問い合わせを仕分けるCSVツールを作成。構造化出力とpydanticでの検証、実際のエラ…
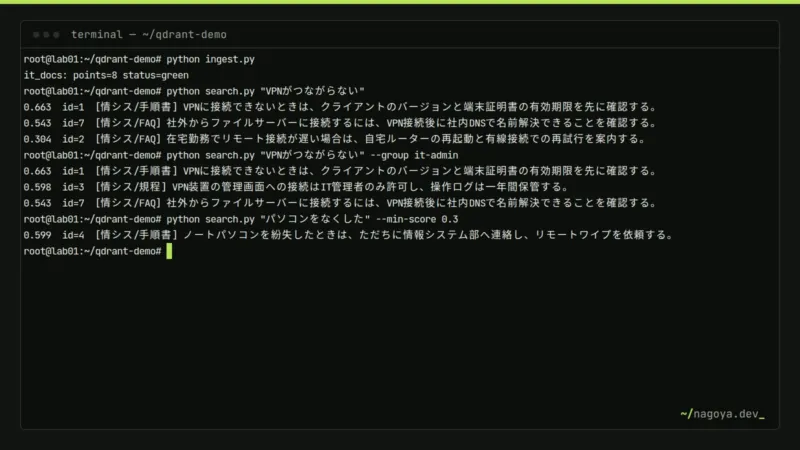
QdrantをAPIキー付きでDocker起動し、fastembedで日本語の社内文書を登録して、権限グループ・部署・更新日で絞り込む検索を実装。日本語全文インデックスの注意点や…
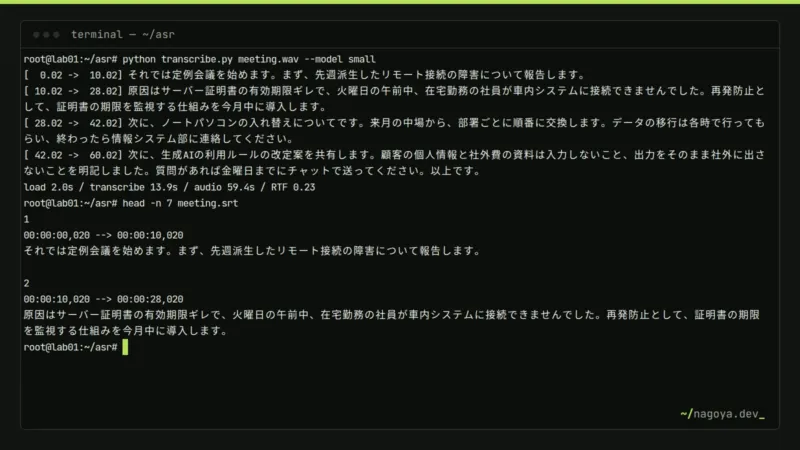
faster-whisperとwhisper.cppをCPUだけの環境に入れ、正解付きの日本語音声で処理時間・メモリ・文字誤り率を実測。句読点が消える設定やm4aが読めない問題な…
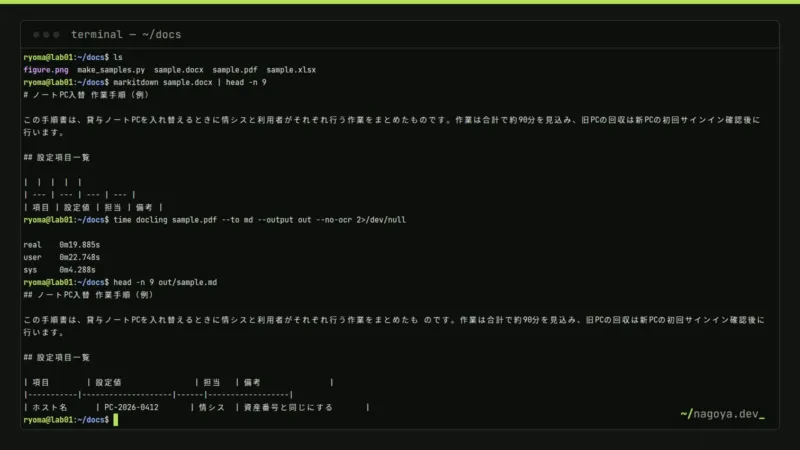
AIエージェントの正体であるツール呼び出しのループを、PythonとOllamaの小型モデルで約80行で実装。自動生成されるツール定義、小型モデルで実際に起きた失敗、引数の検証と…