faster-whisperとは、OpenAIの音声認識モデルWhisperを、CTranslate2という推論エンジンで動かすPythonライブラリです。重みをint8に変換して計算するため、GPUのないPCやサーバーでも会議録音を手元で文字起こしできます。同じWhisperをC/C++で実装したのがwhisper.cppで、こちらはPythonなしの単体バイナリとして動きます。
どちらも音声を外部に送らずに処理できるので、社外秘の会議や個人情報を含む通話の文字起こしに向きます。ここでは両方をCPUだけの環境に入れ、正解の分かっている日本語音声で速度と誤り率を実際に測りました。使ったのはfaster-whisper 1.2.1(CTranslate2 4.8.2)とwhisper.cpp v1.9.4、4 vCPUの仮想マシン(AMD EPYC 7713)です。
この記事でわかること
- faster-whisperとwhisper.cppの仕組みの違いと、どちらを選ぶかの判断基準
- 正解テキスト付きの日本語音声を自分で作り、文字誤り率(CER)で精度を測る方法
- faster-whisperの最小スクリプトと、句読点や無音区間に効く設定の実測での違い
- whisper.cppのビルド、量子化モデル(q8_0)の使い方、m4aが読めないときの変換
- tiny・base・smallの3サイズ×2エンジンの処理時間・メモリ・誤り率の実測値
faster-whisperとwhisper.cppの違い
Whisperは、音声を30秒ごとの窓に区切ってメルスペクトログラム(周波数ごとの強さを時間方向に並べた画像のようなもの)に変換し、エンコーダーで特徴を取り出したうえで、デコーダーがテキストのトークンを1つずつ生成するモデルです。2つの実装は、この計算をどの部品で行うかが違います。
| 観点 | faster-whisper | whisper.cpp |
|---|---|---|
| 推論エンジン | CTranslate2(Transformer専用のC++エンジン) | ggml(llama.cppと同じ系統のテンソルライブラリ) |
| 使い方 | Pythonのライブラリとして import する | whisper-cli などのコマンドを実行する |
| CPUでの量子化 | 読み込み時に compute_type="int8" で変換 | q5_1・q8_0など量子化済みのモデルファイルを選ぶ |
| モデルの取得 | 初回実行時にHugging Faceから自動ダウンロード | 同梱スクリプトで .bin ファイルを取得 |
| 音声の読み込み | PyAVに同梱のFFmpegでm4aやmp4も直接読める | wav・mp3・flac・oggのみ。ほかは事前に変換 |
| 向いている場面 | Pythonの業務スクリプトやWebアプリに組み込む | Pythonを入れたくない端末、他の言語から組み込む |
判断の目安は、処理をPythonで書くならfaster-whisper、Pythonの環境を持ち込みたくない場所や、C/C++・Go・Rustなどのアプリに組み込むならwhisper.cppです。精度はエンジンよりモデルのサイズで大きく変わることが、後の実測で分かります。
検証用の音声を用意する:正解テキスト付きの日本語
「どのモデルが使えるか」を判断するには、正解が分かっている音声で誤りを数える必要があります。今回は、情シスの定例会議を想定した293文字の原稿を自分で書き、日本語音声合成エンジンのOpen JTalkで読み上げて59.4秒のWAVファイルにしました。原稿の数字や英略語は、表記ゆれで誤り率が変わらないよう最小限にしています。
# Debian 13 の場合(音声データは non-free セクションにある)
sudo sed -i 's/^Components: main$/Components: main contrib non-free/' /etc/apt/sources.list.d/debian.sources
sudo apt-get update
sudo apt-get install -y open-jtalk open-jtalk-mecab-naist-jdic hts-voice-nitech-jp-atr503-m001 ffmpeg

open_jtalk -x /var/lib/mecab/dic/open-jtalk/naist-jdic \
  -m /usr/share/hts-voice/nitech-jp-atr503-m001/nitech_jp_atr503_m001.htsvoice \
  -ow meeting.wav meeting.txt
ffprobe -hide_banner meeting.wav 2>&1 | tail -2
#   Duration: 00:00:59.38, bitrate: 768 kb/s
#   Stream #0:0: Audio: pcm_s16le ..., 48000 Hz, 1 channels, s16, 768 kb/s
誤りの数え方には、文字誤り率(CER)を使います。正解と認識結果から空白と句読点を除き、何文字の挿入・削除・置換で一致させられるか(編集距離)を正解の文字数で割った値です。日本語は単語の区切りがないため、英語で使う単語誤り率より文字単位のほうが扱いやすくなります。
import re
import sys
import unicodedata


def norm(s: str) -> str:
    s = unicodedata.normalize("NFKC", s)
    return re.sub(r"[\s、。,.,.!?!?「」]", "", s)


def edit_distance(a: str, b: str) -> int:
    prev = list(range(len(b) + 1))
    for i, ca in enumerate(a, 1):
        cur = [i]
        for j, cb in enumerate(b, 1):
            cur.append(min(prev[j] + 1, cur[j - 1] + 1, prev[j - 1] + (ca != cb)))
        prev = cur
    return prev[-1]


ref = norm(open(sys.argv[1], encoding="utf-8").read())
hyp = norm(open(sys.argv[2], encoding="utf-8").read())
print(f"CER {edit_distance(ref, hyp) / len(ref):.3f}  (正解 {len(ref)} 字)")
合成音声は話者が1人で雑音も言いよどみもないため、実際の会議録音より誤り率がかなり低く出ます。ここでの数値はエンジンとモデルの相対比較に使い、導入判断は自社の会議録音を数本、人が正しく書き起こした原稿と突き合わせて行ってください。
faster-whisperのインストールと最小構成
faster-whisperはPyPIで配布されているので、仮想環境を作って pip install するだけです。依存するCTranslate2とPyAVにはビルド済みのライブラリが含まれており、システムにFFmpegを入れる必要はありません。
python3 -m venv .venv
. .venv/bin/activate
pip install faster-whisper==1.2.1
pip show faster-whisper ctranslate2 | grep -E '^(Name|Version)'
# Name: faster-whisper / Version: 1.2.1
# Name: ctranslate2 / Version: 4.8.2
次のスクリプトは、音声ファイルを文字起こしして画面に区間ごとの時刻と本文を出し、同じ名前のSRT字幕ファイルも書き出します。最後に、読み込み時間、推論時間、音声の長さに対する処理時間の比(RTF)を表示します。RTFが0.25なら、1時間の録音を15分で処理できる速さです。
import argparse
import time
from pathlib import Path

from faster_whisper import WhisperModel


def srt_time(t: float) -> str:
    ms = int(round(t * 1000))
    h, ms = divmod(ms, 3_600_000)
    m, ms = divmod(ms, 60_000)
    s, ms = divmod(ms, 1000)
    return f"{h:02}:{m:02}:{s:02},{ms:03}"


parser = argparse.ArgumentParser()
parser.add_argument("audio")
parser.add_argument("--model", default="small")
parser.add_argument("--threads", type=int, default=4)
args = parser.parse_args()

t0 = time.perf_counter()
model = WhisperModel(args.model, device="cpu", compute_type="int8",
                     cpu_threads=args.threads)
t1 = time.perf_counter()
segments, info = model.transcribe(
    args.audio,
    language="ja",
    beam_size=5,
    vad_filter=True,  # 無音区間を飛ばす
)
srt = []
for i, seg in enumerate(segments, 1):  # ここで初めて推論が進む
    print(f"[{seg.start:6.2f} -> {seg.end:6.2f}] {seg.text.strip()}")
    srt.append(f"{i}\n{srt_time(seg.start)} --> {srt_time(seg.end)}\n{seg.text.strip()}\n")
t2 = time.perf_counter()

Path(args.audio).with_suffix(".srt").write_text("\n".join(srt), encoding="utf-8")
print(f"load {t1 - t0:.1f}s / transcribe {t2 - t1:.1f}s / "
      f"audio {info.duration:.1f}s / RTF {(t2 - t1) / info.duration:.2f}")
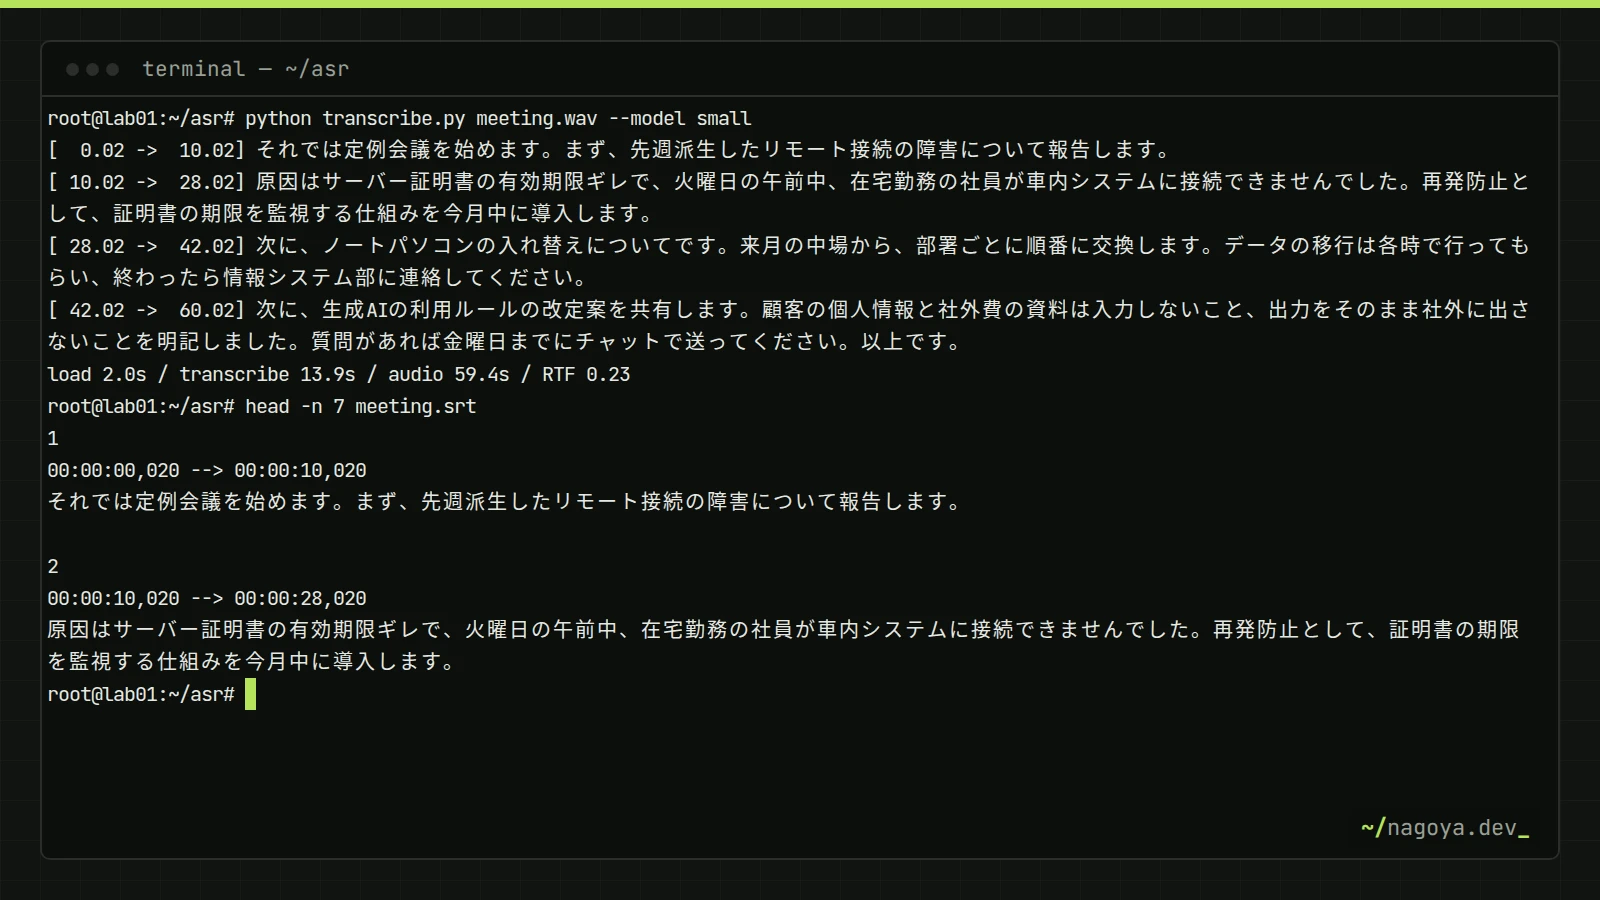
model.transcribe() はすぐに戻りますが、この時点ではまだ何も認識していません。返ってくる segments はジェネレーターで、for で1区間ずつ取り出すたびに推論が進みます。処理時間を測るときや、Webアプリで結果を返すときは、ループを回し終えたところを完了とみなしてください。実行結果は次のとおりです。
[  0.02 ->  10.02] それでは定例会議を始めます。まず、先週派生したリモート接続の障害について報告します。
[ 10.02 ->  28.02] 原因はサーバー証明書の有効期限ギレで、火曜日の午前中、在宅勤務の社員が車内システムに接続できませんでした。再発防止として、証明書の期限を監視する仕組みを今月中に導入します。
[ 28.02 ->  42.02] 次に、ノートパソコンの入れ替えについてです。来月の中場から、部署ごとに順番に交換します。データの移行は各時で行ってもらい、終わったら情報システム部に連絡してください。
[ 42.02 ->  60.02] 次に、生成AIの利用ルールの改定案を共有します。顧客の個人情報と社外費の資料は入力しないこと、出力をそのまま社外に出さないことを明記しました。質問があれば金曜日までにチャットで送ってください。以上です。
load 4.7s / transcribe 29.8s / audio 59.4s / RTF 0.50誤りの多くは「社内→車内」「社外秘→社外費」「発生→派生」のような同音異義語で、音は正しく聞き取れていて漢字の選び方を間違えています。初回はモデルのダウンロードがあるため、load が数十秒になります。モデルは ~/.cache/huggingface/hub に保存され、2回目以降はそこから読み込まれます。
日本語の精度と読みやすさを左右する設定
transcribe() の引数のうち、日本語の会議録音で結果が変わるのは次の5つです。smallモデルで設定を変えながら同じ音声を処理した結果も添えます。
| 設定 | 既定値 | 効果 | 今回の実測 |
|---|---|---|---|
language="ja" | 自動判定 | 冒頭30秒で言語を推定する処理を省き、英語と誤判定されるのを防ぐ | 常に指定 |
beam_size | 5 | 候補を複数保持して探索する幅。1にすると速いが誤りが増えやすい | 5のまま |
vad_filter | False | Silero VADで発話のない区間を除いてから認識する | 無効 CER 2.4% / 有効 CER 3.4% |
condition_on_previous_text | True | 直前の認識結果を次の窓の手がかりにする | Falseにすると句点「。」が11個から4個に減った |
initial_prompt | なし | 用語や文体の手がかりを先頭に与える | 会議の説明文を与えるとCER 3.4%→2.7% |
数値は59秒の音声1本での比較なので、1ポイント程度の差は誤差の範囲です。それでも読み取れることが2つあります。1つは condition_on_previous_text=False の副作用で、直前の文脈を渡さないと、後半の区間で句点が消えて文がつながった出力になりました。この設定は同じ文が何度も繰り返される暴走を止める目的で紹介されることが多いのですが、暴走が起きていないなら既定のTrueのままにして、句読点の付いた読みやすい出力を優先します。
もう1つは vad_filter です。今回の短い音声では誤り率がわずかに上がりましたが、会議の休憩や録音の前後にある長い無音を飛ばせるため、処理時間が短くなり、無音部分に存在しない文が出力される現象の予防にもなります。音声の末尾に30秒の無音やノイズを足して試したところ、今回は有効・無効のどちらでも架空の文は出ませんでした。長時間の録音では有効にしておき、短い音声で精度を詰めたいときだけ無効を試す、という使い分けが無難です。
CPUで compute_type="float16" を指定すると ValueError: Requested float16 compute type, but the target device or backend do not support efficient float16 computation. で止まります。float16はGPU向けの設定です。CPUでは int8 を使い、精度の差が気になる場合は float32 と比べてから決めてください。
whisper.cppのビルドと実行
執筆時点の最新リリース(v1.9.4)には配布バイナリが添付されていなかったため、ソースからビルドします。対象を whisper-cli に絞れば、今回の環境で約2分半で終わりました。モデル取得スクリプトはcurlかwgetを使うので、先に入れておきます。
sudo apt-get install -y build-essential cmake git curl
git clone --depth 1 --branch v1.9.4 https://github.com/ggml-org/whisper.cpp
cd whisper.cpp
cmake -B build -DCMAKE_BUILD_TYPE=Release
cmake --build build -j4 --config Release --target whisper-cli

# モデルの取得(small は約488MB、small-q8_0 は約264MB)
sh ./models/download-ggml-model.sh small-q8_0
./build/bin/whisper-cli -m models/ggml-small-q8_0.bin -f ../meeting.wav \
  -l ja -t 4 -otxt -osrt -of ../meeting_wcpp
-l ja は省略できません。既定値が en のため、日本語の音声をそのまま渡すと「Next, let's move on to the first step.」のような英文が同じ内容で繰り返し出力されました。-t はスレッド数で、物理コア数に合わせます。-otxt や -osrt で出力形式を選び、-of で拡張子を除いた出力先を指定します。
モデルファイルには、元の精度(F16)のほかにq5_1・q8_0の量子化版があります。q8_0は重みを8ビットで持つ形式で、ファイルサイズがF16の約半分になります。今回の計測ではsmallの処理時間がF16より大幅に短く、誤り率も悪化しなかったため、CPUで使うならq8_0を基本にします。
v1.9.4 の whisper-cli が読める音声形式は wav・mp3・flac・ogg です。スマートフォンやTeamsの録音に多いm4a(AAC)を渡すと error: failed to read audio file 'meeting.m4a' で終了します。ffmpeg -i meeting.m4a -ar 16000 -ac 1 -c:a pcm_s16le meeting.wav で16kHz・モノラルのWAVに変換してから渡してください。
CPUでの速度・精度の比較(実測)
同じ59.4秒の音声を、2つのエンジンとtiny・base・smallの3サイズで処理しました。条件はいずれも言語 ja、ビーム幅5、4スレッドです。計測したVMは他の処理と同居しており、同じ条件でも実行ごとに時間が大きく変わったため、処理時間は複数回の計測値の範囲で示します。処理時間はモデルの読み込みを含み、メモリは /usr/bin/time で測ったプロセスの最大使用量です。
| エンジン(重み) | モデル | 処理時間 | 最大メモリ | CER |
|---|---|---|---|---|
| faster-whisper(int8) | tiny | 5.8〜8.0秒 | 約314MB | 21.5% |
| faster-whisper(int8) | base | 7.3〜17.1秒 | 約380〜390MB | 11.9% |
| faster-whisper(int8) | small | 21.4〜30.4秒 | 約680〜740MB | 3.4% |
| whisper.cpp(F16) | tiny | 5.8〜16.6秒 | 約243MB | 20.5% |
| whisper.cpp(F16) | base | 24.8〜27.7秒 | 約387MB | 10.2% |
| whisper.cpp(F16) | small | 102.6〜191.7秒 | 約825MB | 3.4% |
| whisper.cpp(q8_0) | tiny | 11.5〜18.1秒 | 約242MB | 23.5% |
| whisper.cpp(q8_0) | base | 22.8〜37.5秒 | 約308MB | 9.6% |
| whisper.cpp(q8_0) | small | 38.8〜71.4秒 | 約644MB | 1.0% |
精度を決めているのはエンジンよりモデルのサイズです。tinyは5文字に1文字程度、baseは10文字に1文字程度を間違え、smallで3%前後まで下がりました。tinyは議事録の下書きにも手直しが多すぎるため、日本語ではsmall以上を前提にします。smallの最大メモリは1GB未満なので、メモリ8GBのノートPCでも他の作業と並行して動かせます。
速度は、baseとsmallでfaster-whisperがすべての計測で速く、smallでは最も遅い回(30.4秒)でもwhisper.cpp q8_0の最も速い回(38.8秒)を下回りました。F16のままのsmallは音声の長さを超える時間がかかったので、whisper.cppで使うならq8_0が前提です。以上から、CPUのサーバーで業務スクリプトに組み込むなら faster-whisper + small(int8)を標準にします。Pythonを入れられない端末で動かしたい場合や、他の言語のアプリに組み込む場合は、whisper.cppを選びます。
今回はコンテナのメモリ上限の都合で、medium・large-v3・large-v3-turbo(faster-whisperでは turbo の名前で指定可能)は計測していません。複数人が話す実際の会議ではsmallとの差が広がる可能性があるので、上の表と同じ手順で自社の録音を数本処理し、処理時間と誤り率の両方で決めてください。
社内で運用するときの構成
文字起こしを社内サービスにするときは、次の点を最初に決めておきます。
- オフライン運用:モデルを一度ダウンロードした後は、環境変数
HF_HUB_OFFLINE=1を設定してHugging Faceへの問い合わせを止める。保存先はHF_HOMEで変更でき、インターネットに出られないサーバーには、別の端末で取得したキャッシュのディレクトリごとコピーする - 前処理:録音はffmpegでモノラルにそろえ、数時間ある録音は1時間程度に分割して処理する。分割しておくと、途中で失敗しても再処理が短くて済む
- 話者の区別:Whisper自体は「誰が話したか」を出力しない。whisper-cliの
-diはステレオ録音の左右チャンネルで話者を分ける機能なので、モノラルの会議録音には効かない。話者分離が必須なら、別のモデルとの組み合わせを検討する - 保存期間:音声と文字起こし結果は会議の中身そのもの。処理後の音声を何日で消すか、文字起こし結果を誰が読めるかを、議事録の扱いと同じルールで決める
文字起こし結果の要約や決定事項の抽出をLLMで行う場合も、ローカルで完結させれば音声から議事録まで社外に出さずに済みます。要約用のツールはOllamaのPythonライブラリとModelfileで社内向けLLMツールを作るの手順で作れます。
動作確認
次の順に確認し、期待した出力が出れば環境は完成です。
# 1. faster-whisper の版
pip show faster-whisper ctranslate2 | grep -E '^(Name|Version)'
# 期待: faster-whisper 1.2.1 / ctranslate2 4.8.2

# 2. 文字起こしとSRTの書き出し
python transcribe.py meeting.wav --model small
ls meeting.srt
# 期待: [  0.02 ->  10.02] で始まる区間が並び、最後に load / transcribe / RTF の行

# 3. whisper.cpp の日本語出力
./whisper.cpp/build/bin/whisper-cli -m whisper.cpp/models/ggml-small-q8_0.bin \
  -f meeting.wav -l ja -t 4 -np -otxt -of meeting_wcpp
# 期待: meeting_wcpp.txt に日本語の本文が保存される

# 4. 正解との誤り率
python cer.py meeting.txt meeting_wcpp.txt
# 期待: CER 0.0xx (正解 293 字) の形式で表示される
つまずきポイント
Requested float16 compute type, but the target device or backend do not support efficient float16 computation.
GPU向けの記事のコードをそのままCPUで動かすと出ます。WhisperModel(..., device="cpu", compute_type="int8") に変えれば解決します。device="auto" のままGPUのないマシンで動かす場合も、compute_type は明示しておくと環境の違いで挙動が変わりません。
出力が英文になり、同じ文が繰り返される(whisper-cli)
-l を指定し忘れると、既定の en として日本語音声を英語で書き起こそうとし、今回の検証では「Next, let's move on to the first step.」が区間ごとに繰り返されました。-l ja を付けて実行し直します。言語が混在する音声なら -l auto で自動判定もできますが、日本語だけの会議なら固定したほうが安定します。
LocalEntryNotFoundError: Cannot find an appropriate cached snapshot folder ...
HF_HUB_OFFLINE=1 を設定した環境で、まだダウンロードしていないモデル名を指定すると出ます。メッセージの後半に outgoing traffic has been disabled とあれば、オフライン設定が原因です。一時的にオフライン設定を外して python -c "from faster_whisper import download_model; download_model('small')" で取得するか、取得済みのキャッシュをコピーします。
Either wget2, curl, or wget is required to download models.
whisper.cppの download-ggml-model.sh は、ダウンロードにcurlかwgetを使います。コンテナの軽量イメージには入っていないことが多いので、apt-get install -y curl の後に再実行します。取得に失敗した場合は、models/ に中途半端なファイルが残っていないかも確認してください。
よくある質問
Faster-Whisperとは何ですか?
OpenAIが公開したWhisperのモデルを、CTranslate2という推論エンジンで動かすPythonライブラリです。元の openai-whisper パッケージと同じモデルを使いながら、int8量子化とエンジンの最適化で、CPUでも少ないメモリで速く処理できます。GPUがある環境ではfloat16で動かせます。
Whisperは無料で使えますか?
モデルとコードはMITライセンスで公開されており、faster-whisperやwhisper.cppで手元のPCやサーバーで動かす限り利用料はかかりません。費用は計算資源と電気代だけです。一方、OpenAIのAPIで音声認識を使う場合は従量課金になるので、料金は執筆時点の公式情報で確認してください。
WindowsでFaster Whisperをインストールするには?
python.orgからPythonを入れ、PowerShellで py -m venv .venv、.venv\Scripts\Activate.ps1、pip install faster-whisper の順に実行します。CPUで使うなら追加のソフトは不要で、この記事の transcribe.py もそのまま動く書き方です。GPUを使う場合はCUDA関連のライブラリが別途必要です。
Faster-WhisperとPIPの関係は?
pipはPythonのパッケージ管理ツールです。faster-whisperはPyPI(Pythonのパッケージ配布サイト)で公開されているので pip install faster-whisper で導入し、依存するCTranslate2やPyAVも一緒に入ります。社内サーバーでは faster-whisper==1.2.1 のように版を固定すると、更新で結果が変わるのを防げます。
まとめ
CPUだけでも、faster-whisperのsmall(int8)なら1分の日本語音声を数十秒で、誤り率数%で文字起こしできました。精度はモデルサイズで決まり、tinyとbaseは日本語の議事録には誤りが多すぎます。Pythonなしで動くwhisper.cppを選ぶ場合は、CPUではq8_0のモデルを使い、-l ja を必ず付けてください。導入前に、自社の録音と正しい原稿でCERを測る手順を一度回しておくと、モデル選びで迷いません。
次に読む
- OllamaのPythonライブラリとModelfileで社内向けLLMツールを作る:文字起こし結果をローカルLLMで要約するツールの作り方
- GGUFと量子化の仕組み:whisper.cppと同じggml系のモデル形式と、q8_0などの量子化の中身
- 生成AIの社内利用ガイドラインの作り方:録音や文字起こし結果の扱いを決めるときのルール作り