GGUFとは、llama.cppとggmlが使うモデルファイルの形式で、重みに加えてトークナイザー、チャットテンプレート、層の数や文脈長などの設定値を1ファイルにまとめたものです。量子化とは、16ビットで保存されている重みを8ビットや4ビットなどの少ないビット数に詰め直し、ファイルと必要メモリを小さくする処理のことです。OllamaやLM Studioが読み込むのも、このGGUFファイルです。
ここでは、Hugging Faceで配布されている Qwen2.5-0.5B-Instruct をllama.cppでGGUFに変換し、Q8_0・Q4_K_M・Q2_Kの3種類に量子化して、サイズ、テンソルの中身、perplexity(後述)、実際の回答の違いを比べます。使ったのはllama.cppのビルドタグ b11149 で、CPUだけの環境(4 vCPU、コンテナのメモリ上限1.2GB)です。
この記事でわかること
- GGUFファイルに何が入っているかを
gguf-dumpで確かめる方法 - Q8_0・Q4_K・Q2_Kなどの量子化が、ブロック単位でどうビットを節約しているか
- llama.cppのビルド、Hugging FaceモデルのGGUF変換、
llama-quantizeの実行手順 - 小型モデルでは「Q2_K」を指定してもQ2_Kのテンソルが1つもできなかった理由
- 量子化の影響を測るときに、変換時に埋め込まれるサンプリング設定が結果を変えた実例
GGUFとは:1ファイルに何が入っているか
GGUFファイルは、先頭の識別子と版数、キーと値の組(メタデータ)の一覧、テンソルの名前・形・型・位置の一覧、そしてテンソル本体のデータという順に並んでいます。中身は、pipで入る gguf パッケージの gguf-dump で読めます。今回作ったQ4_K_Mのファイルを表示した先頭部分が次です(抜粋)。
* Dumping 41 key/value pair(s)
      1: UINT32     |        1 | GGUF.version = 3
      2: UINT64     |        1 | GGUF.tensor_count = 290
      4: STRING     |        1 | general.architecture = 'qwen2'
      9: FLOAT32    |        1 | general.sampling.penalty_repeat = 1.100000023841858
     22: UINT32     |        1 | qwen2.block_count = 24
     23: UINT32     |        1 | qwen2.context_length = 32768
     24: UINT32     |        1 | qwen2.embedding_length = 896
     30: STRING     |        1 | tokenizer.ggml.model = 'gpt2'
     32: [STRING]   |   151936 | tokenizer.ggml.tokens = ['!', '"', '#', '$', '%', '&', ...]
     39: STRING     |        1 | tokenizer.chat_template = "{%- if tools %}\n    {{- '<|im_start|>system\\n' }}\n    {%-..."
     41: UINT32     |        1 | general.file_type = 15
* Dumping 290 tensor(s)
      2:  136134656 |   896, 151936,     1,     1 | Q8_0    | token_embd.weight
      6:     802816 |   896,   896,     1,     1 | Q5_0    | blk.0.attn_output.weight
埋め込み行列の行数と同じ15万1,936個分のトークン表と、チャットテンプレートまで入っているので、GGUFファイル1つあれば推論を始められます。Hugging Faceで一般的なsafetensors形式は重みのテンソルだけを保存する形式で、設定は config.json、トークナイザーは tokenizer.json と別ファイルに分かれています。PyTorchやTransformers、vLLMで扱うならsafetensors、llama.cppやOllamaでCPUや少ないメモリで動かすならGGUF、という使い分けになります。
抜粋にある general.sampling.penalty_repeat のように、変換元の generation_config.json にあった生成時の推奨設定も書き込まれます。これが後で結果を左右するので覚えておいてください。
量子化の仕組み:ブロックごとの倍率と少ないビット
量子化の基本は、重みを小さなブロックに分け、ブロックごとに1つの倍率(スケール)を持たせて、各重みは倍率に対する整数として保存することです。いちばん単純なQ8_0は、32個の重みごとに16ビットの倍率 d を1つ持ち、各重みを-127〜127の整数 q で表して、d × q で元の値に戻します。ggmlのソースで構造体の大きさを確認すると、32個分で倍率2バイト+整数32バイトの34バイト、1重みあたり8.5ビットです。
例として、ブロック内の絶対値の最大が0.127なら、Q8_0の倍率は0.127÷127=0.001です。0.0834という重みは83として保存され、戻すと0.083で、誤差は0.0004です。4ビットで同じブロックを表すと、使える段階が16しかないため刻み幅は約0.016に広がり、同じ重みの誤差は最大で0.008程度まで大きくなります。ビット数を減らすほど、この丸め誤差がすべての重みに少しずつ乗ります。
名前にKが付くK-quantは、256個の重みを「スーパーブロック」とし、その中を16〜32個ずつの小ブロックに分けて小ブロックごとに倍率を持たせ、さらにその倍率自体も4〜8ビットに量子化して容量を節約する方式です。ggmlの構造体から計算した1重みあたりのビット数は次のとおりです。
| 型 | ブロックの単位 | 1ブロックのバイト数 | 1重みあたり | 構成 |
|---|---|---|---|---|
| Q8_0 | 32個 | 34 | 8.5ビット | 倍率(16ビット)+8ビット整数×32 |
| Q6_K | 256個 | 210 | 約6.56ビット | 下位4ビット+上位2ビット、8ビットの小ブロック倍率×16 |
| Q5_0 | 32個 | 22 | 5.5ビット | 倍率+4ビット×32+5ビット目の32ビット |
| Q4_K | 256個 | 144 | 4.5ビット | 倍率と最小値(各16ビット)+6ビットの小ブロック倍率+4ビット×256 |
| Q4_0 | 32個 | 18 | 4.5ビット | 倍率+4ビット×32 |
| Q3_K | 256個 | 110 | 約3.44ビット | 下位2ビット+上位1ビット+6ビットの小ブロック倍率 |
| Q2_K | 256個 | 84 | 約2.63ビット | 2ビット×256+4ビットの小ブロック倍率と最小値 |
Q4_K_Mの「_M」は混ぜ方の指定です。すべてのテンソルを同じ型にするのではなく、精度が効きやすい一部のテンソル(attn_v や ffn_down の一部の層など)に高い精度の型を割り当てます。_Sは小さく、_Lは大きく、_Mはその中間です。
llama.cppをビルドする(CPU)
ビルドにはCコンパイラ、CMake、Git、OpenSSLの開発ファイルを使います。OpenSSLがないとCMakeは OpenSSL not found, HTTPS support disabled と警告するだけで先に進みますが、-hf オプションでHugging Faceから直接モデルを取得する機能がHTTPSを使えなくなるため、最初から入れておきます。
sudo apt-get install -y build-essential cmake git curl libssl-dev python3-venv
mkdir -p ~/gguf && cd ~/gguf
git clone --depth 1 --branch b11149 https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build -DCMAKE_BUILD_TYPE=Release
cmake --build build -j2 --config Release \
  --target llama-quantize llama-cli llama-completion llama-perplexity llama-bench llama-imatrix
export PATH="$HOME/gguf/llama.cpp/build/bin:$PATH"
対象を必要なツールに絞っても、今回の環境で約10分かかりました。並列数は -j2 にしています。メモリ1.2GBの環境で -j4 にしたところ、HTTP通信用ライブラリのコンパイル中に c++: fatal error: Killed signal terminated program cc1plus で失敗しました。コンパイラがメモリ不足で強制終了されたもので、メモリが8GB以上あるマシンなら -j$(nproc) で問題ありません。
執筆時点のllama.cppでは、対話用の llama-cli がチャット形式の新しい画面になり、プロンプトの続きを書かせる従来型の動作は llama-completion に分かれています(-no-cnv はこちらで使います)。古い記事の llama-cli ... -no-cnv を実行すると error: invalid argument: -no-cnv で止まるのはこのためです。
Hugging FaceのモデルをGGUFに変換する
変換スクリプト convert_hf_to_gguf.py はPythonで動き、PyTorchを使います。同梱の要件ファイルがCPU版PyTorchの配布元を指定しているので、仮想環境を作ってそのまま入れれば、GPU向けの巨大なパッケージは入りません。今回は依存を含めて約1.1GBでした。
cd ~/gguf
python3 -m venv .venv && . .venv/bin/activate
pip install -r llama.cpp/requirements/requirements-convert_hf_to_gguf.txt

hf download Qwen/Qwen2.5-0.5B-Instruct --local-dir models/Qwen2.5-0.5B-Instruct
python llama.cpp/convert_hf_to_gguf.py models/Qwen2.5-0.5B-Instruct \
  --outtype f16 --outfile models/qwen2.5-0.5b-instruct-f16.gguf
変換は16秒で終わり、最大メモリ使用量は約1.15GBでした。ログには token_embd.weight, torch.bfloat16 --> F16, shape = {896, 151936} のように、テンソルごとの元の型と変換後の型が出ます。元の重みはbf16(指数部が広い16ビット形式)で、--outtype f16 はそれを一般的な半精度に変換します。値をそのまま残したい場合は --outtype bf16 も選べます。--outtype の選択肢は f32, f16, bf16, q8_0, tq1_0, tq2_0, auto で、Q4_K_Mのような型はここでは作れないため、次の llama-quantize で行います。
llama-quantizeで量子化する
cd ~/gguf
for t in Q8_0 Q4_K_M Q2_K; do
  llama-quantize models/qwen2.5-0.5b-instruct-f16.gguf \
    models/qwen2.5-0.5b-instruct-$t.gguf $t 2>&1 | grep -E 'size  ='
done
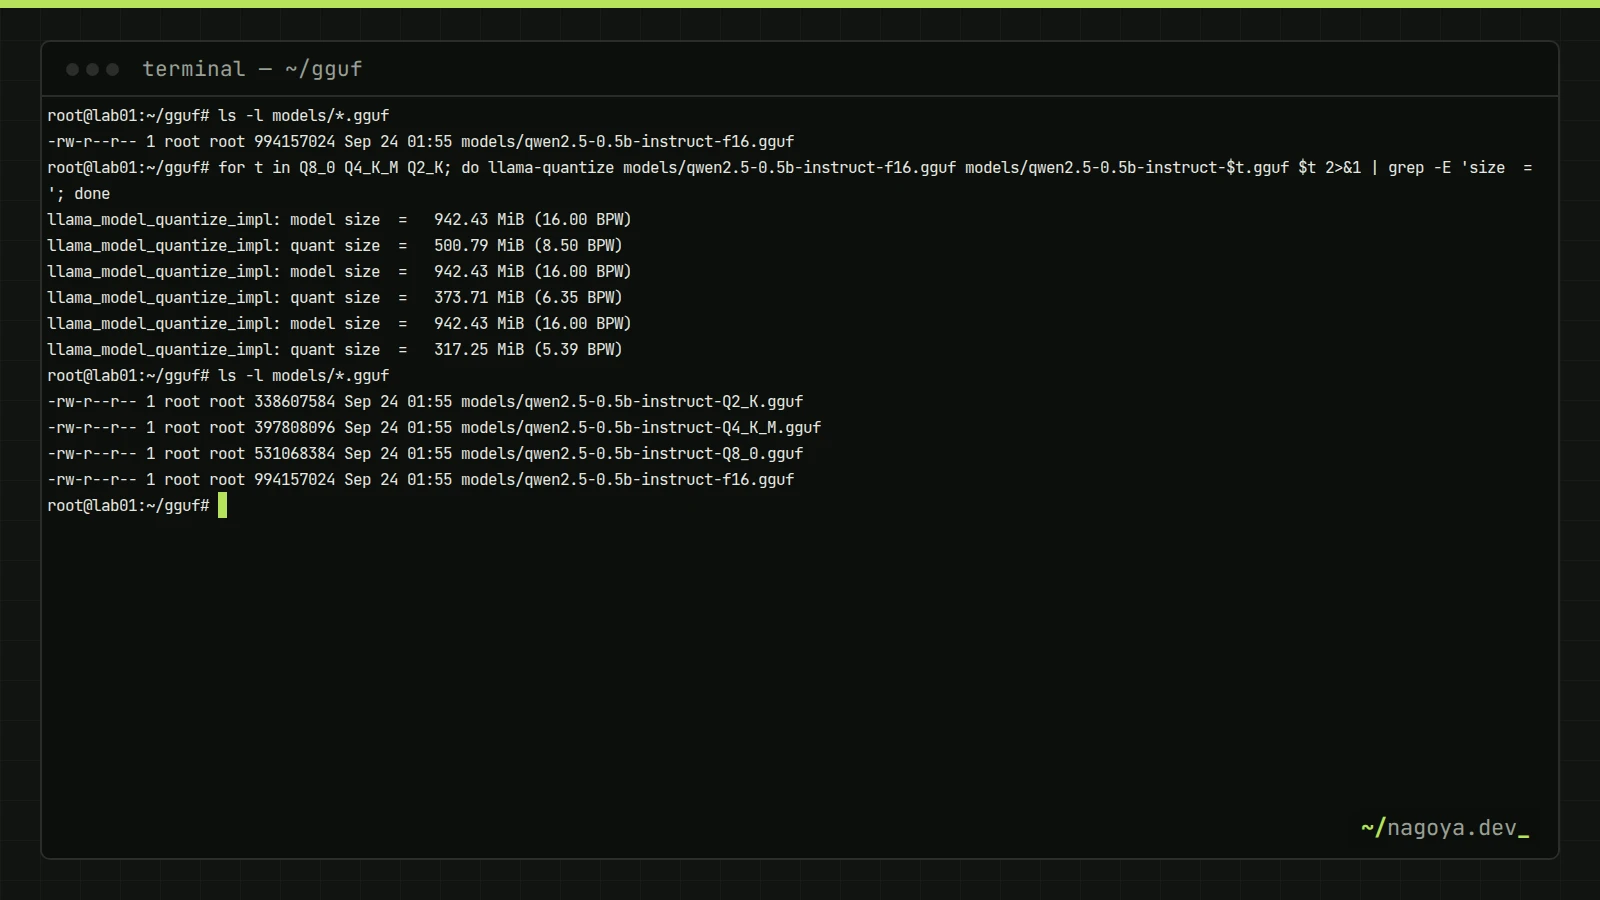
ls -l models/*.gguf各型とも4〜6秒で終わり、結果は次のとおりでした。llama-quantize の最後に出る「quant size」の行に、1重みあたりの平均ビット数(BPW)が表示されます。
| 型 | ファイルサイズ(バイト) | llama-quantizeの表示 | 実際のテンソルの型(重み169個分) |
|---|---|---|---|
| F16(変換直後) | 994,157,024 | 942.43 MiB(16.00 BPW) | すべてF16 |
| Q8_0 | 531,068,384 | 500.79 MiB(8.50 BPW) | Q8_0が169 |
| Q4_K_M | 397,808,096 | 373.71 MiB(6.35 BPW) | Q5_0が132、Q8_0が13、Q4_Kが12、Q6_Kが12 |
| Q2_K | 338,607,584 | 317.25 MiB(5.39 BPW) | Q4_0が120、Q3_Kが24、Q5_0が24、Q8_0が1 |
右端の列は gguf-dump で数えたもので、正規化層やバイアスなど121個のF32テンソルは除いています。注目すべきは、Q2_Kを指定したファイルにQ2_Kのテンソルが1つもないことです。量子化中には次の警告が大量に出ていました。
warning: blk.0.attn_k.weight - ncols 896 not divisible by 256 (required for type q4_K) -> falling back to q5_0K-quantは256個単位のスーパーブロックで行を区切るため、行の長さ(列数)が256の倍数でなければ使えません。Qwen2.5-0.5Bは隠れ次元が896で256の倍数ではないので、896列のテンソルはすべて別の型に置き換えられ、平均ビット数が名目よりずっと高くなりました。4864列の ffn_down だけは割り切れるため、Q4_K_Mでは本来の配合どおりQ4_KとQ6_Kが半分ずつ使われています。隠れ次元は gguf-dump の *.embedding_length で確認できます。
量子化の型名は「目標」であって、中身の保証ではありません。とくに1B未満の小型モデルは隠れ次元が256の倍数でないことがあり、型名から想像するほど小さくならない一方、選んだ型の特性とも違うものになります。配布されているGGUFを使う場合も、gguf-dump でテンソルの型を一度見ておくと、サイズの理由が分かります。
量子化の影響を測る:perplexityと実際の回答
品質の目安にはperplexity(PPL)を使います。テキストを1トークンずつ予測させたときの「迷いの大きさ」で、次のトークンに付けた確率の対数を平均して指数に戻した値です。低いほど元の文章を予測できていることを表します。第三者の文章を使わないよう、評価用のテキストにはnagoya.devの記事本文(21,185トークン)を使い、512トークンずつ16区間を評価しました。
llama-perplexity -m models/qwen2.5-0.5b-instruct-Q4_K_M.gguf \
  -f ja_corpus.txt -c 512 --chunks 16 -t 4
# 最後に: Final estimate: PPL = 29.2913 +/- 1.47460| 型 | PPL | F16との差 |
|---|---|---|
| F16 | 28.04(±1.40) | 基準 |
| Q8_0 | 28.12(±1.41) | +0.3% |
| Q4_K_M | 29.29(±1.47) | +4.5% |
| Q2_K | 37.30(±1.92) | +33% |
Q8_0はF16とほぼ区別できず、Q4_K_Mで数%悪化し、Q2_Kで大きく崩れました。数値は小さなモデルと16区間での比較なので、差の大きさは目安として読んでください。速度も llama-bench で測りましたが、他の処理と同居したVMでは同じ条件でも実行ごとに数倍ぶれたため、ここには載せていません。自分の環境で測るなら llama-bench -m <モデル> -p 128 -n 64 -t 4 -r 3 のように繰り返し回数を増やし、ばらつき(±の値)が小さいことを確認してから比較します。
実際の回答でも違いが出ました。llama-cli に -p "HTTPSの標準のポート番号は?数字だけで答えてください。" -st --temp 0 を渡すと、F16とQ8_0は「443です」と答えたのに対し、Q4_K_Mは「1433です」、Q2_Kは「465です」と誤答しました(例:1問だけの結果)。
ところが、同じQ4_K_Mに --repeat-penalty 1.0 を付けると「443です」に戻りました。効いていたのは、変換時に generation_config.json から書き込まれた general.sampling.penalty_repeat = 1.1 です。既定値は1.0(無効)ですが、GGUFにこの値があるとllama.cppはそれを既定として使うため、今回の比較はすべてペナルティ1.1の状態で行われていました。繰り返しペナルティは、質問文を含む直前の文脈に出たトークンの確率を下げる設定です。Q4_K_Mの回答は「HTTPS(安全トーキー)の…」と言い回しの段階から変わり、その先で数字も入れ替わっていました。F16とQ8_0は同じ設定でも正答を保ったので、量子化による確率のわずかなずれと、ペナルティの組み合わせで起きた誤答です。
量子化の比較では、サンプリング設定をコマンドで明示してそろえてください。GGUFには生成設定が埋め込まれていることがあり、同じ「Q4_K_M」でも、ファイルの作り方や実行するツールによって既定値が変わります。実際、Ollamaのライブラリにある qwen2.5:0.5b(同じくQ4_K_M)は型の配合こそ同じでしたが、290個中40個のテンソルがバイト単位で今回のファイルと一致せず、生成設定のキーも持っていませんでした。
量子化したモデルを動かす:llama-cli・llama-server・Ollama
# 1回だけ質問して終了する(チャットテンプレートはGGUFに入っているものを使う)
llama-cli -m models/qwen2.5-0.5b-instruct-Q4_K_M.gguf \
  -p "HTTPSの標準のポート番号は?数字だけで答えてください。" \
  -st --temp 0 --repeat-penalty 1.0 -n 32 2>/dev/null | sed -n '/^> /,$p' | head -2

# 続きを書かせる従来型の動作
llama-completion -m models/qwen2.5-0.5b-instruct-Q4_K_M.gguf -p "HTTPSの標準のポート番号は" -n 16 -no-cnv
llama-cli は起動時にロゴや利用できるコマンドの一覧を表示するため、上の例では sed で質問の行以降だけを取り出しています。OpenAI互換のHTTP APIが必要なら llama-server を使います(ビルド対象に llama-server を追加)。ソースで確認した既定の待ち受けは 127.0.0.1:8080 で、認証は --api-key を付けたときだけ有効になります。社内に公開する場合は、APIキーとリバースプロキシでのTLSをセットにしてください。
Ollamaに取り込む場合は、GGUFファイルを指す1行のModelfileで足ります。今回のファイルでは、Ollama 0.34.3がGGUF内のチャットテンプレートをそのまま使い、ollama show の Capabilities に tools も表示されました。
cd ~/gguf/models
printf 'FROM ./qwen2.5-0.5b-instruct-Q4_K_M.gguf\nPARAMETER temperature 0\n' > Modelfile
ollama create qwen-local -f Modelfile
ollama show qwen-local | sed -n '/Model/,/Capabilities/p'
取り込んだモデルに同じ質問をすると、Ollamaでも「1433です」と答えました。一方、Ollamaのライブラリ版 qwen2.5:0.5b は同じ質問に「443です」と答えています。同じQ4_K_M表記でも、ファイルと実行環境の組み合わせごとに回答を確かめる必要があります。Ollamaの使い方全般はOllamaで始めるローカルLLM入門を参照してください。
どの量子化を選ぶか
判断は「メモリに収まるか」から始め、収まる中で最も精度の高い型を選びます。必要メモリはファイルサイズに文脈(KVキャッシュ)の分を足して見積もり、モデルごとの目安はローカルLLMの選び方にまとめています。
- 3B未満の小型モデル:Q8_0を基本にする。ファイルが小さく、量子化による劣化が今回のようにほぼ見えない。Q4_K_Mにしても小型モデルでは隠れ次元の都合で思ったほど小さくならないことがある
- 7B〜14B級を限られたメモリで動かす:Q4_K_Mを出発点にし、余裕があればQ5_K_MやQ6_Kで精度を比べる
- 収まらない場合の最終手段:Q3_K系やQ2_K、imatrixを使ったIQ系。事前に自社の質問で回答を確認してから使う
低ビットで精度を保ちたいときは、imatrix(重要度行列)を使います。評価用とは別のテキストをモデルに読ませて「どの重みが出力に効くか」を測り、その情報を使って丸め誤差を重要な重みで小さくする方法です。今回の環境では、2区間分の計算が13秒で終わり、--imatrix を付けたIQ4_NLへの量子化が動くことを確認しました(精度の比較はしていません)。
llama-imatrix -m models/qwen2.5-0.5b-instruct-f16.gguf -f calibration.txt -o imatrix.gguf
llama-quantize --imatrix imatrix.gguf \
  models/qwen2.5-0.5b-instruct-f16.gguf models/qwen2.5-0.5b-instruct-IQ4_NL.gguf IQ4_NL
# load_imatrix: loaded 168 importance matrix entries ... の行が出れば読み込めている
動作確認
# 1. 変換したF16ファイルのテンソル数と構成
gguf-dump models/qwen2.5-0.5b-instruct-f16.gguf 2>/dev/null | head -4
# 期待: GGUF.version = 3 / GGUF.tensor_count = 290

# 2. 量子化後のサイズと平均ビット数
llama-quantize models/qwen2.5-0.5b-instruct-f16.gguf models/test-Q8_0.gguf Q8_0 2>&1 | grep 'quant size'
# 期待: quant size = 500.79 MiB (8.50 BPW)

# 3. 実際のテンソルの型の内訳
gguf-dump models/qwen2.5-0.5b-instruct-Q4_K_M.gguf 2>/dev/null \
  | sed -n '/tensor(s)/,$p' | awk -F'|' 'NR>1{gsub(/ /,"",$3); print $3}' | sort | uniq -c
# 期待: F32 121 / Q4_K 12 / Q5_0 132 / Q6_K 12 / Q8_0 13

# 4. 回答の確認(生成設定をそろえる)
llama-cli -m models/qwen2.5-0.5b-instruct-Q8_0.gguf -p "HTTPSの標準のポート番号は?数字だけで答えてください。" \
  -st --temp 0 --repeat-penalty 1.0 -n 32 2>/dev/null | sed -n '/^> /,$p' | head -2
つまずきポイント
c++: fatal error: Killed signal terminated program cc1plus
ビルド中にコンパイラがメモリ不足で強制終了されたときのメッセージです。今回はメモリ上限1.2GBの環境で -j4 にしたときに出ました。並列数を -j2 か -j1 に下げて再実行すれば、途中まで作ったオブジェクトを使って続きからビルドされます。
failed to quantize: requantizing from type q8_0 is disabled
すでに量子化済みのファイル(Q8_0など)を、さらに別の型へ量子化しようとすると止まります。量子化の誤差が重なるためで、元のF16かBF16のファイルから作り直すのが正攻法です。どうしても手元に量子化済みしかない場合に限り --allow-requantize で許可できますが、品質は元から作ったものより落ちます。
ncols 896 not divisible by 256 ... falling back to q5_0
エラーではなく警告で、ファイルは完成します。ただし前述のとおり、指定した型とは違う型でテンソルが保存され、サイズと品質の両方が想定から外れます。小型モデルで出た場合は、型名ではなく llama-quantize が表示するBPWと、gguf-dump の型の内訳で判断してください。
CMakeで「OpenSSL not found, HTTPS support disabled」と出る
警告なのでビルドは成功しますが、llama-cli -hf <リポジトリ名> のようにHugging Faceから直接取得する機能がHTTPS接続を使えなくなります。libssl-dev(Debian/Ubuntu)を入れて build ディレクトリを消し、CMakeの構成からやり直します。
よくある質問
GGUFファイルとは何ですか?
llama.cppやOllamaが読み込むLLMの配布形式で、重みに加えてトークナイザー、チャットテンプレート、層の数や文脈長などの設定を1ファイルに持っています。拡張子は .gguf で、中身は pip install gguf で入る gguf-dump コマンドで確認できます。
GGUFの利点は何ですか?
1ファイルで推論に必要なものがそろうこと、Q8_0からQ2_Kまでの量子化済みの重みを直接持てること、メモリへの割り当て(mmap)で読み込みが速いことです。そのためGPUのないPCや、メモリの少ないサーバーでも動かしやすくなります。学習や追加学習には向かないので、その用途ではsafetensorsを使います。
量子化ビット数が多いほど何がいいの?
丸め誤差が小さくなり、元のモデルに近い出力になります。今回の測定では、8ビットのQ8_0はperplexityの悪化が0.3%でしたが、Q2_Kでは33%悪化しました。代わりにファイルと必要メモリは大きくなるので、メモリに収まる範囲で最も多いビット数を選ぶのが基本です。
LLMの量子化のやり方は?
手順は2段階です。Hugging Faceのモデルをllama.cppの convert_hf_to_gguf.py でF16かBF16のGGUFに変換し、llama-quantize 入力.gguf 出力.gguf Q4_K_M のように型を指定して量子化します。量子化済みのファイルから再度量子化するのは避け、変換直後のファイルから型ごとに作ります。
まとめ
GGUFは重み・トークナイザー・テンプレート・生成設定まで入った1ファイルの形式で、量子化はブロックごとの倍率で重みを少ないビットに詰める処理です。実際に作ってみると、型名どおりのテンソルにならないことや、埋め込まれた繰り返しペナルティが回答を変えることが分かりました。量子化を選ぶときは、BPWと gguf-dump の内訳を確認し、生成設定をそろえた自分の質問で回答を比べてから決めてください。
次に読む
- ローカルLLMの選び方:量子化とパラメータ数から必要なメモリを見積もる早見表
- Ollamaで始めるローカルLLM入門:作ったGGUFを取り込んで社内で使う構成
- faster-whisperとwhisper.cppでローカル文字起こし:同じggml系のwhisper.cppでq8_0モデルを使う例