Ollama Pythonライブラリとは、手元やサーバーで動くOllamaのAPIをPythonから呼び出すための公式クライアントです。導入は pip install ollama だけで済みます。Modelfileとは、ベースモデルにシステムプロンプト、生成パラメータ、会話の例を重ねて、新しい名前のモデルとして登録するための定義ファイルです。この2つを組み合わせると、「振る舞いはModelfileで固定し、処理の流れはPythonで書く」という分担で、社内向けの小さなLLMツールを作れます。
ここでは、問い合わせメールを分類・緊急度・要約に仕分けてCSVに書き出すツールを題材に、Modelfileの書き方、ollama create での登録、Pythonライブラリの基本と構造化出力、エラー処理までを実際の出力つきで進めます。確認に使ったのはOllama 0.34.3、Pythonライブラリ ollama 0.6.2、モデルはCPUで動く qwen2.5:0.5b です。
この記事でわかること
- Modelfileの各命令(FROM・PARAMETER・SYSTEM・MESSAGEなど)の役割と使いどころ
ollama createとollama showで、作ったモデルの設定を確かめる方法- Pythonライブラリの
chat・generate・ストリーミング・応答に含まれる数値の使い方 - JSONスキーマとpydanticで、出力を型付きのデータとして受け取る方法
- 実際に出たエラー4種類(モデルなし、接続失敗、引数の変更、埋め込み非対応)と対処
全体像:Modelfileで振る舞いを固定し、Pythonで処理を書く
LLMを使うスクリプトを何本か書くと、同じシステムプロンプトや温度の設定があちこちに散らばります。担当者ごとに微妙に違う指示で動いていると、「同じ問い合わせなのに分類が違う」という問い合わせに答えられません。それらを1つのモデル名(例:helpdesk-triage)にまとめてModelfileに書いておけば、Pythonのコードはモデル名を指定するだけになり、指示の変更はModelfileの更新と ollama create の再実行で全員に反映されます。
| 置き場所 | 書くもの | 変更したときの影響範囲 |
|---|---|---|
| Modelfile | 役割と判断基準(SYSTEM)、温度や文脈長(PARAMETER)、会話の例(MESSAGE) | そのモデル名を使う全スクリプト・全利用者 |
| Pythonのコード | 入力の読み込み、出力の検証、ファイルへの書き出し、エラー時の扱い | そのスクリプトだけ |
Modelfileを書く
FROM qwen2.5:0.5b

PARAMETER temperature 0
PARAMETER num_ctx 4096
PARAMETER num_predict 256

SYSTEM """あなたは情報システム部の受付担当です。
問い合わせを読み、次の3項目をJSONで返します。
- category: アカウント / ネットワーク / PC・周辺機器 / ソフトウェア / その他 のどれか
- urgency: 高 / 中 / 低 のどれか。業務が止まっている、または今日が期限なら「高」
- summary: 問い合わせの要点を40字以内で"""

MESSAGE user 会議室Aのモニターに何も映りません。15時からの打ち合わせで使います。
MESSAGE assistant {"category": "PC・周辺機器", "urgency": "高", "summary": "会議室Aのモニターが映らない(15時に使用)"}
MESSAGE user 来月から経理システムの閲覧権限をもらえますか。
MESSAGE assistant {"category": "アカウント", "urgency": "低", "summary": "経理システムの閲覧権限の追加依頼(来月から)"}| 命令 | 役割 | この例での使い方 |
|---|---|---|
FROM | 元にするモデル(名前、GGUFファイル、safetensorsのディレクトリ) | qwen2.5:0.5b |
PARAMETER | 生成の設定。温度、文脈長(num_ctx)、最大出力トークン数(num_predict)など | 仕分けは再現性優先で温度0、出力は256トークンで打ち切る |
SYSTEM | 毎回先頭に付くシステムプロンプト | 役割、3項目の定義、緊急度の判断基準 |
MESSAGE | あらかじめ入れておく会話の例(few-shot) | 入力と望ましいJSONの組を2つ |
TEMPLATE | プロンプトの組み立て方。通常は元のモデルのものを引き継ぐ | 指定しない |
ADAPTER | LoRAなどの追加学習の差分を重ねる | 使わない |
LICENSE | ライセンス文の記載 | 元のモデルのものを引き継ぐ |
MESSAGE の例は、評価に使う問い合わせとは別の文面にします。同じ文面を入れると、その問い合わせだけ正解を丸暗記した状態になり、精度を正しく測れません。num_ctx は一度に扱えるトークン数で、これを超えた入力は先頭側が切り捨てられます。長いメールを扱うなら、num_ctx を増やすとメモリ使用量も増えることを踏まえて決めます。
ollama createで登録し、showで確かめる
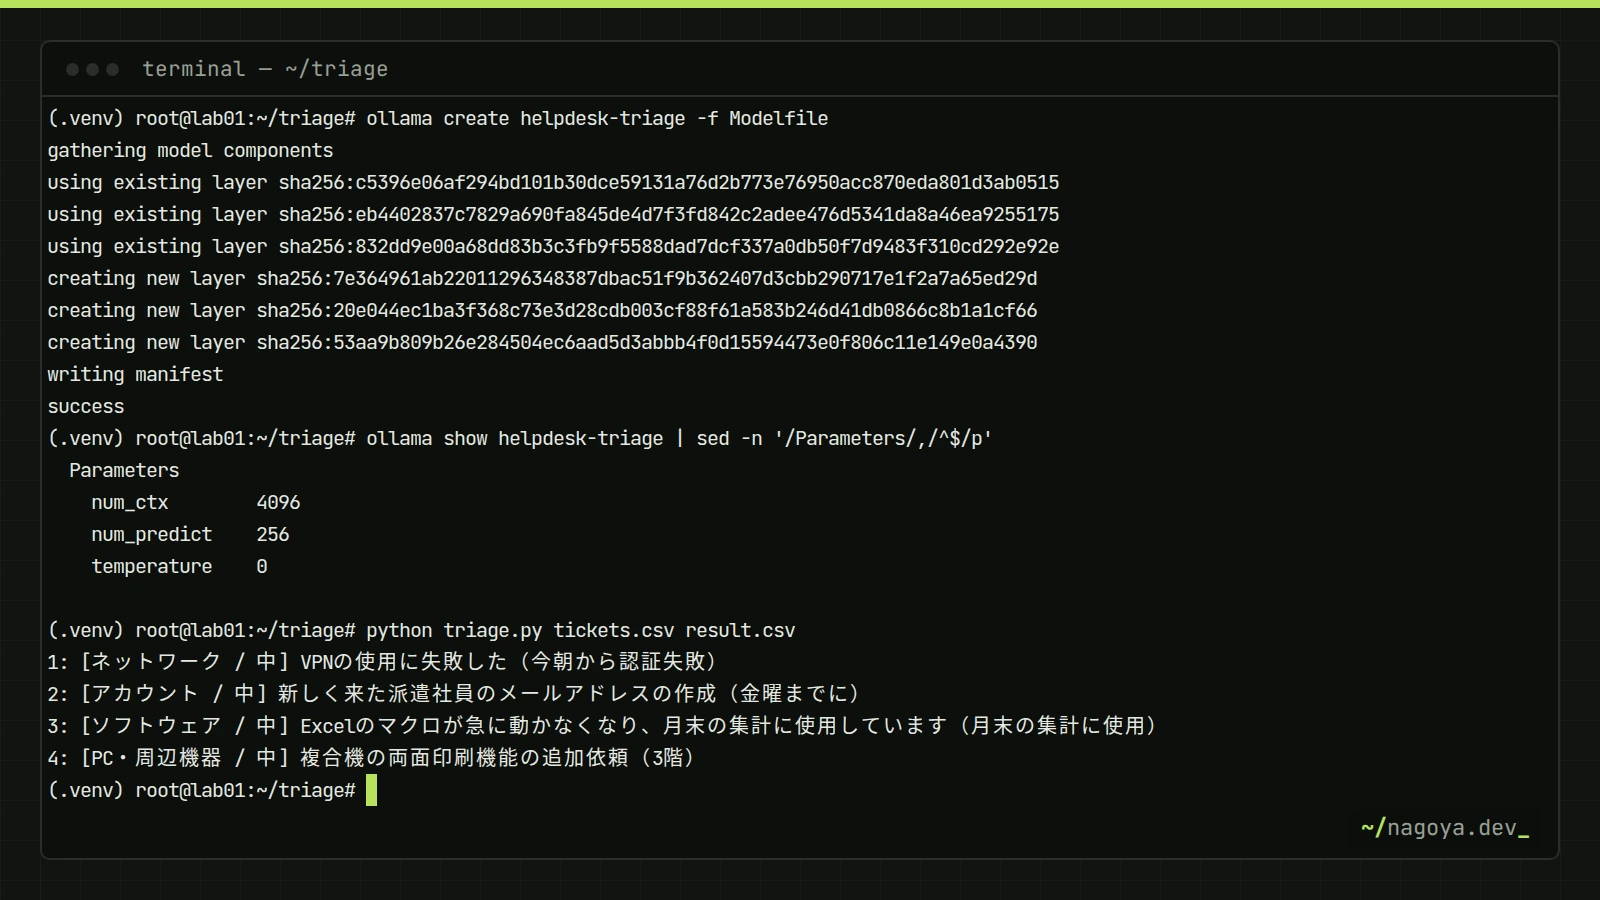
ollama create helpdesk-triage -f Modelfile
ollama show helpdesk-triage | sed -n '/Parameters/,/^$/p'
ollama show helpdesk-triage --modelfile | head -20gathering model components
using existing layer sha256:c5396e06af294bd101b30dce59131a76d2b773e76950acc870eda801d3ab0515
using existing layer sha256:eb4402837c7829a690fa845de4d7f3fd842c2adee476d5341da8a46ea9255175
using existing layer sha256:832dd9e00a68dd83b3c3fb9f5588dad7dcf337a0db50f7d9483f310cd292e92e
creating new layer sha256:7e364961ab22011296348387dbac51f9b362407d3cbb290717e1f2a7a65ed29d
creating new layer sha256:20e044ec1ba3f368c73e3d28cdb003cf88f61a583b246d41db0866c8b1a1cf66
creating new layer sha256:53aa9b809b26e284504ec6aad5d3abbb4f0d15594473e0f806c11e149e0a4390
writing manifest
success
Parameters
num_predict 256
temperature 0
num_ctx 4096using existing layer の行が示すとおり、モデルの重み(約400MBのファイル)はコピーされず、元のモデルと共有されます。新しく作られるのはシステムプロンプトやパラメータ、会話の例といった小さな層だけです。そのため、部署や用途ごとにモデルを何個作ってもディスクはほとんど増えません。ollama list のSIZE列には重みを含めた大きさが表示されるので、合計が実際の使用量と一致しない点に注意してください。
版の管理には、モデル名のタグを使います。ollama create helpdesk-triage:v2 -f Modelfile のように作れば、v1 と並べて置いて比べられ、問題があればスクリプトのモデル名を戻すだけで元に戻せます。定義ファイルそのものはGitで管理し、変更のたびに評価用の問い合わせで結果を確かめる運用にします。
Pythonライブラリの基本
python3 -m venv .venv && . .venv/bin/activate
pip install ollama==0.6.2from ollama import Client, ResponseError
client = Client(host="http://127.0.0.1:11434", timeout=120) # 省略時は環境変数 OLLAMA_HOST
# chat: 役割付きのメッセージ列を渡す(システムプロンプトや会話履歴を含められる)
r = client.chat(model="helpdesk-triage",
messages=[{"role": "user", "content": "VPNにつながりません"}])
print(r.message.content)
print(r.done_reason, r.prompt_eval_count, r.eval_count, r.total_duration)
# ストリーミング: 生成された分から順に受け取る
for chunk in client.chat(model="qwen2.5:0.5b", stream=True,
messages=[{"role": "user", "content": "DNSとは何か1文で"}]):
print(chunk.message.content, end="", flush=True)
# 読み込み中のモデルと文脈長
print([(m.model, m.context_length) for m in client.ps().models])chat は役割付きのメッセージ列を受け取り、モデルのテンプレートに沿ってシステムプロンプトや会話履歴を組み立てます。generate は1つの文字列を渡す単発の生成で、raw=True を付けるとテンプレートを通さずにそのまま渡せます。業務ツールでは、Modelfileの SYSTEM と MESSAGE が効く chat を基本にします。
応答には本文のほかに、prompt_eval_count(入力のトークン数)、eval_count(出力のトークン数)、total_duration(処理時間、ナノ秒)、done_reason(stop なら自然に終了、length なら上限で打ち切り)が入っています。これらをログに残しておくと、入力が文脈長を超えそうな問い合わせや、num_predict で途中打ち切りになった回答を後から見つけられます。
上の例の2つ目で qwen2.5:0.5b に「DNSとは何か1文で」と聞いたところ、「ドメイン名サーバーとドメインマップ」という存在しない正式名称で説明を始めました。0.5Bのモデルは配管(APIの呼び出し方)を確かめるためのもので、知識や判断を任せる用途には向きません。業務で使うモデルは、同じコードのまま大きいモデルに替えて評価してください。
構造化出力でJSONを確実に受け取る
format 引数にJSONスキーマを渡すと、Ollamaはそのスキーマに合う文字列しか生成しないよう出力を制約します。スキーマはpydanticのモデルから作れば、受け取った文字列をそのまま型付きのオブジェクトに変換して検証できます。Literal で列挙した値はスキーマの enum になり、分類のラベルが定義外の言葉になることを防げます。
import csv
import sys
from typing import Literal

from ollama import Client, ResponseError
from pydantic import BaseModel, Field, ValidationError

MODEL = "helpdesk-triage"


class Triage(BaseModel):
    category: Literal["アカウント", "ネットワーク", "PC・周辺機器", "ソフトウェア", "その他"]
    urgency: Literal["高", "中", "低"]
    summary: str = Field(max_length=60)


def triage(client: Client, text: str) -> Triage | None:
    try:
        resp = client.chat(model=MODEL, messages=[{"role": "user", "content": text}],
                           format=Triage.model_json_schema())
        return Triage.model_validate_json(resp.message.content)
    except (ResponseError, ValidationError) as e:
        print(f"  要確認: {type(e).__name__}: {str(e)[:80]}", file=sys.stderr)
        return None


def main(src: str, dst: str) -> None:
    client = Client(timeout=120)
    with open(src, encoding="utf-8") as f, open(dst, "w", encoding="utf-8", newline="") as g:
        out = csv.writer(g)
        out.writerow(["id", "category", "urgency", "summary", "text"])
        for row in csv.DictReader(f):
            t = triage(client, row["text"])
            if t is None:  # 失敗した行は人が見る
                out.writerow([row["id"], "要確認", "", "", row["text"]])
                continue
            print(f'{row["id"]}: [{t.category} / {t.urgency}] {t.summary}')
            out.writerow([row["id"], t.category, t.urgency, t.summary, row["text"]])


if __name__ == "__main__":
    main(sys.argv[1], sys.argv[2])
ポイントは、生成とは別に model_validate_json で検証していることです。スキーマの制約で形式はほぼ守られますが、文字数の上限(max_length)のようにスキーマの一部の条件は生成時に必ず守られるとは限りません。検証に失敗した行や、Ollamaがエラーを返した行は「要確認」として残し、人が見る流れにしておけば、ツールが黙って間違ったデータを書き出すことはありません。
実行結果と、小型モデルでの限界
id,text
1,VPNにつながらず在宅で作業できません。今朝から「認証に失敗しました」と出ます。
2,新しく来た派遣社員の方のメールアドレスを金曜までに作ってください。
3,Excelのマクロが急に動かなくなりました。月末の集計に使っています。
4,3階の複合機で両面印刷ができません。急ぎではありません。$ python triage.py tickets.csv result.csv
1: [ネットワーク / 中] VPNの使用に失敗した(今朝から認証失敗)
2: [アカウント / 中] 新しく来た派遣社員のメールアドレスの作成(金曜までに)
3: [ソフトウェア / 中] Excelのマクロが急に動かなくなり、月末の集計に使用しています(月末の集計に使用)
4: [PC・周辺機器 / 中] 複合機の両面印刷機能の追加依頼(3階)分類は4件とも妥当で、JSONの形式も全件でpydanticの検証を通りました。一方、緊急度はすべて「中」になりました。「在宅で作業できません」とある1件目は定義上「高」、「急ぎではありません」と書かれた4件目は「低」が正解です。4件目の要約も、故障の報告を「機能の追加依頼」と読み違えています。判断基準をSYSTEMに書いても、0.5Bのモデルでは条件に沿った判断まではできていません。
実務では、判断を1つのモデルにすべて任せない設計にします。緊急度なら「作業できません」「止まっている」のような語をコードで先に検出して「高」に上書きする、分類だけをLLMに任せて緊急度は申告欄から取る、といった分担が現実的です。どこまで任せられるかは、正解を付けた問い合わせを20〜30件用意して数えると判断できます。評価の進め方はプロンプトエンジニアリング実践にまとめています。
Pythonからモデルを作る・入れ替える
ライブラリの create でもModelfileと同じことができます。0.6系では引数が命令ごとに分かれており、以前の版の modelfile= という引数は使えません。
from ollama import Client

client = Client()
res = client.create(
    model="helpdesk-triage:v2",
    from_="qwen2.5:0.5b",
    system="あなたは情報システム部の受付担当です。",
    parameters={"temperature": 0, "num_ctx": 4096},
)
print(res.status)  # success
コードから作れると、評価スクリプトの中で「システムプロンプトの候補ごとにモデルを作り、同じ問い合わせで比べ、最も良かったものに本番のタグを付ける」という流れを自動化できます。不要になった候補は client.delete("helpdesk-triage:v2") で消せます。
埋め込みと画像入力
RAGのために文章をベクトルに変換するには client.embed() を使いますが、渡すモデルは埋め込み用のものに限られます。チャット用の qwen2.5:0.5b を指定すると、This server does not support embeddings. Start it with --embeddings`` というエラー(HTTP 501)が返りました。埋め込みモデルをOllamaで取得するか、Qdrantで始めるベクトル検索のように別のライブラリで計算して検索基盤に入れます。
画像を読めるモデル(Capabilitiesに vision があるもの)なら、メッセージに images を付けてファイルのパスやバイト列を渡せます。スクリーンショットのエラー画面を読ませる、といった使い方ができますが、画像の中の細かい文字の読み取り精度はモデルによって大きく差があるので、実際の画像で確かめてから業務に入れます。
社内で使うときの設定
- 接続先:スクリプトに書かず、環境変数
OLLAMA_HOST(例:http://ollama.internal:11434)で渡す。Client()は引数がなければこれを読む - 認証:Ollama自体には認証がないため、社内公開は認証付きのリバースプロキシ越しにする。ライブラリは環境変数
OLLAMA_API_KEYがあるとAuthorization: Bearerヘッダーを自動で付けるので、プロキシ側でこのトークンを検証する構成にできる - タイムアウト:
Client(timeout=120)のように必ず付ける。既定はタイムアウトなし(None)で、応答が返らないと処理が止まったままになる - 同時実行:Ollama 0.34.3の既定は
OLLAMA_NUM_PARALLEL=1で、同じモデルへのリクエストは1本ずつ処理される。CSVの一括処理を業務時間中に流すと、対話で使っている人が待たされる - 常駐時間:モデルは最後の利用から既定で5分メモリに残る。一括処理の前後で読み込みが繰り返されるなら、
keep_alive="30m"のように延ばす
OLLAMA_API_KEY のような秘密情報はスクリプトやModelfileに書かず、実行ユーザーの環境変数やシークレット管理の仕組みから渡してください。SYSTEM に書いた内容は、ollama show --modelfile でサーバーを使える誰もが読めます。
動作確認
# 1. モデルの登録とパラメータ
ollama list | grep helpdesk-triage
ollama show helpdesk-triage | sed -n '/Parameters/,/^$/p'
# 期待: temperature 0 / num_ctx 4096 / num_predict 256

# 2. Pythonからの接続
python -c "from ollama import Client; print([m.model for m in Client().list().models])"
# 期待: helpdesk-triage:latest を含む一覧

# 3. 一括仕分けとCSV
python triage.py tickets.csv result.csv && head -3 result.csv
# 期待: id,category,urgency,summary,text の見出しと、1件目の結果行
つまずきポイント
ResponseError: model 'no-such-model' not found(status code 404)
指定したモデル名が登録されていないときのエラーです。ollama list の表示と、タグ(:latest や :v2)まで一致しているかを確認します。別のサーバーのOllamaにつないでいて、そちらにモデルがないというケースも多いので、OLLAMA_HOST の値も合わせて確認してください。
ConnectionError: Failed to connect to Ollama.
全文は Failed to connect to Ollama. Please check that Ollama is downloaded, running and accessible. https://ollama.com/download です。Ollamaが起動していない、OLLAMA_HOST の値が違う、コンテナの中から 127.0.0.1 を指定していて届かない、のいずれかです。コンテナから同じホストのOllamaを使う場合は、ホスト側のアドレスかサービス名を指定します。
TypeError: Client.create() got an unexpected keyword argument 'modelfile'
古い記事のサンプルにある client.create(model=..., modelfile=...) を、現在のライブラリで実行すると出ます。定義の内容を from_・system・parameters・messages などの引数に分けて渡すか、ファイルのまま使う場合はコマンドの ollama create -f で登録します。
This server does not support embeddings.
チャット用のモデルで embed() を呼んだときのエラーです。埋め込み専用のモデルを指定します。RAGの検索精度は埋め込みモデルで大きく変わるので、チャットと同じ系列にこだわらず、日本語に対応したものを選んで比べてください。
よくある質問
OllamaのPythonライブラリはどうインストールしますか?
仮想環境を作って pip install ollama で入ります。uvを使っているなら uv add ollama でも同じです。ライブラリはAPIを呼ぶだけなので、Ollama本体は別にインストールして起動しておく必要があります。版による引数の違いがあるため、ollama==0.6.2 のように固定しておくと安全です。
chatとgenerateの違いは?
chat は役割付きのメッセージ列を受け取り、システムプロンプトや会話履歴をモデルのテンプレートで組み立てます。generate は1つのプロンプト文字列を渡す単発の生成です。Modelfileの SYSTEM や MESSAGE を効かせたい業務ツールでは chat を使います。
画像をPythonから渡せますか?
画像入力に対応したモデルなら、メッセージの images にファイルのパスかバイト列を渡せます。対応しているかは ollama show モデル名 のCapabilitiesに vision があるかで確認できます。今回の qwen2.5:0.5b はテキスト専用です。
OllamaのPythonライブラリでRAGは作れますか?
作れます。embed() で文書と質問をベクトルに変換し、ベクトルデータベースで近い文書を探して、その本文を chat() のメッセージに入れて回答させます。検索部分はQdrantやpgvectorを使うのが一般的で、権限による絞り込みも検索の段階で行います。
まとめ
Modelfileに役割・判断基準・パラメータ・会話の例をまとめて名前を付けると、Pythonのコードはモデル名を指定して結果を検証するだけになります。出力はJSONスキーマで形式を制約し、pydanticで検証して、失敗した行は人に回してください。0.5Bのモデルでは分類は当たっても緊急度の判断は崩れたので、どこまで任せるかは正解付きの問い合わせで数えてから決めます。
次に読む
- Ollamaで始めるローカルLLM入門:Ollama本体の導入と、社内公開するときの構成
- プロンプトエンジニアリング実践:SYSTEMに書く判断基準の作り方と、評価セットでの比べ方
- AIエージェントの作り方:同じライブラリでツール呼び出しのループを組む方法