Qdrant(クワドラント)とは、文章などを数値の並び(ベクトル)に変換して保存し、意味の近いものを高速に探すベクトル検索を行う、Rust製のオープンソースのデータベースです。部署や更新日などの条件による絞り込みも、同じ1回の問い合わせで実行できます。社内文書のRAG(検索した文書をLLMに渡して回答させる構成)で、検索部分を担う用途が代表的です。
ここでは、QdrantをDockerで起動し、Pythonから日本語の社内文書を登録して、権限グループ・部署・更新日で絞り込みながら検索するところまでを、実際の出力つきで進めます。確認に使ったのはQdrant 1.19.1、Pythonクライアント qdrant-client 1.19.1、埋め込みの計算に使う fastembed 0.8.1です。
この記事でわかること
- ベクトル検索とは何か、キーワード検索と結果がどう違うか
- APIキーとループバック待ち受けで安全に始めるDockerの起動手順
- コレクション作成、データ登録、フィルタ付き検索のPythonコードと実行結果
- 日本語の全文インデックスで、漢字だけの語が一致しなかった実例と対処
- スナップショットが消える落とし穴など、運用で先に決めること
ベクトル検索とは:言葉が一致しなくても近い文書を探す
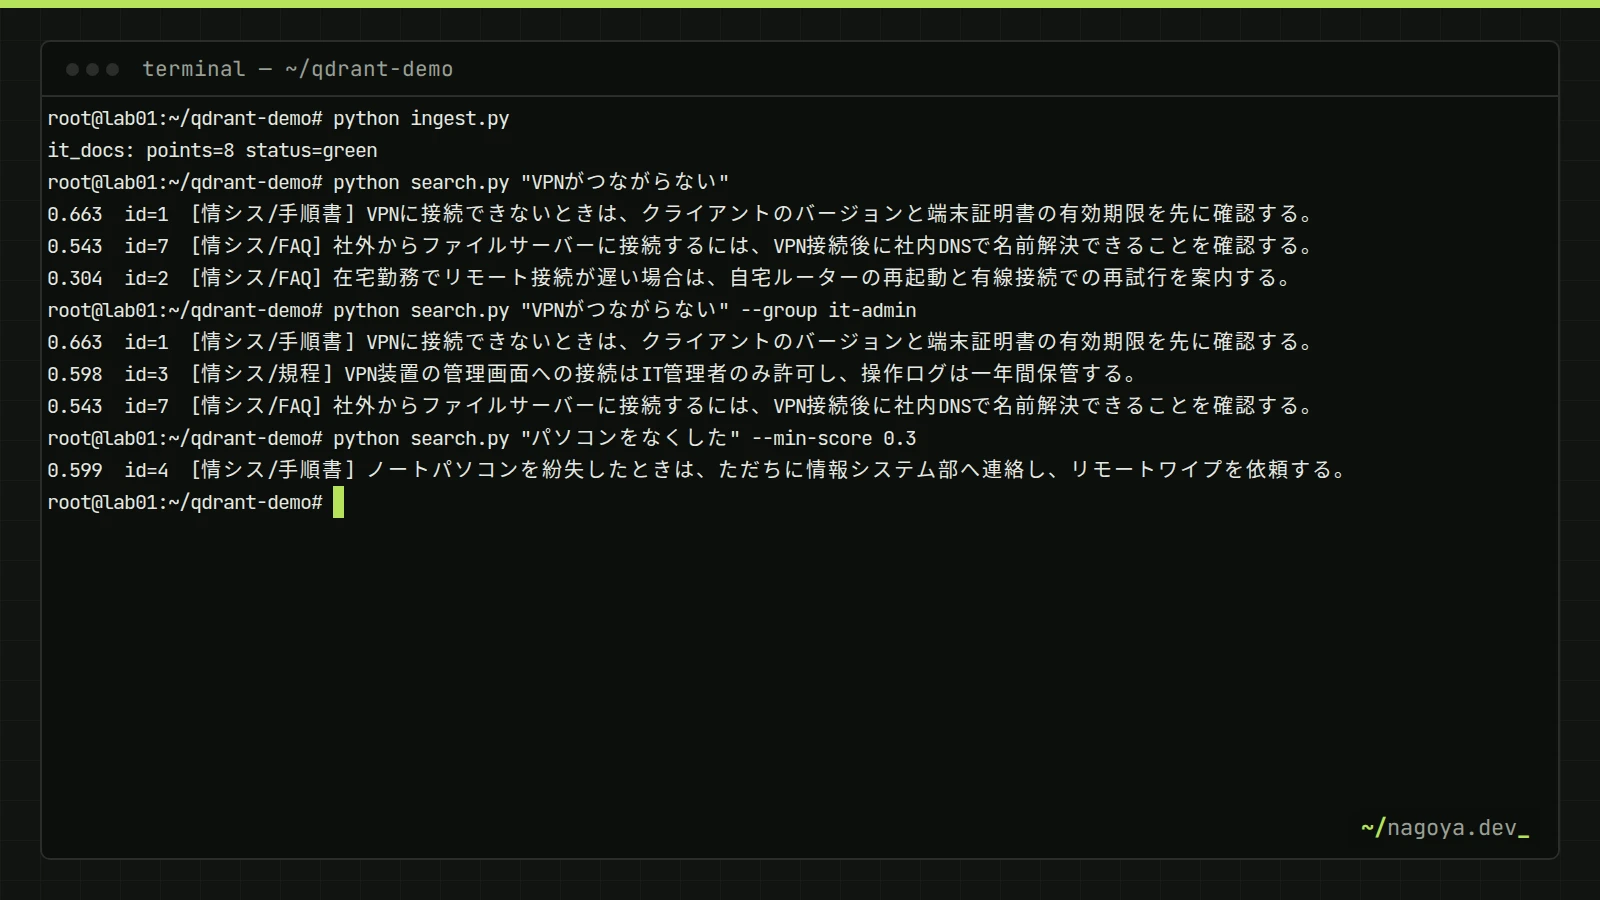
ベクトル検索は、文章を埋め込みモデルで数百〜数千個の数値の並びに変換し、並び同士の近さ(今回はコサイン類似度、1に近いほど似ている)で文書を探す方法です。「パソコンをなくした」で検索すると、「ノートパソコンを紛失したときは…」という文書が類似度0.599で1位に来ました。「なくした」と「紛失」は文字が一致しないため、キーワード検索では見つからない組み合わせです。
苦手なのは、型番、エラーコード、チケット番号のように「その文字列と完全に一致するもの」を探す検索です。埋め込みは意味の近さを表すので、INC-1042 と INC-1043 はほぼ同じ場所に置かれます。こうした条件は、後述するペイロード(付属情報)のフィルタで確実に絞り込み、ベクトル検索と組み合わせます。
Qdrantの用語:コレクション・ポイント・ペイロード
| Qdrantの用語 | 中身 | リレーショナルDBでの近いもの |
|---|---|---|
| コレクション | 同じ次元・距離関数のベクトルの集まり | テーブル |
| ポイント | 1件のデータ。ID、ベクトル、ペイロードを持つ | 行 |
| ベクトル | 埋め込みモデルが出力した数値の並び(今回は384次元) | 検索用の特殊な列 |
| ペイロード | 部署や更新日などのJSON形式の付属情報 | 通常の列 |
| ペイロードインデックス | フィルタを速くするための索引 | インデックス |
ポイントのIDは、符号なし整数かUUIDしか使えません。社内の文書番号(doc-001 など)はそのままIDにできないので、ペイロードに入れておき、IDには連番か、文書番号から作ったUUIDを使います。
Dockerで起動する:127.0.0.1とAPIキーを最初から
Qdrantは既定で認証なしで起動し、コンテナ内では全アドレスで待ち受けます。ポートの公開をホストの 127.0.0.1 に限り、APIキーを環境変数で設定してから始めます。6333番がREST API、6334番がgRPCです。
export QDRANT_API_KEY=$(openssl rand -hex 24)
docker run -d --name qdrant --restart unless-stopped \
  -p 127.0.0.1:6333:6333 -p 127.0.0.1:6334:6334 \
  -e QDRANT__SERVICE__API_KEY="$QDRANT_API_KEY" \
  -e QDRANT__TELEMETRY_DISABLED=true \
  -v qdrant_storage:/qdrant/storage \
  -v qdrant_snapshots:/qdrant/snapshots \
  qdrant/qdrant:v1.19.1

curl -s http://127.0.0.1:6333/
# {"title":"qdrant - vector search engine","version":"1.19.1","commit":"6ab21cac..."}
curl -s http://127.0.0.1:6333/collections
# Must provide an API key or an Authorization bearer token
curl -s -H "api-key: $QDRANT_API_KEY" http://127.0.0.1:6333/collections
# {"result":{"collections":[]},"status":"ok","time":...}
QDRANT__TELEMETRY_DISABLED=true は、使用状況の統計を外部に送る機能を止める設定で、起動ログが Telemetry reporting enabled から Telemetry reporting disabled に変わります。社内のサーバーでは止めておくのが無難です。APIキーを設定しても /healthz・/livez・/readyz の死活監視用URLと、ブラウザで開く管理画面(/dashboard)のページ自体はキーなしで応答しました。管理画面からのデータ操作にはキーの入力が必要です。
-v で永続化するのは /qdrant/storage だけ、という例をよく見かけますが、スナップショットの保存先は別の /qdrant/snapshots です。今回の検証でも、作成したスナップショットは /qdrant/snapshots/it_docs/ に置かれていました。こちらをボリュームにしていないと、コンテナを作り直した時点でバックアップも一緒に消えます。
Python環境と埋め込みモデル
Pythonクライアントに fastembed を付けて入れると、ONNX Runtimeで動く埋め込みモデルをCPUで使えます。モデルは初回実行時にHugging Faceから自動でダウンロードされます。今回は多言語対応で軽い paraphrase-multilingual-MiniLM-L12-v2(384次元、約0.22GB)を使いました。
python3 -m venv .venv && . .venv/bin/activate
pip install "qdrant-client[fastembed]==1.19.1"
fastembed 0.8.1が対応する多言語モデルには、ほかに intfloat/multilingual-e5-large(1024次元、約2.24GB)、google/embeddinggemma-300m(768次元、約1.24GB)などがあります(執筆時点の一覧)。一般に次元が大きく重いモデルほど日本語の検索精度は上がる傾向がありますが、メモリと処理時間も増えます。自社の文書と質問の組で比べてから決め、決めた後は変えない前提で考えてください。モデルを替えると、全文書のベクトルを作り直すことになります。
コレクションを作ってデータを登録する
例として、情シスの手順書やFAQを8件用意しました。groups は閲覧を許可するグループ、updated_at は最終更新日時です。
{"id": 1, "text": "VPNに接続できないときは、クライアントのバージョンと端末証明書の有効期限を先に確認する。", "dept": "情シス", "doc_type": "手順書", "groups": ["all"], "updated_at": "2026-08-01T09:00:00Z"}
{"id": 2, "text": "在宅勤務でリモート接続が遅い場合は、自宅ルーターの再起動と有線接続での再試行を案内する。", "dept": "情シス", "doc_type": "FAQ", "groups": ["all"], "updated_at": "2026-05-12T09:00:00Z"}
{"id": 3, "text": "VPN装置の管理画面への接続はIT管理者のみ許可し、操作ログは一年間保管する。", "dept": "情シス", "doc_type": "規程", "groups": ["it-admin"], "updated_at": "2026-07-20T09:00:00Z"}
{"id": 4, "text": "ノートパソコンを紛失したときは、ただちに情報システム部へ連絡し、リモートワイプを依頼する。", "dept": "情シス", "doc_type": "手順書", "groups": ["all"], "updated_at": "2025-11-02T09:00:00Z"}
{"id": 5, "text": "交通費の精算は、利用日の翌月十日までに経費システムから申請する。", "dept": "総務", "doc_type": "規程", "groups": ["all"], "updated_at": "2026-04-01T09:00:00Z"}
{"id": 6, "text": "入社手続きでは、初日にアカウント発行と多要素認証の登録を行う。", "dept": "人事", "doc_type": "手順書", "groups": ["all"], "updated_at": "2026-06-15T09:00:00Z"}
{"id": 7, "text": "社外からファイルサーバーに接続するには、VPN接続後に社内DNSで名前解決できることを確認する。", "dept": "情シス", "doc_type": "FAQ", "groups": ["all"], "updated_at": "2024-12-10T09:00:00Z"}
{"id": 8, "text": "証明書の更新作業は、期限の二週間前までに変更申請を出し、夜間の保守時間帯に実施する。", "dept": "情シス", "doc_type": "手順書", "groups": ["it-admin"], "updated_at": "2026-09-01T09:00:00Z"}import json
import os
from fastembed import TextEmbedding
from qdrant_client import QdrantClient, models
COLLECTION = "it_docs"
MODEL = "sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2" # 384次元
client = QdrantClient(url=os.environ.get("QDRANT_URL", "http://127.0.0.1:6333"),
api_key=os.environ["QDRANT_API_KEY"])
embedder = TextEmbedding(MODEL)
docs = [json.loads(line) for line in open("docs.jsonl", encoding="utf-8")]
if not client.collection_exists(COLLECTION):
client.create_collection(
COLLECTION,
vectors_config=models.VectorParams(size=384, distance=models.Distance.COSINE),
)
# フィルタに使うフィールドには先にインデックスを作る
client.create_payload_index(COLLECTION, "dept", models.PayloadSchemaType.KEYWORD)
client.create_payload_index(COLLECTION, "groups", models.PayloadSchemaType.KEYWORD)
client.create_payload_index(COLLECTION, "updated_at", models.PayloadSchemaType.DATETIME)
vectors = embedder.embed([d["text"] for d in docs]) # ジェネレーター
points = [
models.PointStruct(id=d["id"], vector=v.tolist(),
payload={k: v2 for k, v2 in d.items() if k != "id"})
for d, v in zip(docs, vectors)
]
client.upsert(COLLECTION, points=points, wait=True)
info = client.get_collection(COLLECTION)
print(f"{COLLECTION}: points={info.points_count} status={info.status}")コレクションの size は埋め込みモデルの次元数と一致させます。フィルタに使う dept・groups はキーワード型、updated_at は日時型のペイロードインデックスを作っておきます。インデックスがなくてもフィルタは動きますが(今回もインデックスのない doc_type での絞り込みは結果を返しました)、件数が増えると全件を調べることになり遅くなります。
$ export QDRANT_API_KEY=...   # 起動時に設定した値
$ python ingest.py
it_docs: points=8 status=green
検索とフィルタ
import argparse
import os

from fastembed import TextEmbedding
from qdrant_client import QdrantClient, models

COLLECTION = "it_docs"
MODEL = "sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2"

p = argparse.ArgumentParser()
p.add_argument("query")
p.add_argument("--group", action="append", default=["all"])  # 利用者の所属グループ
p.add_argument("--dept")
p.add_argument("--since")  # 例: 2026-01-01T00:00:00Z
p.add_argument("--min-score", type=float)
args = p.parse_args()

client = QdrantClient(url=os.environ.get("QDRANT_URL", "http://127.0.0.1:6333"),
                      api_key=os.environ["QDRANT_API_KEY"])
qvec = next(TextEmbedding(MODEL).query_embed(args.query)).tolist()

must = [models.FieldCondition(key="groups", match=models.MatchAny(any=args.group))]
if args.dept:
    must.append(models.FieldCondition(key="dept", match=models.MatchValue(value=args.dept)))
if args.since:
    must.append(models.FieldCondition(key="updated_at",
                                      range=models.DatetimeRange(gte=args.since)))

hits = client.query_points(
    COLLECTION,
    query=qvec,
    query_filter=models.Filter(must=must),
    score_threshold=args.min_score,
    limit=3,
    with_payload=True,
).points
for h in hits:
    d = h.payload
    print(f"{h.score:.3f}  id={h.id}  [{d['dept']}/{d['doc_type']}] {d['text']}")
groups の条件は、利用者の所属グループのどれかが文書の許可グループに含まれるものだけを返す、権限フィルタです。検索結果を得た後に消すのではなく、検索の条件として渡すのがポイントで、上位3件の枠が見せてはいけない文書で埋まることがありません。実行結果は次のとおりです。
$ python search.py "VPNがつながらない"
0.663  id=1  [情シス/手順書] VPNに接続できないときは、クライアントのバージョンと端末証明書の有効期限を先に確認する。
0.543  id=7  [情シス/FAQ] 社外からファイルサーバーに接続するには、VPN接続後に社内DNSで名前解決できることを確認する。
0.304  id=2  [情シス/FAQ] 在宅勤務でリモート接続が遅い場合は、自宅ルーターの再起動と有線接続での再試行を案内する。

$ python search.py "VPNがつながらない" --group it-admin
0.663  id=1  [情シス/手順書] VPNに接続できないときは、クライアントのバージョンと端末証明書の有効期限を先に確認する。
0.598  id=3  [情シス/規程] VPN装置の管理画面への接続はIT管理者のみ許可し、操作ログは一年間保管する。
0.543  id=7  [情シス/FAQ] 社外からファイルサーバーに接続するには、VPN接続後に社内DNSで名前解決できることを確認する。

$ python search.py "VPNがつながらない" --since 2026-06-01T00:00:00Z
0.663  id=1  [情シス/手順書] VPNに接続できないときは、クライアントのバージョンと端末証明書の有効期限を先に確認する。
0.086  id=6  [人事/手順書] 入社手続きでは、初日にアカウント発行と多要素認証の登録を行う。

$ python search.py "パソコンをなくした" --min-score 0.3
0.599  id=4  [情シス/手順書] ノートパソコンを紛失したときは、ただちに情報システム部へ連絡し、リモートワイプを依頼する。
3つ目の結果に注目してください。更新日で絞ると関係のある文書が1件しか残らず、類似度0.086の無関係な人事の文書が2位に入りました。ベクトル検索は「近い順に指定件数」を返すので、条件に合う文書が少ないと、関係の薄いものまで結果に入ります。LLMに渡す前に score_threshold(スクリプトでは --min-score)で足切りするのはこのためです。しきい値はモデルと文書によって変わるので、実際の質問で結果を見ながら決めます。今回のモデルでは、質問に直接答える文書が0.54〜0.66、話題が近いだけの文書が0.30前後、無関係な文書が0.21以下でした。
日本語のキーワード条件:全文インデックスの注意
ベクトル検索にキーワードの一致条件を足したい場合、Qdrantにはペイロードの文字列に全文インデックスを作り、MatchText で絞り込む機能があります。日本語向けに multilingual トークナイザーで text フィールドに索引を作って試したところ、結果は次のようになりました。
| 検索語 | 一致した文書ID |
|---|---|
| VPN | 1、3、7 |
| パソコン | 4 |
| 情報システム部 | 4 |
| 証明書の | 1、8 |
| 紛失した | 4 |
| 証明書 | なし |
| 紛失 | なし |
| 接続 | なし |
本文に含まれているのに、「証明書」「紛失」「接続」のように漢字だけの語は1件も一致せず、かなやカタカナを含む語は一致しました。多言語トークナイザーは文字の種類から言語を推定して分割方法を選ぶため、漢字だけの短い検索語が日本語として分割されなかったと考えられます。日本語のキーワード条件を確実に効かせたいなら、アプリ側で形態素解析した語を keywords のような配列でペイロードに入れてキーワード型のインデックスを作り、MatchAny で絞る方法のほうが結果を予測しやすくなります。
全文インデックスの挙動は、トークナイザーの種類と検索語の文字種で大きく変わります。導入前に、利用者が実際に入力しそうな語(漢字だけの語、カタカナ語、英数字の型番)で一致するかを表にして確認してください。
運用:スナップショット、メモリの見積もり、版の固定
- バックアップ:
client.create_snapshot("it_docs")でコレクション単位のスナップショットができる。今回は8件で240,128バイトのファイルになった。/qdrant/snapshotsをボリュームにし、別のサーバーへ定期的にコピーする - メモリ:ベクトル本体は「件数×次元数×4バイト」で見積もる。384次元で100万件なら約1.5GB、1024次元なら約4.1GBで、これにHNSW索引とペイロードの分が加わる。足りない場合は、ベクトルをディスクに置く設定やスカラー量子化(1次元を1バイトで持つ)で減らせる
- 索引:件数が少ないうちは
indexed_vectors_countが0のままで、HNSW(近似最近傍探索の索引)を作らずに全件を比較して検索する。今回の既定値はm=16、ef_construct=100だった。件数が増えてから、精度と速度を見て調整する - 版の固定:イメージは
qdrant/qdrant:v1.19.1のように版を指定し、クライアントも同じ系列の版にそろえる。更新前にスナップショットを取る
Dockerを使わない選択肢:ローカルモード
動作確認やテストだけなら、サーバーを立てずにPythonの中でQdrantを動かせます。QdrantClient(path="./qdrant_local") と書くとディレクトリにデータを保存し、QdrantClient(":memory:") ならメモリ上だけで動きます。今回も同じAPIでコレクションの作成、登録、検索が動きました。ただし1つのプロセスからしか開けないので、複数の利用者やアプリが使う本番ではサーバー版を使います。
動作確認
# 1. サーバーの版と認証
curl -s http://127.0.0.1:6333/ | jq -r .version        # 期待: 1.19.1
curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:6333/collections   # 期待: 401

# 2. 登録件数と状態
curl -s -H "api-key: $QDRANT_API_KEY" http://127.0.0.1:6333/collections/it_docs \
  | jq '.result | {points_count, status}'
# 期待: {"points_count": 8, "status": "green"}

# 3. 権限フィルタ(it-admin だけに見える文書 id=3 の出し分け)
python search.py "VPNがつながらない" | grep -c 'id=3'                    # 期待: 0
python search.py "VPNがつながらない" --group it-admin | grep -c 'id=3'   # 期待: 1
つまずきポイント
Must provide an API key or an Authorization bearer token
APIキーを設定したサーバーに、キーなしでアクセスしたときの401エラーです。curlでは -H "api-key: ..." を、Pythonでは QdrantClient(url=..., api_key=...) を指定します。Pythonで http:// のままキーを使うと UserWarning: Api key is used with an insecure connection. が出ます。同じホスト内の接続なら問題ありませんが、別のサーバーから接続するならTLSを付けてください。
Wrong input: Vector dimension error: expected dim: 384, got 3
コレクション作成時の size と、登録・検索するベクトルの次元数が違うときのエラーです。埋め込みモデルを替えたときに起きやすく、既存のコレクションの次元は変えられないため、新しい次元でコレクションを作り直して全件を登録し直します。モデル名と次元数をコレクション名に含めておく(例:it_docs_minilm384)と取り違えを防げます。
value doc-1 is not a valid point ID
正確には Format error in JSON body: value doc-1 is not a valid point ID, valid values are either an unsigned integer or a UUID と表示されます。文字列の文書番号をIDにしようとしたときのエラーで、IDは整数かUUIDにします。同じ文書を更新するたびに同じIDになるよう、Pythonの uuid.uuid5() で文書番号からUUIDを作る方法が使えます。
よくある質問
Qdrantのインストール方法は?
手早いのはDockerの qdrant/qdrant イメージで、この記事の docker run の1行で起動します。Dockerを使えない環境向けに、GitHubのリリースにはLinux用の単体バイナリ(約32MB)も用意されています。Pythonからのテスト用途なら、サーバーなしで動くローカルモードも使えます。
ベクトルデータベースとは何ですか?
文章や画像を埋め込みモデルで数値の並びに変換したものを保存し、近いものを高速に探すことに特化したデータベースです。付属情報での絞り込みも同時に行えます。既存のPostgreSQLに拡張機能のpgvectorを入れて同じことをする方法もあり、どちらを選ぶかは件数と運用体制で決めます。
ローカルLLMとRAGの違いは何ですか?
ローカルLLMは、文章を生成するモデルを自社のPCやサーバーで動かすことです。RAGは、質問に関係する社内文書を検索してLLMに渡し、それを根拠に回答させる構成のことで、LLMがクラウドでもローカルでも組めます。この構成の中で、検索を担当する部品がQdrantです。
Qdrantは無料で使えますか?
ライセンスはApache License 2.0のオープンソースで、自分のサーバーで動かす限り費用はかかりません。運用を任せるクラウド版は別の料金体系で提供されているため、費用は執筆時点の公式サイトで確認してください。
まとめ
Qdrantは、APIキーとループバック待ち受けを付けて1行で起動でき、Pythonからはfastembedと組み合わせて数十行で登録と検索ができます。権限は検索の条件として渡し、関係の薄い文書は類似度のしきい値で落としてください。日本語の全文インデックスは漢字だけの語で一致しないことがあるため、実際の検索語で確かめてから使い、スナップショットの保存先もボリュームにしておきます。
次に読む
- pgvectorとPythonで作る社内文書RAG:PostgreSQLで同じ権限フィルタ付き検索を作る場合の設計
- RAGとは?仕組みと社内導入で失敗しない設計原則:検索結果をLLMに渡す構成全体の考え方
- LoRAとは?ファインチューニングとRAGの使い分け:検索で渡すべき情報と、学習で変えるべき振る舞いの切り分け