PaddleOCRの使い方:Pythonで日本語の書類を読み、Tesseractと比べる
PaddleOCR 3.7.0をCPUのコンテナで動かし、自作の日本語文書4枚から文字・座標・信頼度をJSON化。Tesseractと誤り率・速度・メモリを実測し、ネットワーク遮…
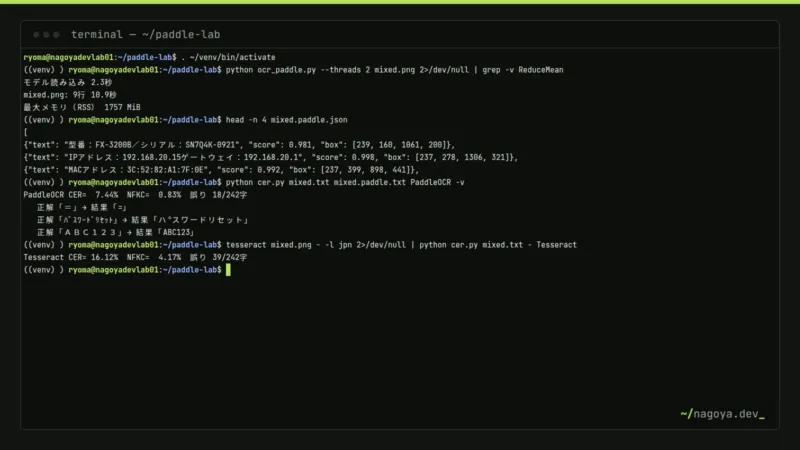
PaddleOCR 3.7.0をCPUのコンテナで動かし、自作の日本語文書4枚から文字・座標・信頼度をJSON化。Tesseractと誤り率・速度・メモリを実測し、ネットワーク遮…
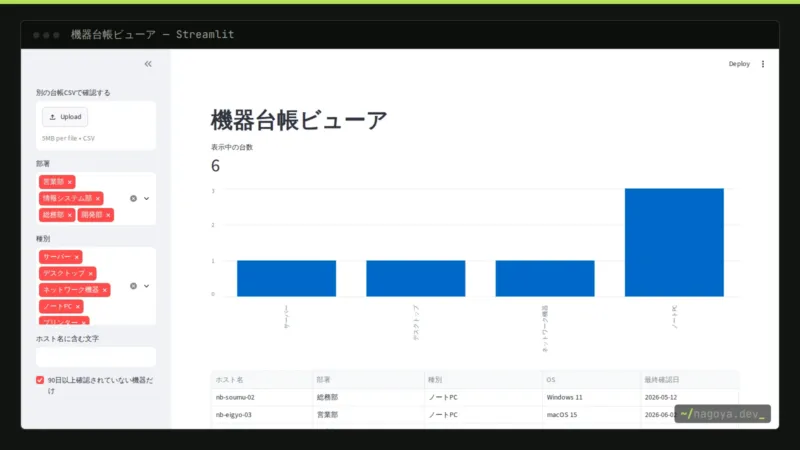
Streamlit 1.66.0で機器台帳ビューアを作り、再実行・session_state・cache_dataの挙動をAppTestで確認。Docker化とnginxのWeb…
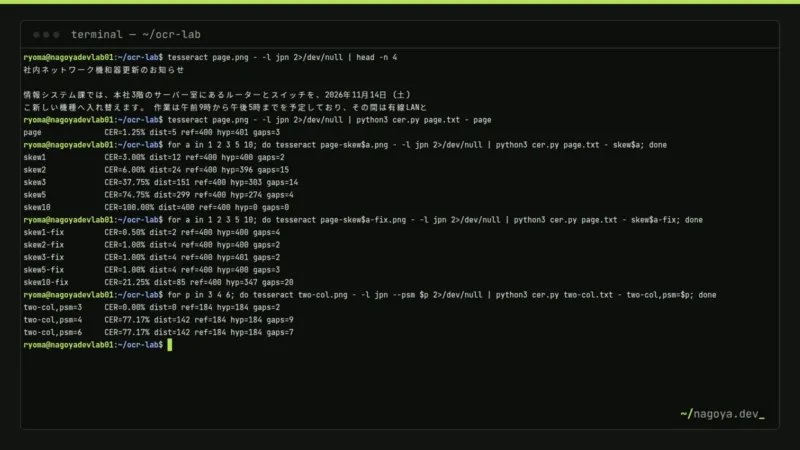
Tesseract 5.5.0で自作の日本語画像を読み、傾き・解像度・影・--psm・言語データを1つずつ変えて文字誤り率を実測。OCRmyPDFでスキャンPDFを検索可能にする…
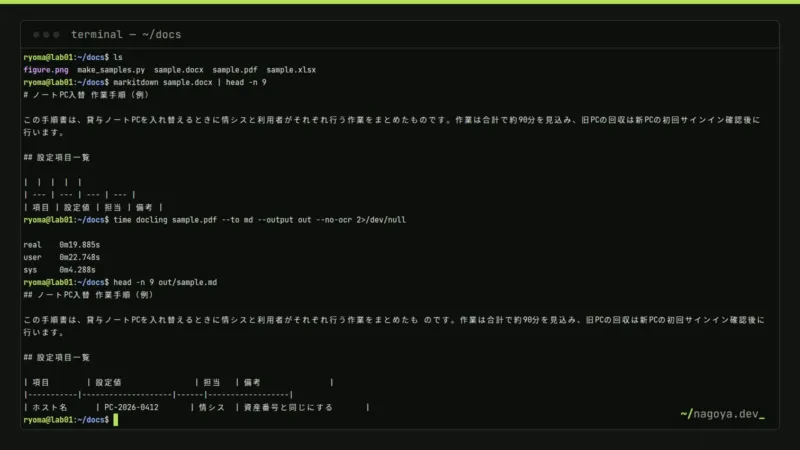
自作の日本語PDF・Word・ExcelをMarkItDown 0.1.8とDocling 2.130で変換し、速度・メモリ・表と見出しの再現・OCRを実測。RAG取り込みの判断…
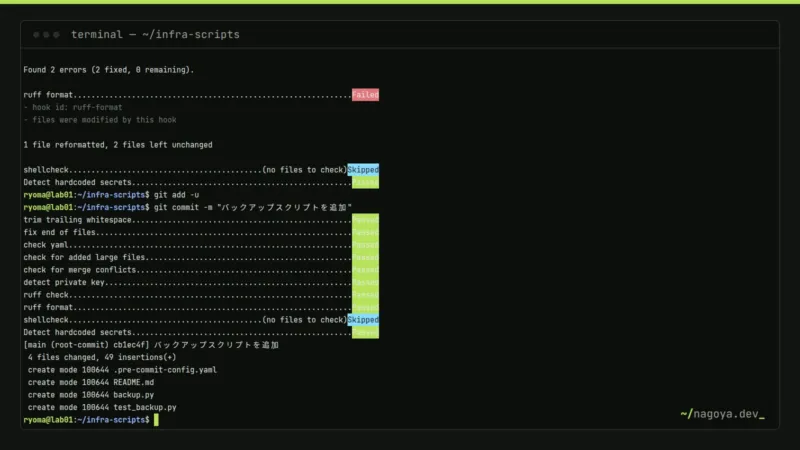
pre-commit 4.6でruff・shellcheck・gitleaks・pytestをコミット前とpush前に動かす設定、止まったときの直し方、GitHub Action…
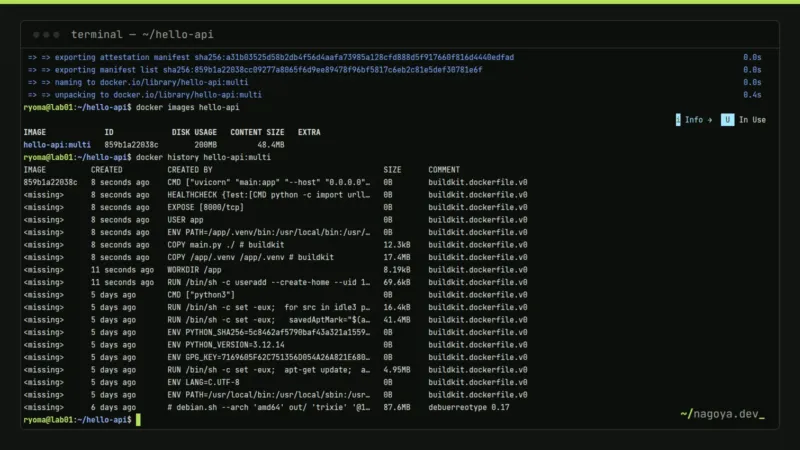
Dockerfileの書き方を実測つきで整理。キャッシュが効く順番、.dockerignore、uvを使ったPythonのマルチステージビルドで1.65GBを200MBにした手順…
業務用プロンプトを5つの部品で組み立てる方法と、正解付きの評価セットで版を比べる検証手順を実例で解説。丁寧に書いた版が小型モデルでは負けた実測結果と、その読み解き方も載せています。
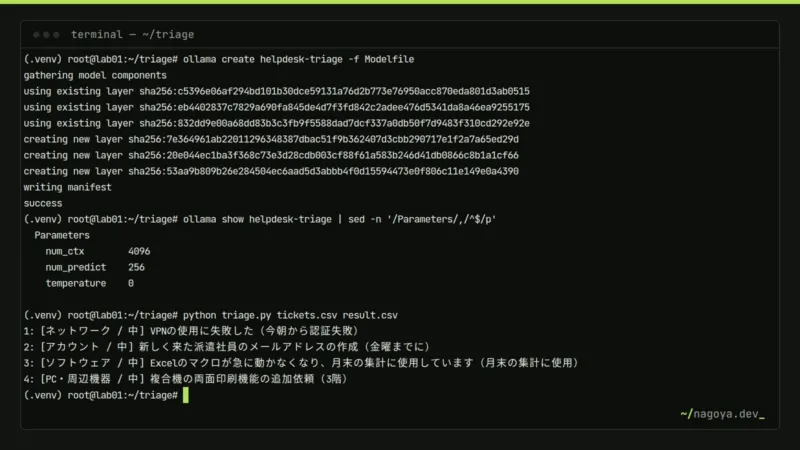
Modelfileで役割・判断基準・会話例を固定し、OllamaのPythonライブラリで問い合わせを仕分けるCSVツールを作成。構造化出力とpydanticでの検証、実際のエラ…
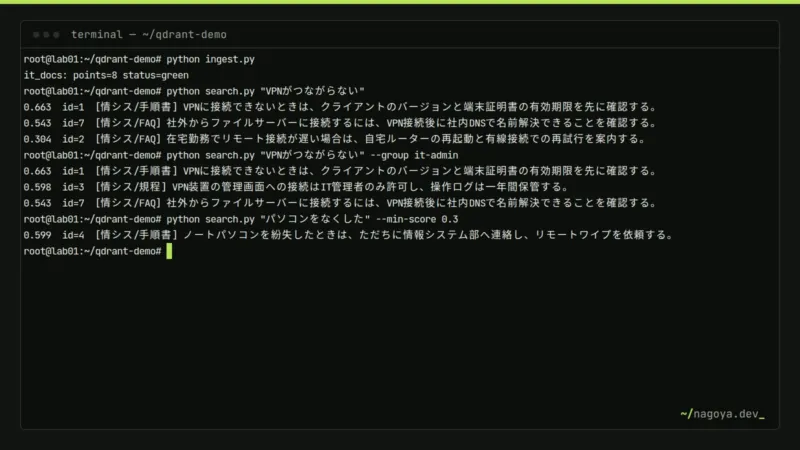
QdrantをAPIキー付きでDocker起動し、fastembedで日本語の社内文書を登録して、権限グループ・部署・更新日で絞り込む検索を実装。日本語全文インデックスの注意点や…
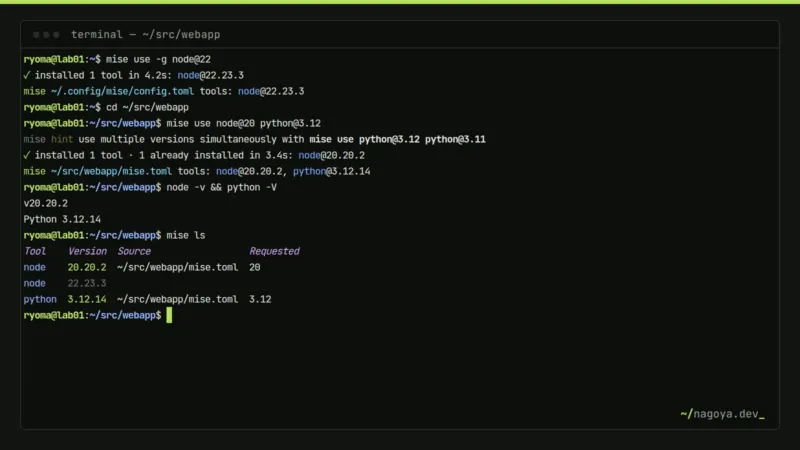
mise 2026.9でNode.jsとPythonの版をディレクトリごとに切り替える手順。nvm・pyenvからの移行、.nvmrcを読ませる設定、mise.tomlの環境変数…
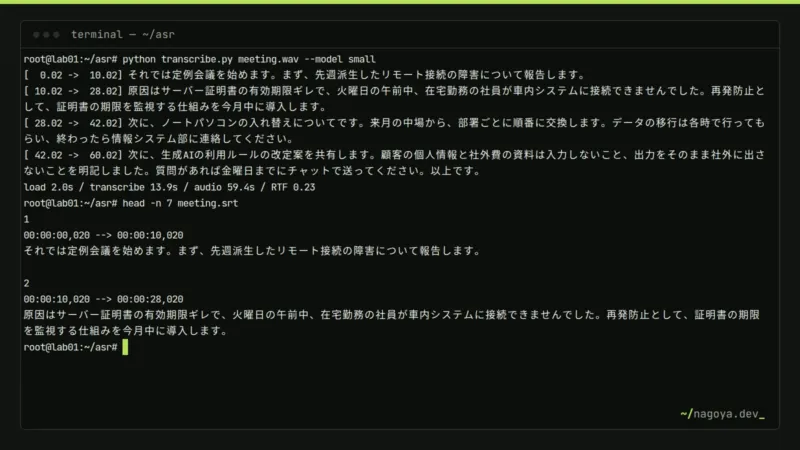
faster-whisperとwhisper.cppをCPUだけの環境に入れ、正解付きの日本語音声で処理時間・メモリ・文字誤り率を実測。句読点が消える設定やm4aが読めない問題な…
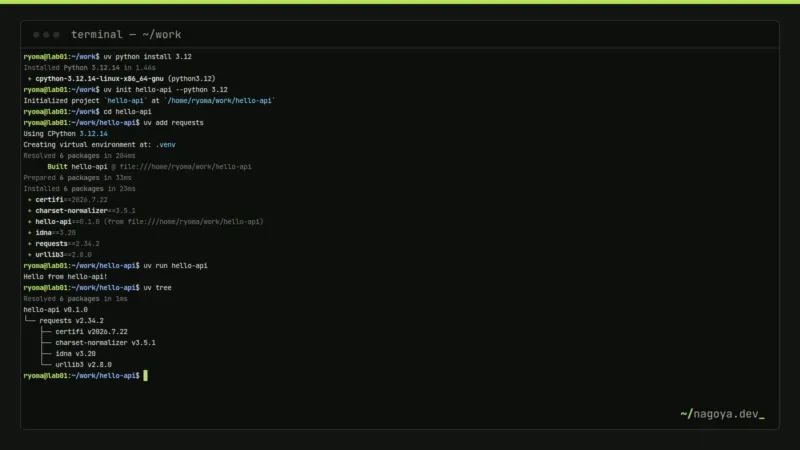
uv 0.12でPython本体・仮想環境・パッケージをまとめて管理する手順。uv init/add/runとuv.lock、requirements.txtからの移行、実測した…