ローカルLLMの選び方【2026年版】:用途別おすすめモデルと必要なGPU・メモリの目安
モデルサイズと量子化からVRAMを見積もる早見表、日本語・コーディング・要約・画像・埋め込みの用途別に試す系列、GPU構成の目安、ライセンス確認と企業導入の10項目をまとめました。
ローカルLLMとは、公開された重み(オープンウェイト)を持つ大規模言語モデルを、クラウドのAPIではなく自分のPCやサーバー上で動かす使い方です。データが外に出ない、トークン課金がない、オフラインでも動く、という利点と引き換えに、最上位のクラウドモデルより品質は下がり、GPUとメモリの手当てと運用が自分の仕事になります。
2026年執筆時点の状況に合わせて、モデルサイズと量子化からメモリ必要量を見積もる早見表、用途別に「まず試す系列」、PCとGPUの目安、ライセンスの確認方法、企業導入のチェックポイントを判断基準の形でまとめます。個別モデルの優劣は数か月で入れ替わるので、モデル名は執筆時点の代表例として読み、判断の軸のほうを持ち帰ってください。
この記事でわかること
- クラウドAPIではなくローカルLLMを選ぶべき条件と、選ばないほうがよい条件
- 「12B」「Q4_K_M」からVRAM必要量を計算する方法と、実際のファイルサイズに基づく早見表
- 日本語チャット・コーディング・要約・画像入力・埋め込みの用途別に、執筆時点でまず試す系列
- Apple Silicon、VRAM 8/12/16/24GB、CPUのみ、それぞれで動くモデルの上限
- ライセンスの確認手順と、企業導入で先に決めておく10項目
ローカルLLMとクラウドAPIの違い
| 観点 | クラウドAPI | ローカルLLM |
|---|---|---|
| データの所在 | 事業者の環境に送られる。学習利用の有無は契約次第 | 自社のサーバーから出ない |
| 費用の構造 | トークン従量。使うほど増える | GPUと電気代の固定費。使うほど単価が下がる |
| 品質の上限 | 最上位モデルが使える | 手元のGPUに載るサイズが上限。27〜31B級で「十分実用」、最上位には届かない |
| 同時処理と遅延 | 事業者側でスケール | GPU 1枚なら同時数人。増やすには自分で並列化 |
| 運用負荷 | ほぼゼロ | モデル更新、GPUドライバ、監視、バックアップが自分の仕事 |
| 閉域・オフライン | 不可 | 可能 |
| 監査・ログ | 事業者の管理コンソールの範囲 | プロンプトから応答まで全部自分で記録できる(記録しない選択も) |
ローカルを選ぶべき条件は4つです。データを社外に出せない(閉域、契約、個人情報)、分類・要約・抽出のような定型処理を大量に回す、オフラインの拠点や検証環境で使う、社内RAGの検索と生成を自分で制御したい。逆に、少人数で最高品質の文章や推論が欲しい、GPUの予算も置き場所もない、利用のピークが読めない、という状況ではクラウドAPIのほうが安く済みます。実務ではデータ区分で振り分けるのが落としどころで、社外秘を含む処理はローカル、公開情報の要約や翻訳はクラウド、という二本立てが多くの組織で成立します。
モデルサイズと量子化:VRAM・メモリの早見表
「12B」はパラメータ数120億、「Q4_K_M」は1パラメータを約4ビットで保持する量子化方式です。元のFP16なら1パラメータ2バイトで12Bは24GBですが、4ビット系ではおよそ0.55〜0.6バイトになり7GB台に収まります。Kはllama.cppのK-quant方式、Mは高精度を残す層の割合がMediumという意味で、同じ4ビットでも旧来の q4_0 より劣化が小さい代わりに少し大きくなります。品質はQ8_0(ほぼ無劣化)、Q6_K、Q5_K_M、Q4_K_M(標準)、Q3以下(劣化が目立つ)の順で、Ollamaライブラリの既定タグは執筆時点でほぼ4ビット系です。
実行時に必要なメモリは「ファイルサイズ + KVキャッシュ + 1GB前後の作業領域」で、KVキャッシュはコンテキスト長と同時リクエスト数に比例します。表の「実行時の目安」は4K〜8Kコンテキストで1人が使う場合の値で、RAGで32Kを使う、同時に5人が使う、といった条件では数GB単位で増えます。
| モデル(Ollamaの既定タグ) | パラメータ | ファイルサイズ(執筆時点) | 実行時の目安 | 収まる構成 |
|---|---|---|---|---|
| llama3.2:3b | 3B | 2.0GB | 3〜4GB | VRAM 4GB、またはCPU + RAM 8GB |
| qwen3.5:4b | 4B | 3.4GB | 5〜6GB | VRAM 6〜8GB |
| granite4.1:8b | 8B | 5.3GB | 7〜8GB | VRAM 8GB(短い文脈)〜12GB |
| qwen3.5:9b | 9B | 6.6GB | 9〜10GB | VRAM 12GB |
| gemma4:12b | 12B | 7.6GB | 10〜11GB | VRAM 12GB(4K)〜16GB |
| granite4.1:30b | 30B | 17GB | 20GB前後 | VRAM 24GB |
| qwen3.8:27b | 27B | 18GB | 21〜22GB | VRAM 24GB、Mac 32GB |
| gemma4:31b | 31B | 20GB | 23〜24GB | VRAM 24GB(短い文脈のみ)、Mac 48GB以上 |
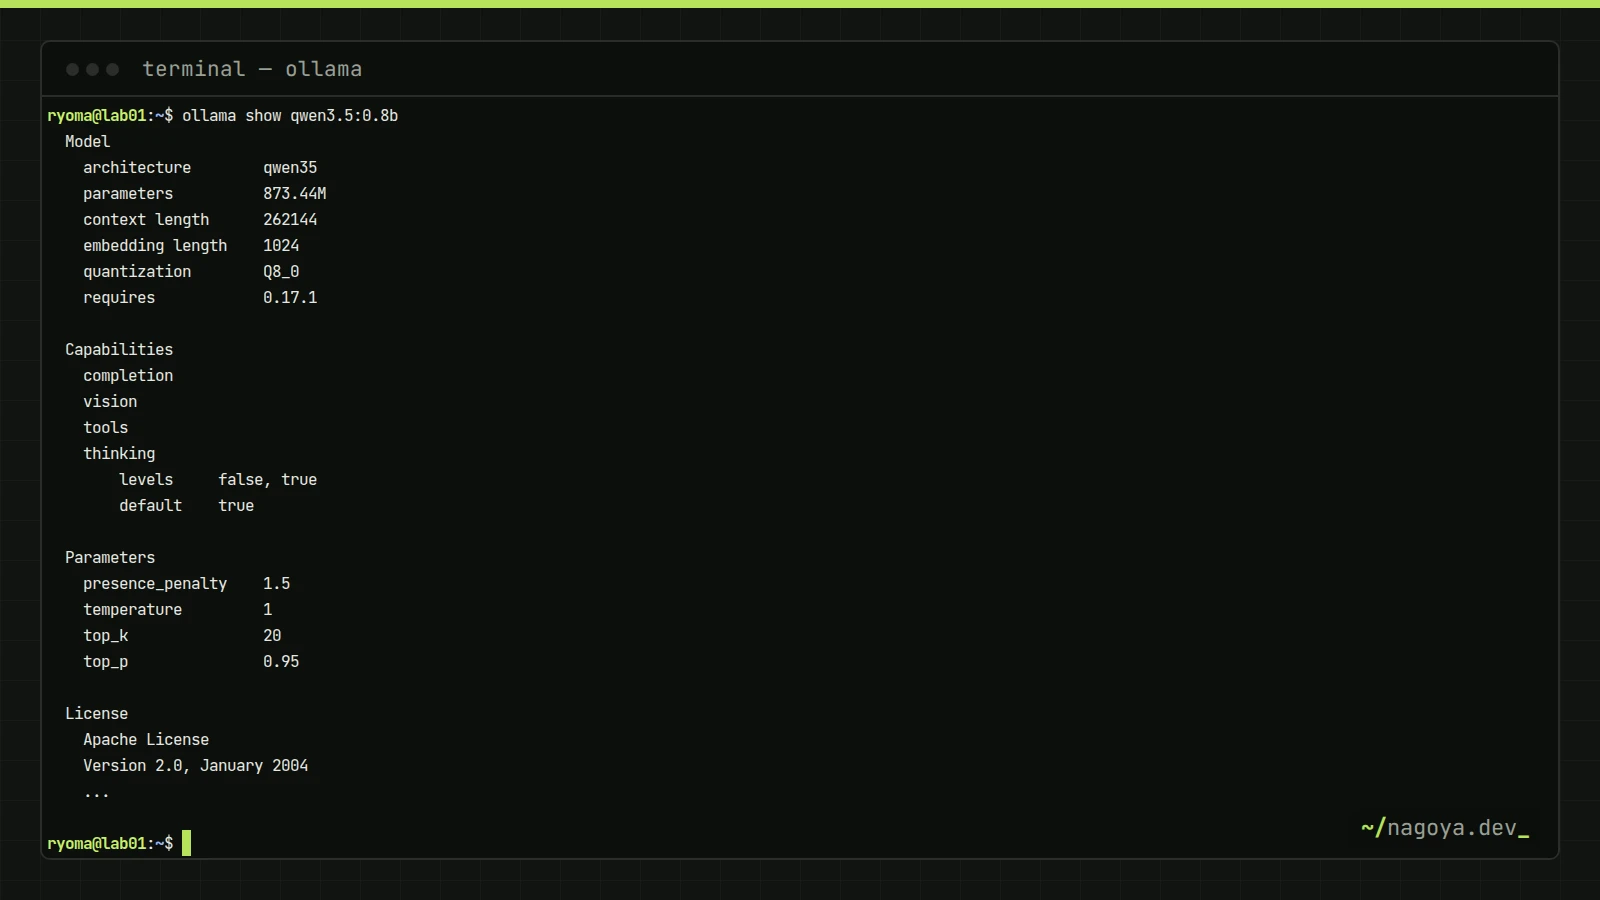
同じメモリに「大きいモデルのQ4」と「小さいモデルのQ8」のどちらも載るなら、一般には前者のほうが賢く振る舞います。例外はコード生成や数値の厳密さが要る用途で、Q4では細部が崩れやすいため、サイズを一段落としてでもQ5以上を選んだほうが結果が安定します。タグの読み方と ollama show での確認手順はOllama入門で扱っています。
MoE(Mixture of Experts)型のモデル(例: gemma4:26b、ファイル19GB)は、1トークンごとに一部の専門家層だけを計算するため、同じファイルサイズの通常モデルより生成が速くなります。ただしメモリには全専門家を載せる必要があるので、必要メモリは減りません。「速いが軽くはない」と覚えてください。
用途別の選び方(執筆時点の代表例)
| 用途 | まず試す系列(執筆時点) | サイズの目安 | 判断のポイント |
|---|---|---|---|
| 日本語チャット、文書作成 | Qwen3.5 / 3.6 / 3.8、Gemma 4、Llama 3.x | 9〜12B以上 | 4B以下は簡体字の混入や敬語の崩れが出やすい。自社文書で要約・敬語メール・議事録整理の3問を試す |
| コーディング(補完、レビュー) | Qwen2.5-Coder(0.5〜32B)、Qwen3-Coder(30B〜)、汎用モデルの思考モード | 補完は7B以下で速度優先、レビューは27B以上 | 量子化はQ5以上。エディタ側のローカルモデル対応を先に確認 |
| 要約、分類、抽出(大量バッチ) | llama3.2:3b、qwen3.5:4b、granite4.1:3b / 8b | 3〜8B | 出力をJSONに固定して後処理しやすくする。スループット重視ならvLLMも検討 |
| 画像、PDF(マルチモーダル) | Gemma 4(画像。E2B / E4Bは音声も)、Qwen3.5 / 3.8(vision)、glm-ocr(文書OCR) | 12B前後以上 | 画像トークンの分だけVRAMが増える。表の読み取りはOCR特化モデルのほうが崩れにくい |
| 埋め込み(RAGの検索) | bge-m3、qwen3-embedding:0.6b、embeddinggemma、Ruri(日本語、コミュニティ配布) | 0.3〜0.6B | 多言語対応と次元数(pgvectorのHNSW索引は2,000次元まで) |
| 日本語特化 | ELYZA、Sarashina(SB Intuitions)、LLM-jp、Swallow、PLaMo など | 7〜13B | 主にHugging FaceでGGUF配布。Ollamaライブラリのコミュニティ再配布は出所とチャットテンプレートを確認 |
Qwen3.xやGemma 4には、回答前に思考を書き出す「思考モード」があります。コーディングや計算を伴う質問では精度が上がる一方、トークン消費と応答時間が数倍になるので、社内チャットや要約では切っておき、必要な用途だけ有効にする使い分けが現実的です。
PC・GPUの目安
生成速度を決めるのはメモリ帯域です。1トークン生成するたびにモデル全体を読み込むので、理論上の上限は「帯域 ÷ モデルのバイト数」になります。GPU専用メモリの帯域は数百GB/sから1TB/s超、Apple Siliconのユニファイドメモリは機種により100〜800GB/s、デュアルチャネルDDR5はおよそ80GB/sで、この差がそのまま体感速度の差です。入力を読み込むプリフィルは計算律速で、CPUでは長い文書を渡すたびに数十秒待つことになります。
| 構成 | 快適に動く上限(Q4) | 向く使い方 | 注意 |
|---|---|---|---|
| Apple Silicon 16GB | 9B | 個人の試用 | OSやブラウザとメモリを共有する。常駐アプリを閉じて使う |
| Apple Silicon 32GB | 27B | 1〜3人の社内試用 | GPU専用機より生成は遅い。静音・省電力が利点 |
| Apple Silicon 64GB以上 | 31B Q8、70B Q4 | 品質優先の少人数利用 | Mac中心の組織では最も導入が簡単 |
| NVIDIA 8GB | 4B(8Bは短い文脈のみ) | 分類・要約のバッチ | 日本語チャットには力不足 |
| NVIDIA 12GB | 8〜9B(12Bは4K文脈) | 少人数の社内チャット | RAGで文脈を広げると溢れる |
| NVIDIA 16GB | 12B | RAG + チャット | 27B級は載らない |
| NVIDIA 24GB(RTX 3090 / 4090)、32GB(RTX 5090) | 27〜31B | 部署単位の利用 | 同時利用が増えたらKVキャッシュ分の余裕が要る |
| 48GB以上(プロ向けGPU、複数枚) | 70B | 全社試験、品質検証 | 電源・冷却・ラックの手当てが先 |
| CPUのみ(DDR5 32GB) | 3〜4B | 定型処理の検証 | 帯域律速で対話用途には遅い |
執筆時点のOllamaの要件は、NVIDIAがcompute capability 5.0以上とドライバ550以降(Windowsは551.61以降)、AMDはROCm v7またはVulkan、Intel GPUはVulkan経由、Appleは Metal です。10人以下の社内試用なら、24GB級のNVIDIA GPU 1枚にOllamaを載せる構成を勧めます。27〜31B級が動き、Dockerと共存でき、壊れたときの切り分けが楽だからです。この判断が変わるのは、Mac中心の組織(64GB以上のMacのほうが手軽)と、同時利用が20人を超える場合(vLLMと複数GPUの世界)の2つです。
ライセンス:商用利用可否の確認方法
| ライセンス | 執筆時点の代表例 | 主な条件(必ず原文で確認) |
|---|---|---|
| Apache 2.0 | Granite、Qwenの多く、Mistralの一部、bge-m3 | 商用可、改変可。著作権表示と変更点の明示、特許条項 |
| MIT | DeepSeek系、GLM系の一部 | 商用可。著作権表示の保持のみ |
| Llama Community License | Llama 3.x、Llama 4 | 商用可だが独自条件。表示義務、月間利用者数の閾値を超える場合の別途許諾、利用規約(AUP) |
| Gemma Terms of Use | Gemma 3 / 4 とその派生 | 禁止用途ポリシーが派生モデルにも及ぶ。再配布時の条件付与 |
| 研究用途限定、独自ライセンス | 一部の日本語特化・研究モデル | 商用不可、または申請制の場合がある |
確認は3段階です。まず ollama show モデル名 --license かHugging Faceのモデルカードで原文を読む。次に、ファインチューニング済みモデルはベースモデルのライセンスを引き継ぐので、ベースと派生の両方を確認する。最後に「社内利用」「自社サービスへの組み込み」「再配布」のどれに当たるかを整理する。社内利用だけならほとんどのライセンスで問題になりませんが、顧客向けサービスに組み込む場合は表示義務や利用規約が効いてくるので、法務に原文を渡してください。モデル名、タグ、ダイジェスト、ライセンス、承認済み用途を1行ずつ記録した「モデル台帳」を作っておくと、監査でも更新時にも困りません。
latest タグや既定タグは、ライブラリ側の更新で中身の重みが入れ替わります。評価したモデルと本番のモデルが同じである保証は、gemma4:12b のようなサイズ付きタグと、ollama list に出るIDの記録でしか取れません。ライセンスも版で変わることがあるので、台帳には確認日も入れます。
企業導入時のチェックポイント
推論サーバーの選択は最初の分かれ道です。執筆時点の主な選択肢を、判断に効く軸で比べます。
| 観点 | Ollama | vLLM |
|---|---|---|
| 得意な規模 | 同時数人まで。1モデルあたり既定1並列(OLLAMA_NUM_PARALLEL で増やす) | 数十〜数百の同時リクエスト。連続バッチ処理で高スループット |
| モデル形式 | GGUF(量子化済み)。CPU・Apple Siliconでも動く | safetensors(FP16 / 各種量子化)。基本はNVIDIA GPU前提 |
| 運用の手間 | 1バイナリ。モデルの取得・切替が1コマンド | 起動時にモデルを固定。GPUメモリの割り当て設計が要る |
| API | 独自API + OpenAI互換 | OpenAI互換 |
| 向く判断 | 試用、部署単位、ホームラボ、Mac | 全社向けAPI基盤、バッチ処理の高速化 |
サーバーを決めたら、次の10項目を導入前に埋めます。空欄が多いほど、PoCが終わったあとに止まります。
- 目的と評価指標:何の業務を、どの精度で、何人が使うか。「試してみたい」だけなら個人のPCで済ませる
- データ区分:社外秘・個人情報を入れてよい前提なら、ログの扱いも同時に決める
- モデル台帳:タグ、ID、ライセンス、承認用途、確認日
- ハードウェア:同時利用数 × コンテキスト長からVRAMを逆算する。GPUの電源容量と設置場所
- 推論サーバーとUI:Ollama + Open WebUI で始めるか、API基盤として作るか
- 認証とアクセス制御:無認証のAPIをLANに出さない。SSO連携の要否
- ログ方針:プロンプトと応答を保存するか、誰が見るか、保存期間
- 評価セット:自社文書での30問。モデル更新のたびに同じセットで比較する
- 更新方針:月次で候補を評価し、合格したものだけタグを切り替える。自動更新はしない
- フォールバック:GPU故障時や高負荷時にクラウドAPIへ逃がすか、止めるか
ガイドライン面の整理は生成AIの社内利用ガイドラインの作り方に、ホームラボで常駐させる場合の位置づけは自宅サーバーの用途10選にまとめています。
よくある質問
ローカルLLMはどれがいいですか?
用途とメモリで決まります。日本語チャットならVRAM 12GBで gemma4:12b か qwen3.5:9b、24GBなら qwen3.8:27b か gemma4:31b、バッチ処理なら llama3.2:3b や granite4.1:8b が執筆時点の出発点です。最終判断は自社文書の30問テストで行ってください。
ローカルLLMは実用的ですか?
用途を限れば実用です。社内文書の要約、分類、定型文生成、RAGによる規程検索は27B級以下で十分に回ります。最先端の推論力や長い自律的な作業を期待すると、クラウドの最上位モデルとの差を感じます。「データを出せない業務」に絞って始めると評価が安定します。
ローカルLLMが動くPCのおすすめは?
個人ならApple Silicon 32GB以上のMacか、VRAM 12〜16GBのNVIDIA GPU搭載PCです。社内共用なら24GB級GPU 1枚のLinuxサーバーにOllamaを載せる構成が、性能・運用・価格の釣り合いが取れています。CPUのみの構成は3〜4Bモデルの検証用と割り切ってください。
日本語に強いモデルは?
執筆時点ではQwen3.5 / 3.8系とGemma 4系の9〜12B以上が、追加の調整なしで業務文書の日本語を安定して扱えます。日本語特化モデル(ELYZA、Sarashina、LLM-jp、Swallowなど)はHugging FaceのGGUFを取り込む形が確実で、Ollamaライブラリ上の再配布版は出所を確認してから使います。
まとめ
ローカルLLMの選定は「データを出せるか」「同時に何人が使うか」「VRAMは何GBか」の3つでほぼ決まります。メモリはファイルサイズに2〜4GBを足して見積もり、日本語用途は9〜12B級から、社内共用は24GB級GPU 1枚とOllamaから始めるのが失敗の少ない道筋です。ライセンスはベースと派生の両方を原文で確認してモデル台帳に残し、更新は評価セットで合格したものだけをサイズ付きタグで切り替えてください。
次に読む
- Ollamaで始めるローカルLLM入門:インストール、量子化タグ、APIの使い方
- Open WebUIで社内ChatGPT環境を作る:選んだモデルを複数人で安全に使う構成
- pgvectorとPythonで作る社内文書RAG:埋め込みモデルの次元数が設計に効く場面