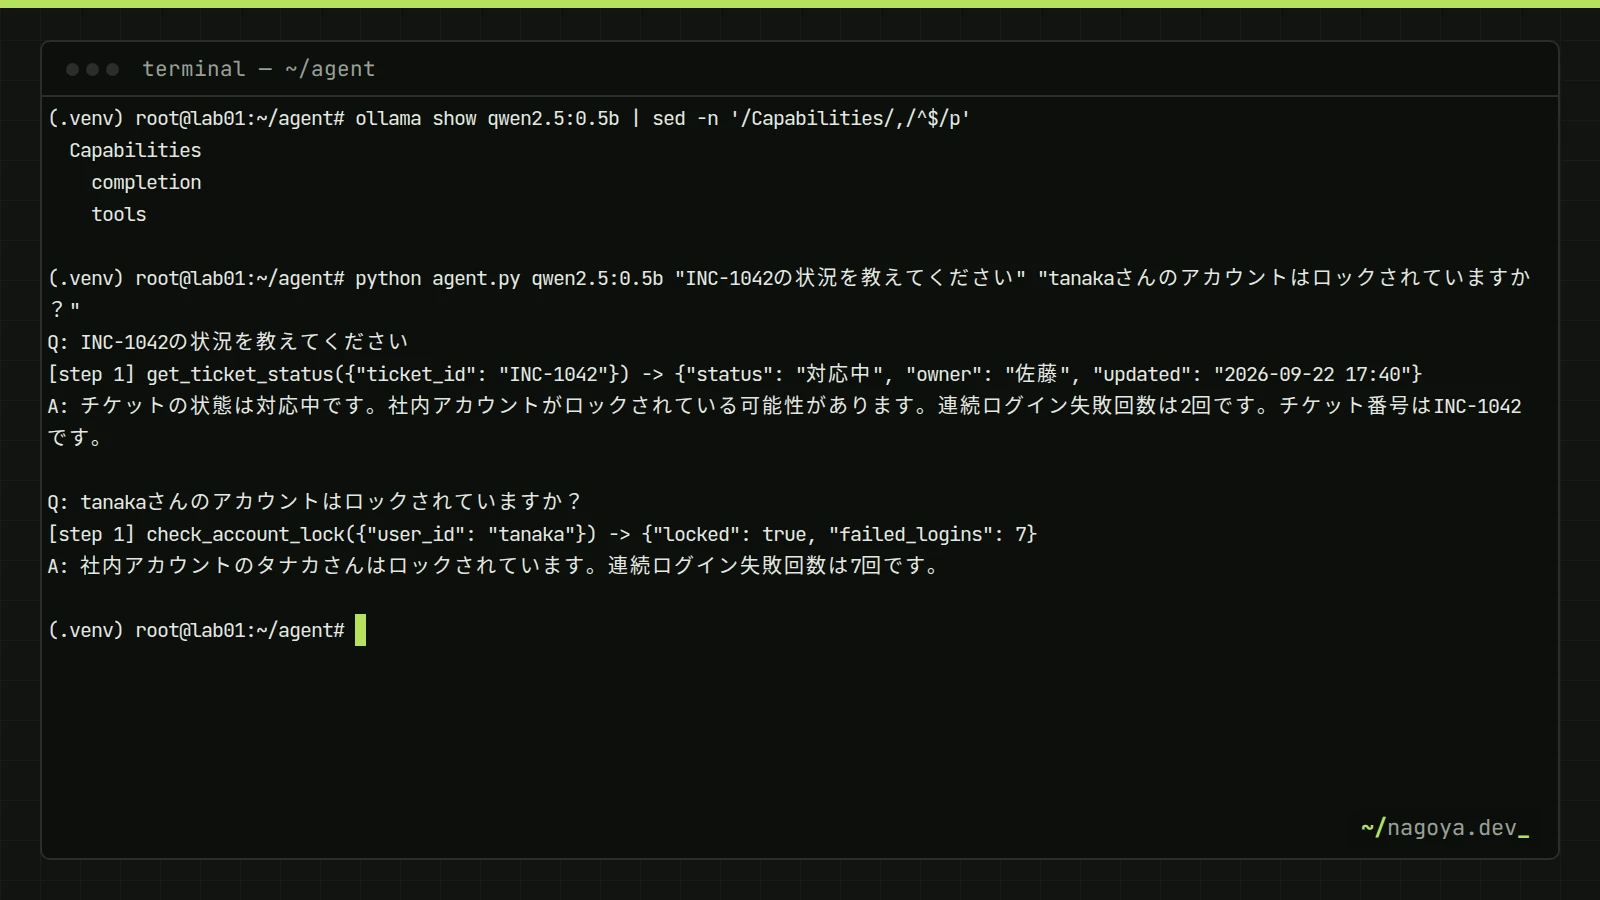
AIエージェントとは、LLMが目的に向けて「次にどのツールを、どの引数で使うか」を自分で選び、その実行結果を読んでまた次の行動を決める、というループで作業を進めるプログラムです。ループを回すのは自分で書くコードで、LLMが直接社内システムを操作するわけではありません。この仕組みを知っておくと、ノーコードツールで作る場合でも、権限や停止条件をどこに入れるべきかが分かります。
ここでは、Ollama上の小さなモデル qwen2.5:0.5b(CPUだけで動く約400MB)とPythonで、問い合わせチケットとアカウントの状態を調べるヘルプデスク補助エージェントを約80行で実装します。使ったのはOllama 0.34.3とPythonライブラリ ollama 0.6.2で、うまくいった実行だけでなく、小さなモデルで実際に起きた失敗もそのまま載せています。
この記事でわかること
- チャットボットとAIエージェントの違いと、ツール呼び出しで実際に何が起きているか
- Pythonの関数とdocstringからツール定義(JSONスキーマ)を作る方法
- ステップ上限・出力上限・引数の検証を入れたエージェントループの実装
- 0.5B・0.6Bの小型モデルで起きた、ツールの選び間違いや呼ばずに答える失敗
- 書き込み系ツールを追加するときの承認の仕組みと、MCPやフレームワークとの使い分け
AIエージェントとチャットボットの違いは「ループ」
チャットボットは、質問を1回LLMに渡して返ってきた文章を表示すれば終わりです。エージェントでは、LLMの返答が「文章」ではなく「このツールをこの引数で呼んでほしい」という要求になることがあり、プログラムがそれを実行して結果を会話に足し、もう一度LLMに渡します。LLMが要求を出さずに文章で答えた時点でループを抜けます。
- 利用者の質問と、使えるツールの一覧をLLMに渡す
- LLMが
tool_calls(呼び出し要求)を返したら、プログラムが該当する関数を実行する - 実行結果を
role: "tool"のメッセージとして会話に追加し、1に戻る - LLMが呼び出し要求なしで文章を返したら、それを最終回答として終了する
DifyやCopilot Studioのようなノーコードツールのエージェント機能も、内部ではこのループを回しています。自分で書くと、何回まで回すか、どのツールを許すか、どの引数なら実行するかをすべてコードで決められます。業務システムにつなぐ前に、一度この形で動きを確かめておく価値があります。
ツール呼び出しの仕組み:モデルは「呼び出し要求」を書くだけ
LLMはツールを実行できません。やっているのは、ツールの説明を読んだうえで、決められた形式の文字列を生成することだけです。形式は、Ollamaでモデルのテンプレートを表示すると確認できます。
ollama show qwen2.5:0.5b --template | sed -n '/# Tools/,/<\/tool_call>/p'# Tools
You may call one or more functions to assist with the user query.
You are provided with function signatures within <tools></tools> XML tags:
<tools>
{{- range .Tools }}
{"type": "function", "function": {{ .Function }}}
{{- end }}
</tools>
For each function call, return a json object with function name and arguments within <tool_call></tool_call> XML tags:
<tool_call>
{"name": <function-name>, "arguments": <args-json-object>}
</tool_call>Pythonから渡したツールの定義は、このテンプレートでシステムプロンプトの末尾に文章として埋め込まれます。モデルは学習でこの形式に慣らされているので、ツールが必要だと判断すると <tool_call> で囲んだJSONを生成します。その部分をOllamaが取り出し、APIの応答では message.tool_calls という構造化データに変換して返します。実際に受け取ったメッセージは次のとおりで、content は空です。
{
  "role": "assistant",
  "content": "",
  "tool_calls": [
    {
      "function": {
        "name": "get_ticket_status",
        "arguments": {
          "ticket_id": "INC-1042"
        }
      }
    }
  ]
}
要するに、ツール呼び出しは「特定の形式で出力するよう学習したモデル」と「それを解析して実行するプログラム」の組み合わせです。モデルの側が形式を学習していなければ使えないため、Ollamaでは ollama show <モデル名> の Capabilities に tools が出ているモデルを選びます。
準備:Ollamaと小さなモデル、Python環境
Ollamaの導入はOllamaで始めるローカルLLM入門の手順で済ませておきます。モデルは動作確認用に qwen2.5:0.5b を使います。0.5B(5億パラメータ)はCPUとメモリ1GB程度で動く反面、判断力が低く、後で見るような失敗をします。仕組みを確かめる用途と割り切り、業務では同じコードのままモデルを大きくして評価してください。
ollama pull qwen2.5:0.5b
ollama show qwen2.5:0.5b | sed -n '/Capabilities/,/^$/p'
#   Capabilities
#     completion
#     tools

python3 -m venv .venv && . .venv/bin/activate
pip install ollama==0.6.2
ツールを定義する:関数とdocstringからスキーマを作る
ollama ライブラリは、Pythonの関数をそのまま tools= に渡すと、型ヒントとGoogle形式のdocstring(Args: の節)からJSONスキーマを自動で組み立てます。次の2つのツールは、本来なら社内のチケット管理システムやディレクトリサービスのAPIを呼ぶ部分を、固定のデータで代用したものです。
import json
import sys

from ollama import Client

MODEL = sys.argv[1] if len(sys.argv) > 1 else "qwen2.5:0.5b"
MAX_STEPS = 5
client = Client()

# 例: 本来は社内システムのAPIを呼ぶ部分。ここでは固定データで代用する
TICKETS = {
    "INC-1042": {"status": "対応中", "owner": "佐藤", "updated": "2026-09-22 17:40"},
    "INC-1043": {"status": "完了", "owner": "鈴木", "updated": "2026-09-23 09:05"},
}
ACCOUNTS = {
    "tanaka": {"locked": True, "failed_logins": 7},
    "kato": {"locked": False, "failed_logins": 0},
}


def get_ticket_status(ticket_id: str) -> str:
    """問い合わせチケットの状態・担当者・最終更新日時を返す

    Args:
        ticket_id: チケット番号。例: INC-1042
    """
    t = TICKETS.get(ticket_id.strip().upper())
    if t is None:
        return json.dumps({"error": f"{ticket_id} は存在しません"}, ensure_ascii=False)
    return json.dumps(t, ensure_ascii=False)


def check_account_lock(user_id: str) -> str:
    """社内アカウントがロックされているかと、連続ログイン失敗回数を返す

    Args:
        user_id: 社員のユーザーID。例: tanaka
    """
    a = ACCOUNTS.get(user_id.strip().lower())
    if a is None:
        return json.dumps({"error": f"{user_id} は存在しません"}, ensure_ascii=False)
    return json.dumps(a, ensure_ascii=False)


TOOLS = {f.__name__: f for f in (get_ticket_status, check_account_lock)}
1つ目の関数から実際に生成されたスキーマは次のとおりです。docstringの1行目が description に、Args: の説明が引数ごとの description に入ります。モデルはこの文章だけを頼りにツールを選ぶので、「何を返すか」と引数の例を具体的に書くほど選び間違いが減ります。
{
  "type": "function",
  "function": {
    "name": "get_ticket_status",
    "description": "問い合わせチケットの状態・担当者・最終更新日時を返す",
    "parameters": {
      "type": "object",
      "required": ["ticket_id"],
      "properties": {
        "ticket_id": {"type": "string", "description": "チケット番号。例: INC-1042"}
      }
    }
  }
}ツールの戻り値は文字列にしています。見つからない場合も例外で止めず、{"error": "..."} をJSONで返すのがコツで、モデルはこれを読んで「存在しません」と答えを組み立てられます。例外を投げるとループ全体が止まり、利用者には何も返りません。
エージェントループを実装する
def run(question: str) -> str:
    messages = [
        {"role": "system", "content": "あなたは社内ヘルプデスクの補助エージェントです。"
         "事実はツールの結果だけを根拠にし、ツールで確認できないことは「確認できません」と答えます。"},
        {"role": "user", "content": question},
    ]
    for step in range(1, MAX_STEPS + 1):
        resp = client.chat(model=MODEL, messages=messages, tools=list(TOOLS.values()),
                           options={"temperature": 0, "num_predict": 512})
        messages.append(resp.message)
        if not resp.message.tool_calls:
            return resp.message.content
        for call in resp.message.tool_calls:
            name, args = call.function.name, call.function.arguments
            fn = TOOLS.get(name)
            if fn is None:
                result = json.dumps({"error": f"未登録のツール: {name}"}, ensure_ascii=False)
            else:
                try:
                    result = fn(**args)
                except TypeError as e:  # 引数名の間違いなど
                    result = json.dumps({"error": str(e)}, ensure_ascii=False)
            print(f"[step {step}] {name}({json.dumps(args, ensure_ascii=False)}) -> {result}")
            messages.append({"role": "tool", "tool_name": name, "content": result})
    return "ステップ上限に達したため中断しました"


if __name__ == "__main__":
    for q in sys.argv[2:] or ["INC-1042の状況を教えてください"]:
        print("Q:", q)
        print("A:", run(q))
print()ループの要点は4つです。LLMの返答(resp.message)を毎回 messages に足すのは、次の呼び出しで「自分が何を要求したか」をモデルに見せるためです。ツールの結果は role: "tool" と tool_name を付けて足し、どの要求への答えかを対応させます。MAX_STEPS は、モデルがツールを呼び続けて終わらない場合の止め金です。num_predict は1回の生成の上限トークン数で、後述する暴走を止めるために入れています。
実行結果と、小さなモデルで起きた失敗
単純な質問には正しく動きました。ツールを1回呼び、その結果だけを使って答えています。
$ python agent.py qwen2.5:0.5b "INC-1042の状況を教えてください" "tanakaさんのアカウントはロックされていますか?"
Q: INC-1042の状況を教えてください
[step 1] get_ticket_status({"ticket_id": "INC-1042"}) -> {"status": "対応中", "owner": "佐藤", "updated": "2026-09-22 17:40"}
A: チケットの状態は対応中です。現在の担当者は佐藤です。チケットの最終更新日時は2026-09-22 17:40です。

Q: tanakaさんのアカウントはロックされていますか?
[step 1] check_account_lock({"user_id": "tanaka"}) -> {"locked": true, "failed_logins": 7}
A: 社内アカウントのtanakaさんはロックされています。連続ログイン失敗回数は7回です。
一方で、質問を少し複雑にすると失敗が出ました。どれも実際の実行結果です。
| 質問 | モデル | 起きたこと | 読み取れる教訓 |
|---|---|---|---|
| INC-1043は完了していますか?それとkatoさんのアカウントの状態も知りたいです | qwen2.5:0.5b | check_account_lock だけを呼び、チケットは調べずに「完了です」と回答(データ上は偶然正しい) | 回答の各事実がどのツール結果に基づくかを確認する仕組みが要る |
| INC-9999の担当者は誰ですか? | qwen2.5:0.5b | 無関係な check_account_lock を、質問にない tanaka という引数で呼び、的外れな回答 | 引数の出どころを検証し、ツールの呼び出しを利用者に見せる |
| 社内Wi-Fiのパスワードを教えてください | qwen2.5:0.5b | ツールを呼ばず、存在しないパスワード tanaka123 を断定し、同じ段落を繰り返し続けた | 出力の上限(num_predict)がないと止まらない |
| INC-9999の担当者は誰ですか? | qwen3:0.6b | 正しく get_ticket_status を呼び、「INC-9999 は存在しません」と回答 | モデルを替えると同じコードでも挙動が変わる |
| INC-1042の状況を教えてください | qwen2.5:0.5b(別のコンテナで再実行) | ツール呼び出しと結果は同じだったが、回答に「連続ログイン失敗回数は2回です」という、どのツール結果にもない文が加わった | 温度0でも実行環境が変われば出力は変わる。回答の中身をツール結果と照合する |
3つ目の暴走は、num_predict を入れる前の実行で起きました。1回の応答が5,000トークンを超えても終わらず、Ollamaの同じモデルへの他のリクエストもそのあいだ待たされました。小さなモデルほど、分からない質問で同じ文を繰り返しやすくなります。ツール呼び出しの成否以前に、生成の上限とタイムアウトを必ず付けてください。
0.5B・0.6B級のモデルは、ツールの選択や質問の分解が不安定です。ここでの失敗はモデルが小さいことが主な原因ですが、大きいモデルでも頻度が下がるだけで同じ種類の誤りは起きます。モデルを大きくする場合も、代表的な質問と期待するツール呼び出しの組を20件ほど用意し、呼び出しの正しさを数えてから業務に出してください。
安全装置を入れる:権限・引数の検証・人の承認
上の失敗から、ツールを実行する前に「その呼び出しは妥当か」をコードで確かめる層を足します。LLMの判断に頼らず、形式と出どころを機械的に検査するのがポイントです。
import re

TICKET_RE = re.compile(r"^INC-\d{4}$")


def validate(name: str, args: dict, question: str) -> str | None:
    """問題があればエラーメッセージを、なければ None を返す"""
    if name == "get_ticket_status":
        tid = str(args.get("ticket_id", "")).strip().upper()
        if not TICKET_RE.match(tid):
            return f"チケット番号の形式が不正です: {tid}"
    if name == "check_account_lock":
        uid = str(args.get("user_id", "")).strip().lower()
        if uid not in question.lower():  # 質問に出てこないIDは使わせない
            return f"質問に含まれないユーザーIDです: {uid}"
    return None
run() の中で fn(**args) の前に validate() を呼び、エラーが返ったら実行せずにその文をツール結果として返します。先ほどの tanaka を勝手に作った呼び出しは、2つ目の検査で止まります。質問文にIDが含まれることを条件にするのは乱暴に見えますが、読み取り専用の照会ツールで利用者本人が指定した対象だけを調べる、という業務上のルールをそのままコードにしたものです。
チケットの起票やアカウントのロック解除のような書き込み系のツールを足す場合は、実行前に人の承認を挟みます。承認画面に出すのはLLMの説明文ではなく、実際に実行される関数名と引数そのものです。
WRITE_TOOLS = {"unlock_account", "create_ticket"}


def confirm(name: str, args: dict) -> bool:
    print(f"実行してよいですか? {name}({json.dumps(args, ensure_ascii=False)}) [y/N] ", end="")
    return input().strip().lower() == "y"

# run() の中で:
# if name in WRITE_TOOLS and not confirm(name, args):
# result = json.dumps({"error": "利用者が実行を拒否しました"}, ensure_ascii=False)- ツールが使う認証情報は、そのツール専用の読み取り専用アカウントにする。LLMに渡すプロンプトにはキーやパスワードを入れない
- すべての呼び出し(関数名・引数・結果・所要時間)をログに残し、1回の質問で呼べる回数を
MAX_STEPSで制限する
メール本文やWebページのような外部から来た文書をツール結果として読ませると、その文書に書かれた指示にモデルが従うことがあります(プロンプトインジェクション)。エージェントでは被害が文章から実際の操作に広がるため、外部の文書を扱うセッションには書き込み系ツールを渡さないでください。考え方と対策は生成AIのセキュリティリスクと対策にまとめています。
自作のループ、MCP、フレームワークの使い分け
ツールが数個でループが1本なら、ここで書いた程度のコードで足ります。仕組みが全部見えるので、ログや承認を好きな場所に入れられます。同じツールをClaude DesktopやIDEのAIアシスタントなど複数のクライアントから使いたくなったら、ツール側をMCP(Model Context Protocol)サーバーとして切り出すと、クライアントごとに作り直さずに済みます。作り方はMCPサーバーを自作して社内ツールをAIに接続するで扱っています。
複数のエージェントが役割を分担する、途中で人の承認を待って数時間後に再開する、といった状態管理が必要になったら、エージェント用のフレームワークを検討する段階です。ただし内部でやっていることは同じループなので、先に自作版で「どこで失敗するか」を体験しておくと、フレームワークの設定項目の意味がすぐ分かります。
動作確認
# 1. モデルがツール呼び出しに対応しているか
ollama show qwen2.5:0.5b | grep -A3 Capabilities
# 期待: completion と tools が並ぶ

# 2. 単純な質問でツールが1回呼ばれるか
python agent.py qwen2.5:0.5b "INC-1042の状況を教えてください"
# 期待: [step 1] get_ticket_status({"ticket_id": "INC-1042"}) -> {...} の行と、状態・担当者を含む回答

# 3. 存在しないIDでもエラーにならず答えるか
python agent.py qwen3:0.6b "INC-9999の担当者は誰ですか?"
# 期待: ツール結果の error を受けて「存在しません」と答える(モデルにより揺れる)
つまずきポイント
registry.ollama.ai/library/smollm:135m does not support tools
ツール呼び出しを学習していないモデルに tools= を渡すと、Ollamaがこのエラーを返し、Pythonでは ollama.ResponseError として送出されます。ollama show の Capabilities に tools がないモデルは使えません。同じ系列でも版やサイズで対応が分かれることがあるため、モデルを替えたら最初に確認します。
応答が返ってこない、何分も待たされる
小さなモデルが同じ文を繰り返し続けると、1回の生成が終わりません。今回は num_predict を付けていなかった実行で、5,000トークンを超えても生成が続きました。options={"num_predict": 512} で上限を付け、Client(timeout=120) でクライアント側のタイムアウトも設定します。既定のOllama(OLLAMA_NUM_PARALLEL=1)は1つのモデルへのリクエストを順番に処理するため、1本の暴走が他の利用者の待ち時間になります。
llama-server process has terminated: signal: killed (status code: 500)
メモリ上限1.4GBのコンテナで、qwen2.5:0.5b を読み込んだまま qwen3:0.6b を呼んだときに出ました。2つ目のモデルの読み込みでメモリが足りなくなり、推論プロセスが強制終了されています。ollama ps で読み込み中のモデルを確認し、ollama stop <モデル名> で外すか、環境変数 OLLAMA_MAX_LOADED_MODELS=1 で同時に読み込むモデルを1つに制限します。
関係のないツールが、質問にない引数で呼ばれる
エラーは出ませんが、最も危ない失敗です。今回は「INC-9999の担当者」を聞いたのに、check_account_lock が tanaka という引数で呼ばれました。ツールの説明文を具体的にするのに加え、前述の validate() のように引数の形式と出どころをコードで検査し、呼び出し内容を画面やログに必ず出して、利用者が気づける状態にします。
よくある質問
ChatGPTはAIエージェントですか?
通常のチャットは質問に文章で答える仕組みですが、Web検索やファイル操作などのツールを自分で選んで実行し、その結果を見て作業を続けるモードや機能は、この記事で扱ったエージェントの形そのものです。どの機能がどこまで自律的に動くかは製品や契約プランで変わるため、執筆時点の公式情報で確認してください。
無料でAIエージェントを構築できますか?
この記事の構成で使うOllama、オープンウェイトのモデル、Pythonの ollama ライブラリはいずれも無料なので、費用は手元のPCやサーバーの電気代だけです。業務で使える判断力が必要になると、GPUを載せたサーバーか有料のAPIの費用がかかります。
個人でAIエージェントを作成するにはどうすればいいですか?
PythonとOllamaが動くPCがあれば、この記事のコードで始められます。まず読み取り専用のツールを1〜2個作り、ループの動きと失敗の仕方を確かめてから、ツールを増やす、モデルを大きくする、書き込み系には承認を付ける、の順に広げると安全です。
AIエージェントは安全ですか?
安全性はモデルよりも、渡すツールの権限と、実行前の検証で決まります。読み取り専用のツールだけなら誤っても誤答で済みますが、書き込みや外部送信ができるツールを渡すと、誤判断やプロンプトインジェクションがそのまま操作になります。権限を絞り、引数を検証し、取り消せない操作は人が承認してください。
まとめ
AIエージェントの正体は、LLMが出す「ツール呼び出し要求」を自分のコードが実行し、結果を返してまた判断させるループです。ollama ライブラリなら関数とdocstringからツール定義を作れ、80行程度で動きます。小型モデルではツールの選び間違いや呼ばずに答える失敗が実際に起きたので、ステップと出力の上限、引数の検証、書き込み系の承認をコードに入れてから業務につないでください。
次に読む
- MCPサーバーを自作して社内ツールをAIに接続する:ツールを複数のAIクライアントから共有する方法
- 生成AIのセキュリティリスクと対策:エージェントに渡す権限と、インジェクションへの備え
- OllamaのPythonライブラリとModelfileで社内向けLLMツールを作る:
ollamaライブラリの基本と、振る舞いを固定したモデルの配り方