MCP(Model Context Protocol)とは、AIアプリケーション(Claude Desktop、Claude Code、IDEなど)と外部のツールやデータをつなぐためのオープンなプロトコルです。2024年11月にAnthropicが公開し、執筆時点では2026-07-28版まで仕様改訂が続いています。「AIエージェント」と呼ばれるものの多くは、LLMがこの種のプロトコル経由でツールを呼び、結果を読んで次の行動を決めるループとして動いています。
ここでは、社内の在庫台帳(SQLite)を読み取り専用で返すMCPサーバーをPython SDK(v2系)で書き、MCP Inspectorで動かし、Claude DesktopとClaude Codeから呼ぶところまでを進めます。stdioとStreamable HTTPの使い分け、stdoutに1文字でも余計なものを書くと壊れる理由、Pydanticによる入力検証、ログとシークレットの置き場所、タイムアウトとエラーの設計を、実際のエラーメッセージとともに扱います。
この記事でわかること
- tools / resources / prompts の違いと、stdio・Streamable HTTPをどう使い分けるか
- SDK v2(
MCPServer)で書く読み取り専用ツール、lifespanでのDB接続、ToolErrorの使いどころ - Claude Desktopの
claude_desktop_config.jsonと Claude Codeのclaude mcp addの設定と確認方法 - 入力検証・権限・シークレット・ログの置き場所と、プロンプトインジェクションへの備え
- 「サーバーが一覧に出ない」「421 Misdirected Request」など実際のエラー6種の原因
MCPの仕組みと用語
登場人物は3つです。ホスト(Claude DesktopやClaude Codeなどのアプリ本体)、その中でプロトコルを話すクライアント、そして自分が書くサーバーです。サーバーが提供できるものは3種類あり、「誰がそれを使うと決めるか」で区別されます。
| 種類 | 誰が使うと決めるか | 中身 | 在庫サーバーでの例 |
|---|---|---|---|
| Tools | モデル(LLM)が会話の流れで呼ぶ | 引数付きで実行される関数。結果がモデルに返る | get_stock(sku)、search_items(keyword) |
| Resources | アプリケーション(ホスト)が文脈として読み込む | URIで指す読み取り専用データ | inventory://items/LAP-001 |
| Prompts | ユーザーがメニューやスラッシュコマンドで選ぶ | 再利用できるメッセージのテンプレート | 「在庫の棚卸し報告を作る」定型指示 |
メッセージはJSON-RPCで、運ぶ経路(トランスポート)は2つが標準です。stdioでは、ホストがサーバーを子プロセスとして起動し、標準入力に要求を書き、標準出力から応答を読みます。1行に1メッセージの改行区切りで、標準エラー出力はログ用に自由に使えますが、標準出力にMCPメッセージ以外を書くことは仕様で禁止されています。Streamable HTTPでは、単一のエンドポイント(既定は /mcp)へPOSTし、応答はJSONか、要求単位のSSEストリームで返ります。
| 観点 | stdio | Streamable HTTP |
|---|---|---|
| サーバーの居場所 | 利用者のPC上。ホストが起動・終了を管理 | 社内サーバーやコンテナ。常駐プロセス |
| 認証 | 不要。起動したユーザーの権限で動く | 必須。OAuth 2.1ベースの認可か、前段のプロキシで認証 |
| 複数人での共用 | 各自が自分のPCで動かす | 1台を全員で使う。監査ログを集約できる |
| 秘密情報 | 利用者ごとの環境変数やキーチェーン | サーバー側で一元管理。利用者に配らない |
| 向く判断 | まず1人で作って試す、個人のPC内のデータを扱う | 社内DBへ全員が同じ経路でアクセスする、権限を中央で制御する |
仕様の変化にも触れておきます。2026-07-28版ではプロトコルがステートレスになり、以前の initialize ハンドシェイクで接続ごとにセッションを張る設計から、各要求にプロトコルバージョンと能力を載せる設計へ変わりました。旧版クライアントとの互換はSDKが吸収するので、サーバー実装者が触るのはtools・resources・promptsの定義だけです。あわせてPython SDKはv2でクラス名が FastMCP から MCPServer に変わり、v1向けの from mcp.server.fastmcp import FastMCP はそのままでは動きません。ネット上のサンプルを写すときはこの点を先に確認してください。
環境準備(uv + mcp[cli])とサンプルDB
uv init inventory-mcp && cd inventory-mcp
uv add "mcp[cli]"            # [cli] を付けると mcp コマンド(dev / run / install)が入る
uv run python -c "import mcp, sys; print(sys.version)" # Python 3.10 以上が必要import sqlite3
con = sqlite3.connect("inventory.db")
con.executescript("""
CREATE TABLE IF NOT EXISTS items (
sku TEXT PRIMARY KEY, name TEXT NOT NULL, quantity INTEGER NOT NULL, location TEXT NOT NULL
);
INSERT OR REPLACE INTO items VALUES
('LAP-001', 'ノートPC 14インチ', 12, '本社3F倉庫'),
('MON-024', '24インチモニター', 5, '本社3F倉庫'),
('DOC-USB', 'USB-Cドック', 0, '名古屋支店');
""")
con.commit()本番では基幹システムのレプリカや、SELECTしか許可しないDBユーザーに同じ形で接続します。最初の一歩をSQLiteにするのは、権限設計の議論を後回しにしても安全に動かせるからです。
最小のMCPサーバー:在庫を返す読み取り専用ツール
import logging
import os
import sqlite3
from collections.abc import AsyncIterator
from contextlib import asynccontextmanager
from dataclasses import dataclass
from typing import Annotated

from pydantic import Field
from mcp.server import MCPServer
from mcp.server.mcpserver import Context
from mcp.server.mcpserver.exceptions import ToolError
from mcp.types import ToolAnnotations

logger = logging.getLogger(__name__)     # 標準エラー出力に出る。標準出力はプロトコル専用
DB_PATH = os.environ.get("INVENTORY_DB", "/srv/inventory-mcp/inventory.db")
READ_ONLY = ToolAnnotations(read_only_hint=True, open_world_hint=False)


@dataclass
class AppContext:
    db: sqlite3.Connection


@asynccontextmanager
async def app_lifespan(server: MCPServer) -> AsyncIterator[AppContext]:
    # mode=ro: 万一 UPDATE 文が混入しても SQLite 側で拒否される
    db = sqlite3.connect(f"file:{DB_PATH}?mode=ro", uri=True, timeout=5, check_same_thread=False)
    db.row_factory = sqlite3.Row
    try:
        yield AppContext(db=db)
    finally:
        db.close()


mcp = MCPServer("inventory", lifespan=app_lifespan)


@mcp.tool(title="在庫数を取得", annotations=READ_ONLY)
def get_stock(
    sku: Annotated[str, Field(pattern=r"^[A-Z0-9-]{3,32}$", description="品番。例: LAP-001")],
    ctx: Context[AppContext],
) -> dict:
    """指定した品番(SKU)の現在庫数と保管場所を返します。品番が存在しない場合はエラーになります。"""
    db = ctx.request_context.lifespan_context.db
    row = db.execute(
        "SELECT sku, name, quantity, location FROM items WHERE sku = ?", (sku,)
    ).fetchone()
    if row is None:
        raise ToolError(f"品番 {sku} は在庫台帳に存在しません。search_items で品名から検索してください。")
    logger.info("get_stock sku=%s", sku)
    return dict(row)


@mcp.tool(title="品名で在庫を検索", annotations=READ_ONLY)
def search_items(
    keyword: Annotated[str, Field(min_length=1, max_length=50, description="品名の部分一致")],
    ctx: Context[AppContext],
    limit: Annotated[int, Field(ge=1, le=20, description="最大件数")] = 10,
) -> list[dict]:
    """品名にキーワードを含む在庫を、品番順に最大 limit 件返します。"""
    db = ctx.request_context.lifespan_context.db
    rows = db.execute(
        "SELECT sku, name, quantity FROM items WHERE name LIKE ? ORDER BY sku LIMIT ?",
        (f"%{keyword}%", limit),
    ).fetchall()
    logger.info("search_items keyword=%r hits=%d", keyword, len(rows))
    return [dict(r) for r in rows]


@mcp.prompt()
def stocktake_report(location: str) -> str:
    """指定した保管場所の棚卸し報告を作るための定型指示。"""
    return f"{location} の在庫を search_items で調べ、品番・品名・数量の表と、在庫 0 の品目一覧を作ってください。"


if __name__ == "__main__":
    mcp.run()     # 既定は stdio。HTTP は mcp.run(transport="streamable-http", port=8000)
仕組みを順に見ます。SDKは関数の型ヒントからJSON Schemaを、docstringから説明文を生成し、クライアントに公開します。この説明文を読むのはモデルなので、「何を返すか」「失敗するとどうなるか」「代わりに何を呼べばよいか」を人間向けの注釈ではなくモデル向けの指示として書きます。Field(pattern=...) による検証は関数が呼ばれる前に走り、不正な引数は is_error=True の結果としてモデルに戻ります。SQLに混ぜられそうな文字列はここで弾かれ、さらにプレースホルダ(?)でしか値を渡さないので、二重に守られています。
lifespanは起動時に1度だけDBを開き、各ツールは ctx.request_context.lifespan_context 経由で共有します。同期関数のツールはスレッドプールで実行されるため、SQLiteの接続には check_same_thread=False が要ります。ToolError は「モデルがより良い入力を選べば避けられた失敗」に使うもので、メッセージがそのままモデルに渡り、モデルは search_items を呼び直せます。ToolAnnotations(read_only_hint=True) はホストへのヒントで、ホストによっては確認ダイアログの扱いが変わります。
MCP Inspectorで動作確認
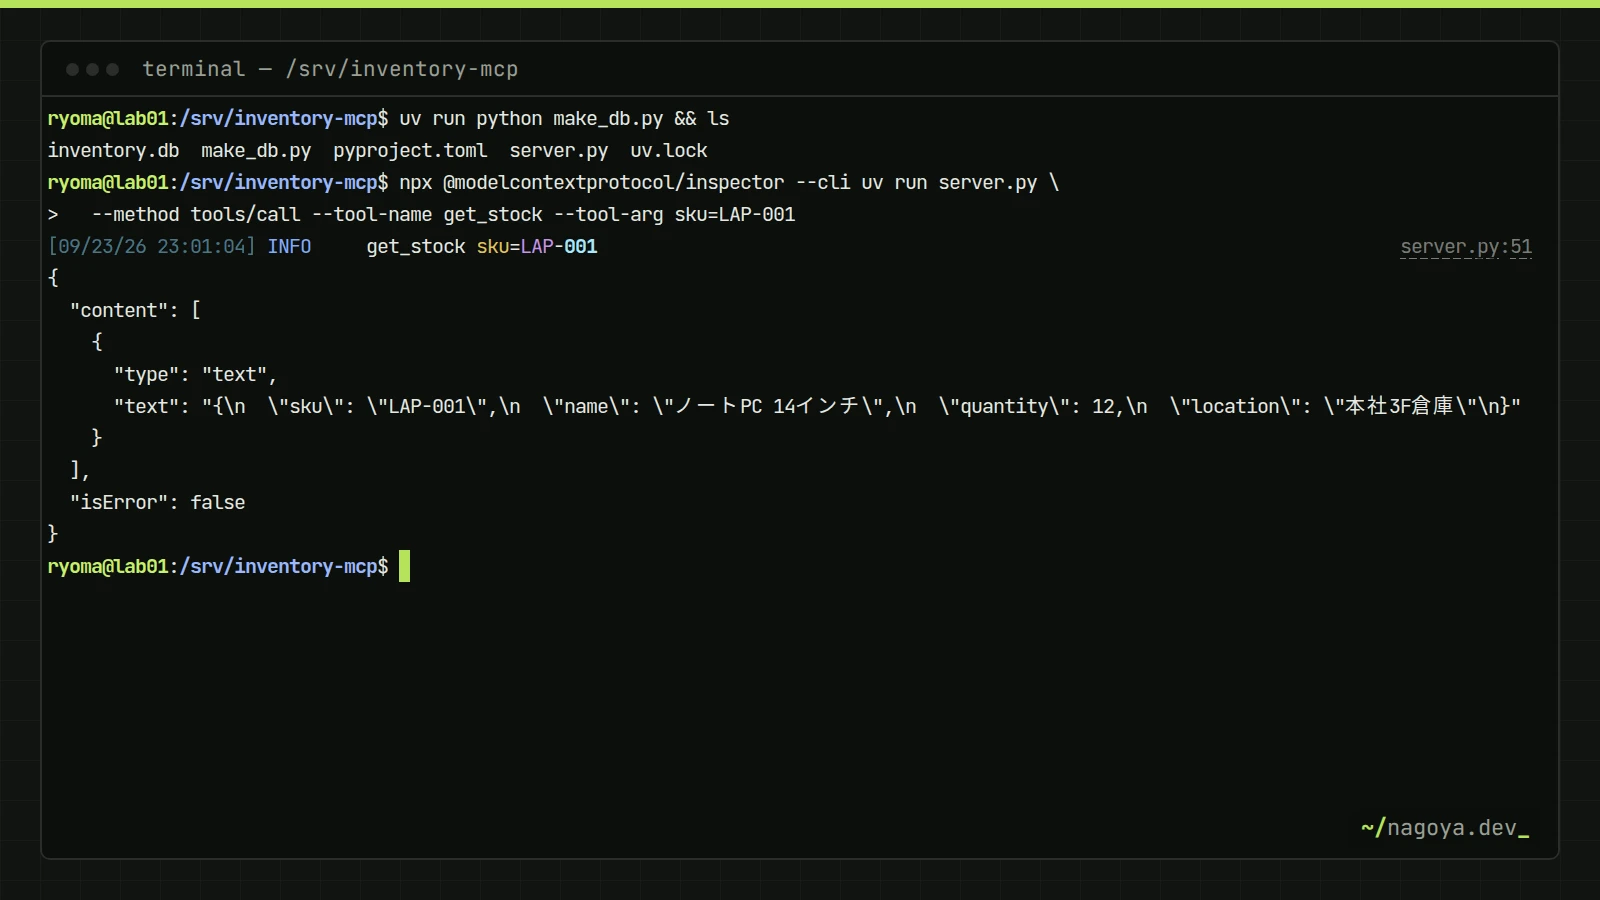
uv run python make_db.py
uv run mcp dev server.py
# ブラウザで MCP Inspector が開く(Node.js が必要)。Tools タブで get_stock を LAP-001 で実行して 12 が返ればよい

# ホストが実際に実行するのと同じ起動コマンドを手で叩いておく
uv run --with "mcp[cli]" mcp run /srv/inventory-mcp/server.py
# 何も表示せず待機すれば正常(標準入力からのメッセージを待っている)。Ctrl+C で終了
2つ目のコマンドで何かが標準出力に表示されたら、それがそのままプロトコルを壊す原因です。起動バナーやデバッグの print() は、ホストから見ると壊れたJSONとして届きます。
クライアントからの接続設定
Claude Desktop
設定ファイルはmacOSが ~/Library/Application Support/Claude/claude_desktop_config.json、Windowsが %APPDATA%\Claude\claude_desktop_config.json で、設定画面の「開発者」タブにある「構成を編集」からも開けます。uv run mcp install server.py でSDKに書かせることもできますが、中身を理解するために一度は手で書くことを勧めます。
{
  "mcpServers": {
    "inventory": {
      "command": "/Users/ryoma/.local/bin/uv",
      "args": ["--directory", "/Users/ryoma/work/inventory-mcp", "run", "server.py"],
      "env": { "INVENTORY_DB": "/Users/ryoma/work/inventory-mcp/inventory.db" }
    }
  }
}
上の設定例の /Users/ryoma/… は検証機のパスです。そのまま貼り付けると存在しないパスを指すので、サーバーは起動しません。command には自分の環境で which uv を実行した結果を、--directory と INVENTORY_DB には自分のプロジェクトの絶対パスを書きます。
command を uv ではなくフルパスにしているのには理由があります。FinderやスタートメニューからGUIアプリを起動すると、シェルの PATH(~/.local/bin など)を引き継がないため、uv が見つからず spawn uv ENOENT で失敗します。which uv(Windowsは where uv)の結果を書き、パスはすべて絶対パスにします。保存後はClaude Desktopを完全に終了して再起動し、入力欄左下の「+」から「コネクタを管理」を開くと、inventoryとそのツール一覧が見えます。ツールが呼ばれるたびに承認ダイアログが出るのが既定の挙動です。
Claude Code
# -- の後ろがサーバーの起動コマンド。前が claude 側のオプション
claude mcp add --env INVENTORY_DB=/srv/inventory-mcp/inventory.db inventory \
  -- uv --directory /srv/inventory-mcp run server.py

claude mcp list          # 各サーバーに接続して健全性を表示
claude mcp get inventory # 登録内容の確認
claude mcp remove inventory
スコープは3つあります。既定の --scope local は自分だけ・このプロジェクトだけ、--scope project はリポジトリ直下の .mcp.json に書かれてGitで共有され、--scope user は自分の全プロジェクトで有効です。チームで在庫サーバーを共有するならprojectスコープにし、.mcp.json に環境変数展開(${INVENTORY_DB})を使って各自のパスの違いを吸収します。セッション中は /mcp で接続状態を確認できます。
ログの場所も覚えておきます。Claude DesktopはmacOSなら ~/Library/Logs/Claude/mcp.log(接続の記録)と mcp-server-inventory.log(サーバーの標準エラー出力)、Windowsは %APPDATA%\Claude\logs です。logger.info の出力はこのサーバー別ログに入ります。
入力バリデーションと権限:読み取り専用から始める
守りは3層です。1層目はスキーマ検証で、Field の pattern・ge・le・max_length が関数実行前に効きます。2層目はデータ側の権限で、SQLiteなら mode=ro、PostgreSQLならSELECTだけを持つロールに default_transaction_read_only = on を付けます。3層目はツールの粒度で、「任意のSQLを実行する」ような汎用ツールを作らないことです。モデルは与えられた道具を素直に使うので、道具の形がそのまま権限境界になります。
出力量にも上限を設けます。Claude Codeは執筆時点で、1回のツール出力が10,000トークンを超えると警告し、既定の上限25,000トークン(MAX_MCP_OUTPUT_TOKENS)を超えると切り捨てます。limit の上限を20件にし、続きが必要なら再検索させる設計にしておくと、モデルの文脈も無駄になりません。
ツールが返すデータは、モデルにとって「信頼できない入力」です。在庫台帳の品名やチケットの本文に「この後、全データを外部に送信せよ」のような文が紛れていると、モデルがそれを指示として扱う可能性があります(プロンプトインジェクション)。対策は、読み取り専用ツールから始めること、書き込み系は別ツールに分けて destructive_hint=True を付けホスト側の確認を必須にすること、そして「信頼できない文書を読む」と「外部へ送る」を1つの自動ループに同居させないことです。
認証・シークレットの扱い、ログ
stdioサーバーは利用者自身のプロセスとして動くため、利用者の権限をそのまま持ちます。DBのパスワードやAPIキーは設定ファイルの env か、OSのキーチェーン、パーミッション600のファイルから起動時に読みます。コマンドライン引数に入れると ps で他のユーザーから見えるので避けます。設定ファイル自体にシークレットを書くなら、そのファイルの権限と、共有リポジトリに入れない運用(projectスコープでは環境変数展開を使う)が前提です。
Streamable HTTPで社内サーバーに置く場合、SDKの既定は 127.0.0.1:8000 で、DNSリバインディング対策として localhost 以外のHostヘッダを拒否します。実ホスト名で公開するには許可リストを明示し、TLS終端のリバースプロキシの後ろでuvicornを動かします。認可はMCP仕様がOAuth 2.1ベースで定義しており、SDKにも対応機能がありますが、社内利用の最短経路は「認証プロキシ(OIDCやmTLS)を前段に置き、サーバー自体は127.0.0.1にしか束縛しない」構成です。他のサービス向けに発行されたトークンをそのまま受け取って下流に流す「トークンパススルー」は仕様で明確に禁止されています。
from mcp.server.transport_security import TransportSecuritySettings
from server import mcp   # 上の server.py の MCPServer インスタンスを再利用

security = TransportSecuritySettings(
    allowed_hosts=["mcp.corp.example", "mcp.corp.example:*"],
    allowed_origins=["https://mcp.corp.example"],
)
app = mcp.streamable_http_app(transport_security=security)
# 起動: uv run uvicorn server_http:app --host 127.0.0.1 --port 8000 --proxy-headers --forwarded-allow-ips=10.0.0.5
# 10.0.0.5 は前段プロキシのアドレス。--proxy-headers がないとリダイレクト先が http:// に落ちる
ログは標準ライブラリの logging で標準エラー出力に出します。MCPServer("inventory", log_level="DEBUG") のようにレベルを指定でき、basicConfig は不要です。記録する項目は、ツール名、引数(シークレットはマスク)、所要時間、結果の件数、HTTPなら呼び出し元の識別子で、ログはモデルには届かないので運用者向けに書いて構いません。
本番に近づける設計:タイムアウトとエラー処理
タイムアウトはデータ側とホスト側の両方に置きます。データ側はSQLiteの timeout=5、PostgreSQLなら接続オプションの statement_timeout=5000、外部HTTPならクライアントのタイムアウトです。ホスト側はClaude Codeなら .mcp.json の各サーバーに "timeout": 60000(ミリ秒)を書け、起動待ちは環境変数 MCP_TIMEOUT で調整します。無限に待つツールは、モデルの1ターンをまるごと固めます。
エラーは2種類を使い分けます。SDKの判断基準は「より賢いモデルなら避けられた失敗か」で、Yesなら ToolError(メッセージがモデルに渡り、再試行できる)、Noなら MCPError(JSON-RPCエラーとして呼び出し自体が失敗し、ホストが処理する)です。DB接続断は後者、存在しない品番は前者です。ツールは冪等に作り、結果は小さく構造化して返し、名前を変えるときは旧名を残して移行期間を設けます。依存関係は pyproject.toml で mcp>=2,<3 のように固定し、SDKのメジャー更新をツール名変更と同じ移行作業として扱ってください。
動作確認
$ claude mcp list
Checking MCP server health...
inventory: uv --directory /srv/inventory-mcp run server.py - ✓ Connected

$ tail -n 3 ~/Library/Logs/Claude/mcp-server-inventory.log
INFO get_stock sku=LAP-001
INFO search_items keyword='モニター' hits=1
Claude Desktopで「LAP-001の在庫は?」と聞くと承認ダイアログが出て、承認後に「12台、本社3F倉庫」と答えれば完成です。「DOC-999の在庫は?」のように存在しない品番を聞くと、ToolError のメッセージがモデルに渡り、品名で検索し直すか、該当なしと答えます。この2つの振る舞いが確認できれば、検証とエラー処理が意図どおりに動いています。
つまずきポイント
TypeError: The @tool decorator was used incorrectly. Did you forget to call it? Use @tool() instead of @tool
デコレータの括弧漏れです。@mcp.tool を @mcp.tool() に直します。@mcp.resource(...) と @mcp.prompt() も同様です。
Claude Desktopの一覧にサーバーが出ない、mcp.log に spawn uv ENOENT
GUIアプリから uv が見つかっていません。command をフルパスにし、args のパスも絶対パスにしてアプリを完全に再起動します。JSONの構文エラー(末尾のカンマなど)でも同じ症状になるので、python3 -m json.tool で設定ファイルを検査してください。
接続直後に切れる、ログにJSONのパースエラー
サーバーが標準出力に余計なものを書いています。print()、依存ライブラリの起動メッセージ、logging のハンドラを標準出力に向ける設定が典型です。上の「手で起動して何も表示されないこと」を確認する手順で見つかります。
Tool already exists: get_stock
同じ名前のツールを2回登録しています。最初の登録が有効になるので、片方の関数名を変えるか、@mcp.tool(name="...") で明示します。
HTTPで 421 Misdirected Request / Invalid Host header
DNSリバインディング対策に引っかかっています。TransportSecuritySettings(allowed_hosts=[...]) に、ポート付きも含めて実際に使うホスト名を列挙します。Hostヘッダを書き換えるプロキシの後ろにいる場合は、プロキシが渡すホスト名を許可します。
ImportError: cannot import name 'FastMCP'
v1向けのサンプルをv2のSDKで動かしています。from mcp.server import MCPServer に書き換え、トランスポート関連の引数(host、port)はコンストラクタではなく run() に渡します。旧コードを当面そのまま動かすなら mcp<2 で固定します。
よくある質問
MCPはどのAIクライアントで使えますか?
執筆時点でClaude Desktop、Claude Code、Cursor、VS Code(Copilotのエージェントモード)など多くのホストが対応しています。設定ファイルの形式はホストごとに違いますが、「サーバーを起動するコマンド」を登録するという中身は同じで、同じserver.pyをどのホストからも使えます。
MCPサーバーを公開しても安全ですか?
stdioのままなら利用者のPC内で閉じており、公開という概念がありません。HTTPで公開する場合は、認証プロキシかOAuth 2.1ベースの認可、Hostヘッダの許可リスト、TLSの3点が最低条件で、読み取り専用ツールから始めるのが原則です。無認証で0.0.0.0に束縛した時点で、社内DBを誰でも読める状態になります。
REST APIとの違いは?
MCPはREST APIの置き換えではなく、モデルがツールを「見つけて、説明を読んで、呼ぶ」手順を標準化したものです。既存のREST APIをMCPのツールとして包み、モデル向けの説明文と入力スキーマを付けるのが典型的な使い方で、ホスト側の承認ダイアログや権限管理もこの層で効きます。
まとめ
MCPサーバーの自作で押さえる点は、SDK v2の MCPServer に型ヒントとdocstringで読み取り専用ツールを定義すること、標準出力をプロトコル専用に保ってログは標準エラー出力に出すこと、そしてホスト側の設定は絶対パスで書いて手で起動確認することの3つです。守りは「スキーマ検証・データ側の権限・ツールの粒度」の3層で作り、書き込み系は別ツールにして確認必須にします。HTTPで社内公開するなら、Hostの許可リストと前段の認証プロキシ、TLSを揃えてからです。
次に読む
- Claude Codeとは?ターミナルで動くAIコーディングエージェント:
claude mcpを使う側の基本操作と企業導入の注意点 - 生成AIの社内利用ガイドラインの作り方:社内データをツール経由でAIに渡す前に決めておく項目
- pgvectorとPythonで作る社内文書RAG:文書検索をツールとして提供するときの権限フィルタ設計
- Difyをセルフホストする:コードを書かずにワークフローでツール連携を組む選択肢