LiteLLMとは、OpenAI・Anthropic・Ollamaなど提供元ごとに形の違うLLMのAPIを、OpenAI互換の1つの形式で呼び出せるようにするOSSのライブラリ兼プロキシです。アプリに組み込むSDKとしても使えますが、社内でまとめて効くのはプロキシとして立てる使い方で、提供元のAPIキーをゲートウェイだけに置き、利用者には権限と予算を絞った「仮想キー」を配れます。
ここでは、Docker ComposeでLiteLLMプロキシとPostgreSQLを立て、クラウドのモデルとOllama上のローカルモデルを同じエンドポイントに並べ、部署ごとの仮想キー、フォールバック、ログの扱いまでを設定します。確認に使ったのはLiteLLM 1.102.1(main-stable イメージ)とOllama 0.34.3で、ローカル側はCPUだけで動く qwen2.5:0.5b です。エラーメッセージはすべてこの環境で実際に出たものです。
この記事でわかること
- LiteLLMのSDKとプロキシの違いと、ゲートウェイとして置くときの判断基準
config.yamlのmodel_list・router_settings・general_settingsの書き方- 部署ごとに使えるモデル・予算・毎分リクエスト数を絞る仮想キーの発行手順
- フォールバックがキーのモデル制限をすり抜ける既定動作と、その止め方
- 認証エラー・タイムアウト・接続拒否など実際のエラー文と対処
LiteLLMとは:SDKとプロキシの2つの使い方
入口は2つあります。1つはPythonの litellm.completion() をアプリから直接呼ぶSDKで、model="anthropic/claude-haiku-4-5" のように「提供元/モデル名」を渡すと、内部で各社のAPI形式に変換して結果をOpenAI形式で返します。もう1つが litellm --config config.yaml で起動するプロキシで、/v1/chat/completions や /v1/models といったOpenAI互換のHTTPエンドポイントを提供し、その裏で同じ変換を行います。
import litellm

resp = litellm.completion(
    model="ollama_chat/qwen2.5:0.5b",
    api_base="http://127.0.0.1:11434",
    messages=[{"role": "user", "content": "「障害」を英語で一語で。"}],
    max_tokens=8,
)
print(resp.choices[0].message.content)
判断基準は単純です。アプリが1つで、APIキーもそのアプリの持ち主が管理するならSDKで足ります。複数のアプリや部署が同じLLMを使う、キーを利用者に渡したくない、誰がいくら使ったかを残したい、のどれかに当てはまったらプロキシを立てます。プロキシにするとクライアント側はOpenAIの公式SDKや、OpenAI互換APIに対応した既存ツールをそのまま向けられるため、LiteLLMへの依存がアプリのコードに入りません。
社内LLMゲートウェイを置くと何が変わるか
ゲートウェイの価値は、個々のアプリで散らばっていた判断を1か所に寄せられることです。導入前後で変わる点を表にまとめます。
| 項目 | 各アプリが直接APIを呼ぶ場合 | LiteLLMプロキシを経由する場合 |
|---|---|---|
| 提供元のAPIキー | アプリの数だけ .env や設定画面に置かれる | ゲートウェイの環境変数だけ。利用者には仮想キーを配る |
| 使えるモデルの制御 | 提供元の管理画面でプロジェクトを分けるしかない | 仮想キーごとに models で許可リストを持つ |
| 費用の把握 | 提供元の請求を後から按分する | キー・チーム単位で spend が記録され、max_budget で止められる |
| モデルの切り替え | 各アプリのコードや設定を直す | config.yaml の model_name の裏側だけを差し替える |
| 障害時の迂回 | アプリごとにリトライ処理を書く | fallbacks で別のモデルに自動で回す |
逆に、利用者が数人で使うモデルも1つだけなら、ゲートウェイは運用対象が増えるだけです。PostgreSQL、プロキシ本体、設定ファイルの3つを更新し続ける手間と、ゲートウェイが止まると全アプリが止まる単一障害点になる点を天秤にかけてください。
構成と準備:compose.yamlと.env
仮想キーや利用記録はPostgreSQLに保存されるため、プロキシとDBの2コンテナ構成にします。ポートは 127.0.0.1 にだけ公開し、社内に出すときは前段のリバースプロキシでTLSを終端します。
services:
  litellm:
    image: ghcr.io/berriai/litellm:main-stable  # 本番はバージョンタグかダイジェストで固定する
    command: ["--config", "/app/config.yaml", "--port", "4000"]
    ports:
      - "127.0.0.1:4000:4000"
    volumes:
      - ./config.yaml:/app/config.yaml:ro
    env_file: .env
    environment:
      DATABASE_URL: postgresql://litellm:${POSTGRES_PASSWORD}@db:5432/litellm
    depends_on:
      db:
        condition: service_healthy
    restart: unless-stopped

  db:
    image: postgres:16-alpine
    environment:
      POSTGRES_USER: litellm
      POSTGRES_PASSWORD: ${POSTGRES_PASSWORD}
      POSTGRES_DB: litellm
    volumes:
      - pgdata:/var/lib/postgresql/data
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U litellm"]
      interval: 5s
      retries: 10
    restart: unless-stopped

volumes:
  pgdata:
.env には秘密情報だけを置きます。LITELLM_MASTER_KEY は管理APIを含むすべての操作ができる鍵で、LITELLM_SALT_KEY はDBに保存する認証情報の暗号化に使われます。ソースを確認すると、ソルトキーを設定しない場合はマスターキーが暗号化に流用されます。その状態でマスターキーを交換すると、それまでにDBへ保存した認証情報を復号できなくなるので、最初から別の値を入れておきます。
cat > .env <<EOF
LITELLM_MASTER_KEY=sk-$(openssl rand -hex 24)
LITELLM_SALT_KEY=sk-$(openssl rand -hex 24)
POSTGRES_PASSWORD=$(openssl rand -hex 16)
OPENAI_API_KEY=(OpenAIのキー)
ANTHROPIC_API_KEY=(Anthropicのキー)
EOF
chmod 600 .env
LITELLM_SALT_KEY は一度決めたら変更しない値です。マスターキーと一緒にパスワード管理ツールへ保管し、.env をGitに入れないよう .gitignore に追加してください。管理画面(/ui)のログインも、UI_PASSWORD を設定しなければマスターキーがパスワード代わりになります。
config.yamlでモデルを登録する
model_list の各要素は、利用者が指定する名前(model_name)と、その裏で実際に呼ぶ先(litellm_params)の対応表です。クライアントには local-small や claude-haiku という社内向けの名前だけを見せ、提供元のモデルIDはここに閉じ込めます。モデルIDは執筆時点の例なので、各社の一覧で現行の名前を確認してください。
model_list:
  - model_name: local-small            # 社内のOllama(CPU)上の小型モデル
    litellm_params:
      model: ollama_chat/qwen2.5:0.5b
      api_base: http://ollama.internal:11434
      timeout: 300                     # CPU推論は遅いので個別に延ばす
  - model_name: gpt-5-mini
    litellm_params:
      model: openai/gpt-5-mini
      api_key: os.environ/OPENAI_API_KEY
  - model_name: claude-haiku
    litellm_params:
      model: anthropic/claude-haiku-4-5
      api_key: os.environ/ANTHROPIC_API_KEY

router_settings:
  num_retries: 1
  timeout: 120
  fallbacks:
    - claude-haiku: ["gpt-5-mini"]

litellm_settings:
  drop_params: true

general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
  database_url: os.environ/DATABASE_URL
enforce_fallback_model_access: trueollama_chat/はOllamaの/api/chatを使う接頭辞です。api_baseはLiteLLMコンテナから見たアドレスで、同じホストのOllamaでもlocalhostでは届きません(後述)os.environ/変数名と書くと、起動時に環境変数から値を読みます。キーを設定ファイルに直書きしないための書式ですdrop_params: trueは、提供元が対応していないパラメータ(あるモデルにないtemperature指定など)をエラーにせず捨てます。クライアントを提供元ごとに書き分けずに済みます- Amazon Bedrockを並べる場合は
modelにbedrock/接頭辞を付け、リージョンはaws_region_nameで指定します。認証はIAMロールか、AWS_ACCESS_KEY_IDなどの環境変数で渡します
同じ model_name を複数の litellm_params に付けると、1つの名前の裏に複数のデプロイ先を置いた負荷分散になります。GPUサーバーを2台並べたときや、同じモデルを複数リージョンで契約しているときに使えます。
起動して1つのAPIで呼び出す
docker compose up -d
curl -s http://127.0.0.1:4000/health/readiness
# 期待: {"status":"healthy","db":"connected"}

source .env
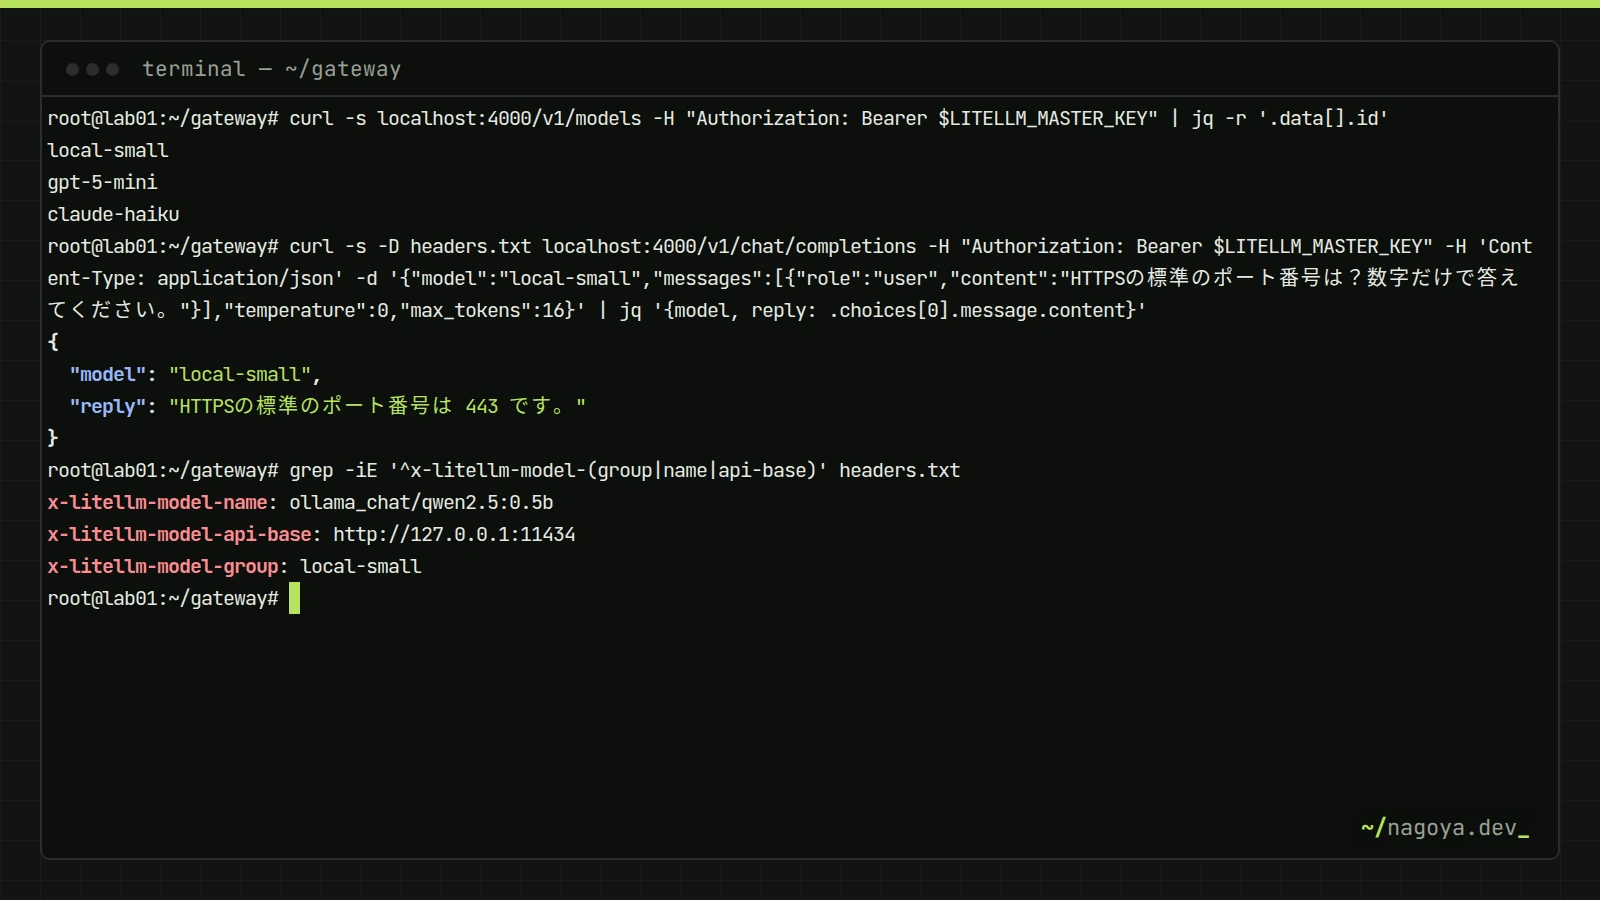
curl -s http://127.0.0.1:4000/v1/models \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" | jq -r '.data[].id'
# local-small / gpt-5-mini / claude-haiku が並ぶ
呼び出しはOpenAIのChat Completions形式そのままです。model に社内向けの名前を入れれば、裏の提供元がOllamaでもAnthropicでも、返ってくるJSONの形は変わりません。
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:4000", api_key="sk-...")  # 仮想キー
resp = client.chat.completions.create(
    model="local-small",
    messages=[{"role": "user", "content": "「障害」を英語で一語で。"}],
    max_tokens=16,
)
print(resp.model, resp.choices[0].message.content)レスポンスヘッダーには、どのデプロイ先が実際に応答したかが出ます。x-litellm-model-group が応答したモデル名、x-litellm-model-api-base が呼んだ先、x-litellm-response-cost がこのリクエストの推定費用です。ローカルモデルは単価が登録されていないため費用は0と記録されます。問い合わせ対応で「どのモデルが答えたのか」を調べるときは、まずこのヘッダーを見ます。
仮想キーで部署ごとに予算とモデルを制限する
仮想キーはマスターキーで /key/generate を呼んで発行します。次の例は、総務部向けに local-small だけを許可し、30日ごとに5ドルまで、毎分2リクエストまでに絞ったキーです。metadata に入れた値は利用記録と一緒に残るので、部署名や申請番号を入れておくと棚卸しが楽になります。
curl -s http://127.0.0.1:4000/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"models": ["local-small"], "max_budget": 5, "budget_duration": "30d",
       "rpm_limit": 2, "key_alias": "team-soumu",
       "metadata": {"team": "総務部", "ticket": "REQ-0123"}}' | jq -r .key
このキーで /v1/models を呼ぶと local-small しか返らず、許可していないモデルを指定すると403で止まります。実際のエラーは次のとおりで、どのモデルなら使えるかまで返してくれるので、利用者からの問い合わせにそのまま答えられます。
{"error":{"message":"key not allowed to access model. This key can only access models=['local-small']. Tried to access gpt-5-mini","type":"key_model_access_denied","param":"model","code":"403"}}使った金額と次のリセット日時は /key/info?key=sk-... で確認できます。毎分の上限を超えたリクエストは拒否されるため、夜間バッチのような大量処理には別のキーを発行し、rpm_limit を分けておくと、昼間の対話利用を巻き込みません。
フォールバックと、その落とし穴
router_settings.fallbacks は「このモデルが失敗したら次はこれ」という迂回先の指定です。動作を確かめるため、到達できないアドレス(http://127.0.0.1:9/v1)を指す flaky というモデルを作り、local-small へのフォールバックを設定して呼んだところ、応答は local-small から返り、ヘッダーに次の2行が付きました。
x-litellm-model-group: local-small
x-litellm-attempted-fallbacks: 1問題は、models: ["flaky"] だけを許可した仮想キーで呼んでも、同じように local-small が応答したことです。既定ではフォールバック先がキーの許可リストにあるかを確認しません。社内モデルが落ちたら外部APIへ逃がす設定にしていると、「社外に出さない」前提で配ったキーのデータが外部の提供元へ流れます。general_settings に enforce_fallback_model_access: true を入れて再起動すると、同じリクエストは元のモデルのエラー(OpenAIException - Connection error.)を返して止まりました。
フォールバックは「内部モデル同士」か「外部モデル同士」で組み、内部から外部へまたがる迂回は作らないのが安全です。どうしても必要なら enforce_fallback_model_access: true を必ず入れ、外部送信を許可したキーにだけ外部モデルを許可リストで渡してください。
運用とセキュリティ:鍵・ログ・更新
ゲートウェイは全提供元のAPIキーを抱えるため、侵害されたときの被害が大きい場所です。設定で押さえる点は次のとおりです。
- 公開範囲:
127.0.0.1待ち受け+リバースプロキシでTLSと社内ネットワーク制限をかける。管理画面/uiと/key/*はVPN内や管理者の端末からだけ届くよう、パスでアクセス元を絞る - APIドキュメント:Swagger UIを外から見せる理由はないので、環境変数
NO_DOCS=TrueとNO_REDOC=Trueで無効にする - プロンプトの保存:利用記録(spend logs)にプロンプト本文を保存する
store_prompts_in_spend_logsは既定で無効。今回の環境でも記録のmessagesは空だった。監査で本文が必要な場合だけ有効にし、保存期間と閲覧者を決める - 外部送信:LangfuseなどのログツールへのcallbackにはLLMへの入力がそのまま送られる。
litellm_settings.turn_off_message_logging: trueで本文を送らない設定にできる
更新方針も決めておきます。リリースは数日おきに出ており、PyPIで配布された版に不正なコードが混入したサプライチェーン侵害も報告されています(該当版は削除済み。影響範囲は公式のセキュリティ告知で確認してください)。main-stable のような動くタグを本番で追従させず、検証した版のタグかイメージのダイジェスト(@sha256:...)で固定し、pipで入れる場合は pip install "litellm[proxy]==1.102.1" のように版を固定したうえでハッシュ検証(--require-hashes)を使います。更新は検証環境で /v1/models と代表的なリクエストを流してから本番に反映します。
動作確認
構築後に次の4点を確認します。すべて期待どおりなら、社内から使い始めて問題ありません。
# 1. DB接続を含むヘルスチェック
curl -s http://127.0.0.1:4000/health/readiness
# 期待: {"status":"healthy","db":"connected"}

# 2. キーなしは拒否される
curl -s http://127.0.0.1:4000/v1/models
# 期待: "Authentication Error, No api key passed in." と code 401
# (DBをつながずに試した構成では、同じリクエストが "Internal server error" になった)

# 3. 仮想キーでは許可したモデルだけが見える
curl -s http://127.0.0.1:4000/v1/models -H "Authorization: Bearer $TEAM_KEY" | jq -r '.data[].id'
# 期待: local-small のみ

# 4. 実際に応答したデプロイ先をヘッダーで確認
curl -si http://127.0.0.1:4000/v1/chat/completions \
  -H "Authorization: Bearer $TEAM_KEY" -H "Content-Type: application/json" \
  -d '{"model":"local-small","messages":[{"role":"user","content":"ping"}],"max_tokens":4}' \
  | grep -i '^x-litellm-model-group'
# 期待: x-litellm-model-group: local-small
つまずきポイント
Authentication Error, Invalid proxy server token passed
実際のメッセージは Authentication Error, Invalid proxy server token passed. ... Unable to find token in cache or LiteLLM_VerificationTokenTable` で、渡したキーがDBに存在しないことを示します。多いのは、DBを作り直して発行済みキーが消えたケースと、.env を書き換えてマスターキーが変わったのに古い値で呼んでいるケースです。docker compose exec litellm env | grep MASTER で実際に読み込まれている値を確認し、仮想キーは /key/info` で存在を確かめます。
litellm.Timeout: Ollama_chatException ... Timeout passed=120.0
CPUで動くローカルモデルが、他のリクエストの後ろで順番待ちになったときに出ました。Ollama 0.34.3の既定は OLLAMA_NUM_PARALLEL=1(起動ログに表示されます)で、1つのモデルへのリクエストを1本ずつ処理するため、長い生成が1本走ると後続が待たされます。ローカルモデルのデプロイ先にだけ timeout: 300 を付け、クライアント側でも max_tokens を指定して、終わらない生成を作らないようにします。恒常的に出るなら、GPUのあるサーバーへ移すか、同じ model_name でOllamaを2台並べて負荷分散します。
同じホストのOllamaにつながらない(Connection refused)
api_base: http://localhost:11434 と書くと、LiteLLMコンテナ自身の11434番を見に行くため接続は拒否されます。Ollamaもコンテナなら同じComposeネットワークに入れてサービス名で指定します。ホストに直接入れたOllamaを使う場合は、extra_hosts: ["host.docker.internal:host-gateway"] を付けて http://host.docker.internal:11434 を指定し、Ollama側は OLLAMA_HOST をDockerブリッジのアドレスで待ち受けさせます。Ollamaには認証がないので、0.0.0.0 で全インターフェースに開く場合はファイアウォールで11434番をLiteLLMのホストからだけに絞ってください。
key not allowed to access model
仮想キーの models に入っていないモデル名を指定したときのエラーです。クライアントが gpt-5-mini のように提供元の名前を直接書いている場合もこれになります。LiteLLM経由では config.yaml の model_name(社内向けの名前)を指定する、という約束を利用者向けの手順書に書いておくと問い合わせが減ります。
よくある質問
LiteLLMとは何ですか?
提供元ごとに異なるLLMのAPIを、OpenAI互換の1つの形式で呼び出せるようにするOSSです。Pythonから直接使うSDKと、HTTPのゲートウェイとして動くプロキシがあり、社内で複数のアプリや部署が使う場合はプロキシにしてAPIキー・予算・ログを集中管理するのが向いています。
LiteLLMプロキシとは何ですか?
litellm --config config.yaml で起動するサーバーで、/v1/chat/completions などOpenAI互換のエンドポイントを提供し、裏で各提供元へ変換して転送します。PostgreSQLをつなぐと、モデル・予算・毎分リクエスト数を絞った仮想キーの発行や、キー単位の利用額の記録ができます。
無料のOSS版でどこまで使えますか?
本体はオープンソースで、この記事で使ったプロキシ、仮想キー、予算、フォールバックはライセンス費用なしで動作しました。一部の管理機能はEnterprise版の対象になっているため、どの機能が該当するかは執筆時点の公式情報で確認してください。別途かかるのは各提供元のAPI利用料とサーバー費用です。
脆弱性やサプライチェーン侵害にはどう備えればよいですか?
動くタグを追従させず、検証済みの版をタグかダイジェストで固定し、pipならハッシュ検証を使います。ゲートウェイは全APIキーを持つので、管理APIを社内の管理端末からだけ届く位置に置き、GitHubのセキュリティ告知を購読して更新判断を検証環境で行う運用にしてください。
まとめ
社内に置くならプロキシ構成にして、提供元のAPIキーはゲートウェイだけが持ち、利用者には models・max_budget・rpm_limit で絞った仮想キーを配ります。フォールバックは既定でキーの許可リストを確認しないため、enforce_fallback_model_access: true を入れ、内部から外部へまたがる迂回は作らないでください。版は固定し、ソルトキーは最初に決めて変えない、の2点が運用の要です。
次に読む
- Ollamaで始めるローカルLLM入門:ゲートウェイの裏に置くローカルモデルの準備と、11434番を安全に公開する構成
- OllamaのPythonライブラリとModelfileで社内向けLLMツールを作る:ゲートウェイの先で動かす社内ツールの作り方
- 生成AIのセキュリティリスクと対策:ゲートウェイで防げるリスクと防げないリスクの整理